구글, 온디바이스 모델 ‘EmbeddingGemma 2’ 공개
최근 30일 조회수 — 좋아요 —핵심 요약
텍스트·이미지·영상·음성을 하나의 벡터 공간에서 비교해 빠르고 안전한 로컬 검색을 지원한다.
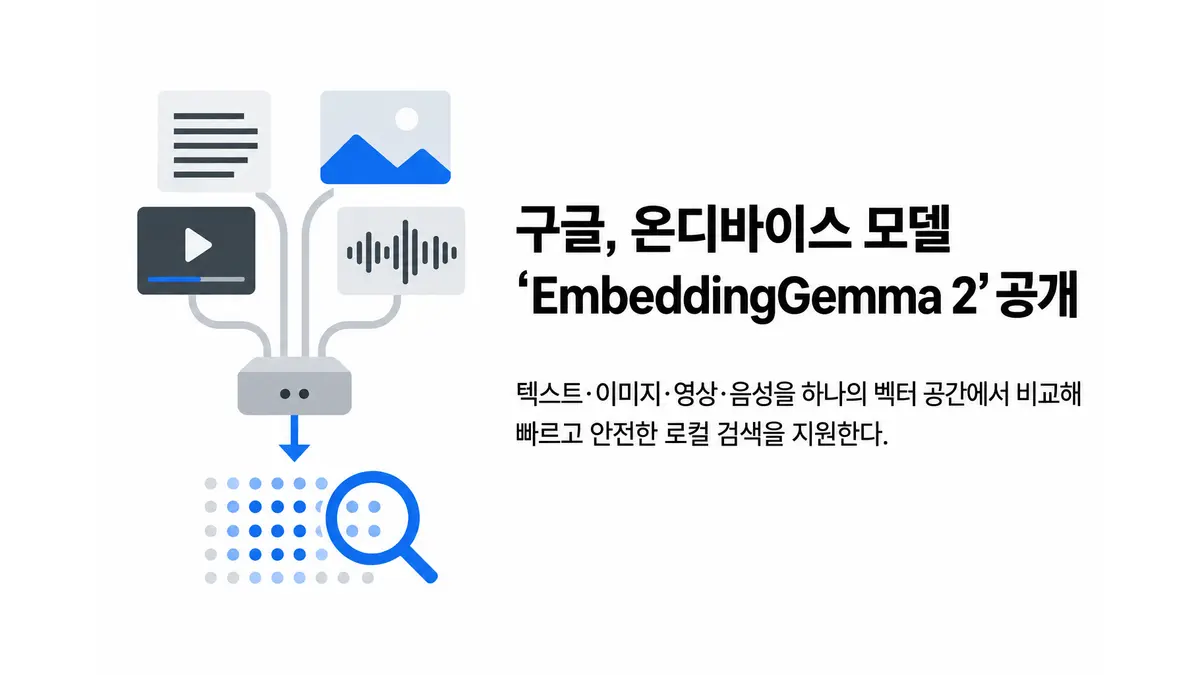
구글 딥마인드(Google DeepMind)가 텍스트·이미지·비디오 프레임·음성을 하나의 벡터 공간에 담는 오픈 웨이트 온디바이스 모델 ‘EmbeddingGemma 2’를 공개했다. 서로 다른 형식의 콘텐츠를 의미에 따라 직접 비교할 수 있어, 이미지 설명 생성과 음성 인식, 텍스트 임베딩 모델을 차례로 실행할 필요가 없다는 것이 구글의 설명이다. 검색 지연과 메모리 부담을 줄이는 동시에 민감한 데이터를 기기 밖으로 보내지 않는 로컬 검색을 겨냥했다.1
EmbeddingGemma 2는 7억4천만 개 매개변수로 텍스트와 시각·음성 정보를 처리한다. 인코더를 모듈식으로 구성해 필요한 기능만 실행할 수 있으며, 구글이 픽셀 11 프로에서 측정한 활성 메모리 사용량은 텍스트 전용 가중치가 약 191MB, 전체 멀티모달 모델이 약 567MB다. 이용자의 입력과 분류용 레이블·설명을 곧바로 대조하는 제로샷 의도 분류도 지원한다. 별도 학습 데이터나 미세조정 없이 수 밀리초 안에 요청을 분기할 수 있다는 게 구글의 주장이다.1
중간 변환 없이 미디어를 찾는다
구글은 활용 사례로 ‘Instant Media Search’와 ‘Video Moments Finder’를 AI Edge Gallery 앱에 추가했다. Instant Media Search는 자연어나 예시 이미지로 기기 안의 사진과 동영상을 찾는다. 질의와 미디어를 각각 임베딩 벡터로 바꾸고, 미디어 벡터는 로컬 SQLite 데이터베이스에 저장한다. 이후 코사인 유사도가 큰 항목을 돌려주기 때문에 사용자가 입력하는 동안 결과를 갱신할 수 있다.
Video Moments Finder는 로컬 동영상에서 특정 장면을 찾는 기능이다. 음성을 받아쓰거나 영상 설명문을 먼저 만들지 않고도 텍스트 질의와 시각 장면을 같은 공간에서 비교한다. 여러 단계를 잇던 기존 처리 흐름을 단일 임베딩 모델로 줄였다는 점이 EmbeddingGemma 2의 핵심이다.
맥용 실험 앱 ‘Google AI Edge Foresight’에도 EmbeddingGemma 2와 Gemma 4가 쓰인다. 시스템 음성과 마이크를 받아 회의 기록을 작성·색인하고, 대화 내용과 개인 파일을 오프라인으로 검색한다. 다만 공개 자료에 나온 메모리 수치는 픽셀 11 프로 기준이며, 다른 기기의 성능 수치는 제시되지 않았다. 안드로이드용 ML Kit 서비스와 신경망처리장치(NPU) 가속은 향후 몇 주 안에 제공할 계획이다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Bring multimodal semantic search to the edge with EmbeddingGemma 2 — Google Developers Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.