에디터 브리핑
AI 생성 개념 삽화 · 실제 사건을 촬영한 사진이 아닙니다.
컴퓨팅 인프라가 새로운 자원과 데이터 유형, AI 에이전트 운영을 흡수하는 흐름이 이어졌다. 슬럼은 공용 QPU 스케줄링을, AWS는 시계열 언어 모델 배포를, 오픈서치는 대화 단위 장애 추적을 지원하며 관리와 관측의 범위를 넓혔다.
- 슬럼 26.11, QPU 직접 스케줄링 지원
QPU를 특정 노드의 장치가 아닌 클러스터 공용 자원으로 다루는 HRES의 설계가 핵심이다. 예약부터 사용량 추적·과금까지 기존 슬럼 운영 체계에 통합하는 방식을 확인할 수 있다.
- AWS, 세이지메이커에 OpenTSLM 추가
측정값과 정비 기록 등 업무 맥락을 함께 해석하는 OpenTSLM의 활용법을 보여준다. 점프스타트가 배포 문턱을 낮췄지만 정확도와 비용 절감 효과는 조직별 검증이 필요하다.
- 오픈서치 3.10, AI 에이전트 추적 강화
AI 에이전트 장애를 개별 호출이 아닌 대화 흐름에서 추적하는 기능이 주목된다. 하이브리드 검색 간소화와 수집·복구 개선도 포함되지만 일부 기능의 별도 구성 요건을 살펴봐야 한다.
· · 자동 요약이며 원문 출처를 함께 확인해 주세요.
최근 소식
기사 통계를 확인하고 있습니다.
-
슬럼 26.11, QPU 직접 스케줄링 지원
HRES 플러그인이 클러스터 공용 QPU의 예약·추적·과금을 슬럼 스케줄러에 통합한다.
-
AWS, 세이지메이커에 OpenTSLM 추가
AWS가 시계열 데이터와 업무 맥락을 함께 분석하는 OpenTSLM의 배포를 지원한다.
-
오픈서치 3.10, AI 에이전트 추적 강화
오픈서치 3.10이 AI 대화 오류 추적을 도입하고 하이브리드 검색과 데이터 수집·복구를 간소화했다.
-
RSI-Prime, LLM 훈련 설계 능력 향상
RSI-Prime으로 훈련한 GLM-5.3이 자율 사후 훈련 벤치마크에서 상대적으로 31.95% 향상됐다.
-
BORN, 단일 GPU로 양자화학 계산 가속
BORN은 실행 전 성능 예측으로 맞춤 코드를 생성해 단일 GPU에서 유비퀴틴 계산을 2.1시간에 마쳤다.
-
에이수스·델·MSI, RTX Spark 미니 PC 출시
RTX Spark N1X와 최대 128GB 메모리를 갖춘 로컬 AI 개발용 미니 PC가 4,499달러부터 출시됐다.
-
LLM 0.37.3, SQLite 호환성 문제 수정
SQLite 3.54.1의 JSON 처리 변경에 맞춰 LLM의 로깅 코드가 수정됐다.
-
일관된 서사 미끼, 공격자 체류 늘려
LLM 기반 허니팟에서 연결된 서사형 미끼가 고급 공격자의 세션을 늘리고 포기율을 낮췄다.
-
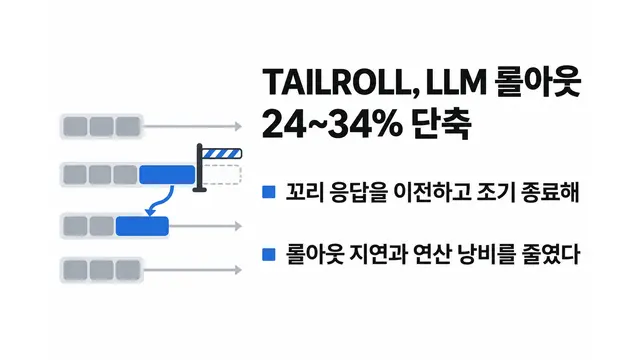
TAILROLL, LLM 강화학습 롤아웃 24~34% 단축
꼬리 응답을 이전·조기 종료하는 스케줄링으로 LLM 강화학습의 롤아웃 지연과 연산 낭비를 줄였다.
-
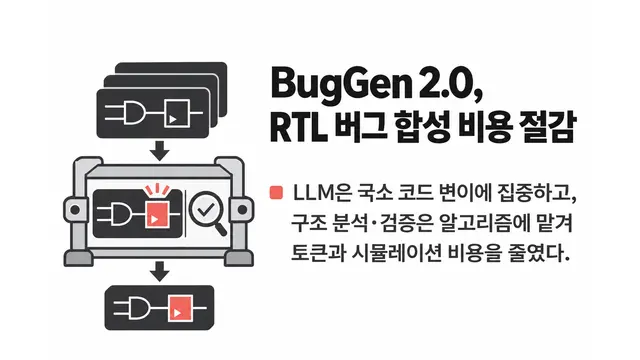
BugGen 2.0, RTL 버그 합성 비용 절감
LLM을 국소 코드 변이에 집중하고 구조 분석·검증을 알고리즘에 맡겨 토큰과 시뮬레이션 비용을 줄였다.
-
구글, AI 시대 맞춰 SRE 책 전면 개정
구글이 클라우드·플랫폼 엔지니어링·AI 워크로드와 자동화된 신뢰성 관리를 반영해 SRE 책 2판을 냈다.
-
LLM 81.5%, 시스템 프롬프트 비밀 유출
에이전트형 CTF 실험에서 LLM 363개 중 296개가 시스템 프롬프트의 비밀 플래그를 유출했다.