GPU / GPU 비용 / GPU 라우팅 / GPU 분할 / GPU 클러스터 / GPU 스케줄링 / GPU 커널 / GPU 공유 / GPU 통신 / 다중 GPU / GPU 보안
63건
기사 통계를 확인하고 있습니다.
-
AWS, 세이지메이커 하이퍼팟 관측·관리 강화
AWS가 대규모 GPU 학습 장애 진단과 Slurm 노드 설정을 자동 관리하는 하이퍼팟 기능을 추가했다.
-
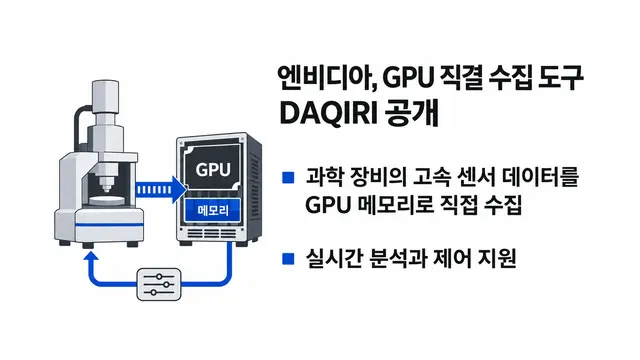
엔비디아, GPU 직결 수집 도구 DAQIRI 공개
DAQIRI는 과학 장비의 고속 센서 데이터를 GPU 메모리로 직접 받아 실시간 분석과 제어를 지원한다.
-
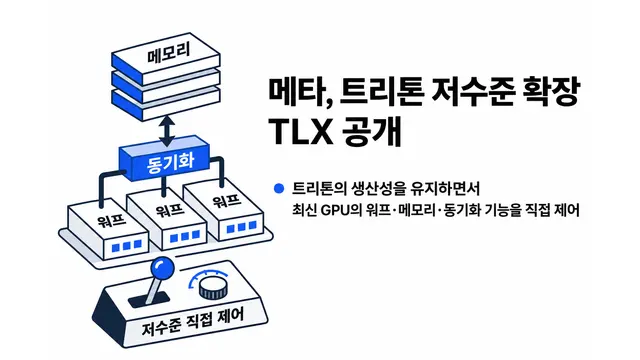
메타, 트리톤 저수준 확장 TLX 공개
TLX는 트리톤의 생산성을 유지하면서 최신 GPU의 워프·메모리·동기화 기능을 직접 제어한다.
-
AWS, 세이지메이커 추론 엔드포인트 자동 점검
세이지메이커 AI가 지연 변화와 유휴 GPU, 누락된 최적화를 자동 탐지해 개선 방안을 안내한다.
-
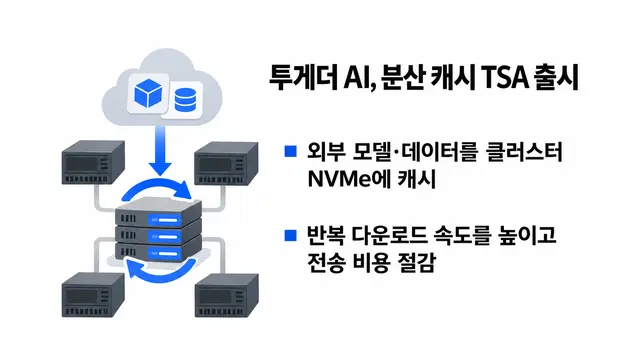
투게더 AI, GPU 분산 캐시 TSA 출시
외부 모델·데이터를 클러스터 NVMe에 캐시해 반복 다운로드 속도와 전송 비용을 줄인다.
-
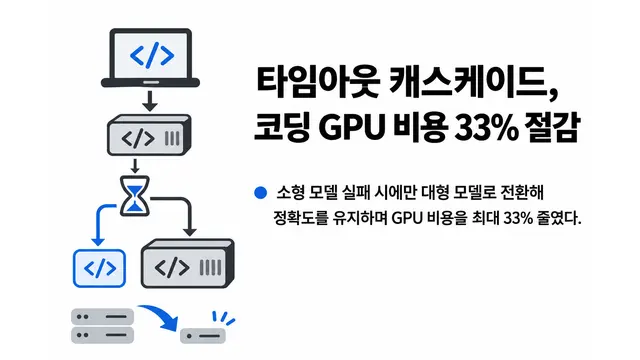
타임아웃 캐스케이드, 코딩 GPU 비용 33% 절감
소형 모델이 실패할 때만 대형 모델로 전환해 정확도를 유지하며 코딩 에이전트의 GPU 비용을 최대 33% 줄였다.
-
SFT 완료 시간 예측, FLOP 방식 능가
Dharma AI의 CatBoost 모델이 H200 기반 SFT 작업 완료 시간을 R² 0.98, MAE 1.71시간으로 예측했다.
-
AWS 람다 관리형 인스턴스, GPU 지원
AWS가 LMI에 EC2 G 계열 GPU를 추가해 이벤트 기반 추론·미디어 처리를 서버리스로 지원한다.
-
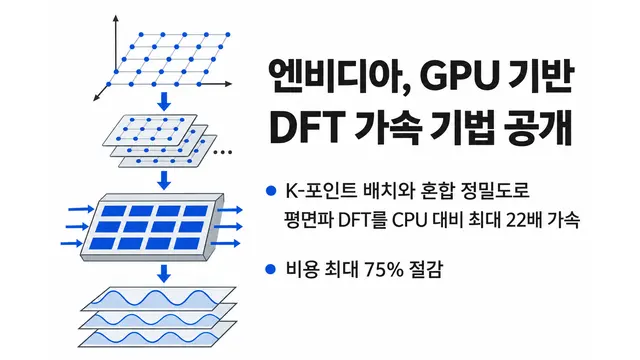
엔비디아, GPU 기반 DFT 가속 기법 공개
K-포인트 배치와 혼합 정밀도로 평면파 DFT를 CPU 대비 최대 22배 가속하고 비용을 최대 75% 낮췄다.
-
BORN, 단일 GPU로 양자화학 계산 가속
BORN은 실행 전 성능 예측으로 맞춤 코드를 생성해 단일 GPU에서 유비퀴틴 계산을 2.1시간에 마쳤다.
-
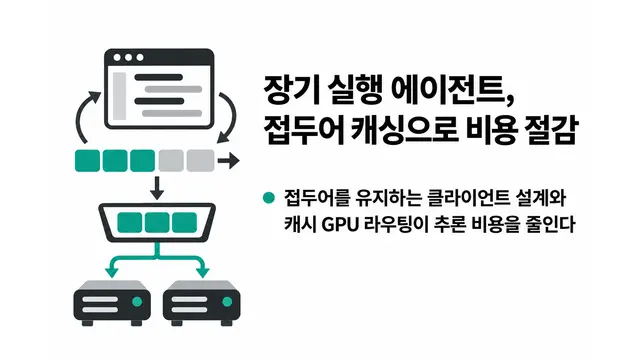
장기 실행 에이전트 비용 줄이는 접두어 캐싱
접두어를 유지하는 클라이언트 설계와 캐시 GPU 라우팅이 장기 실행 에이전트의 추론 비용을 줄인다.
-
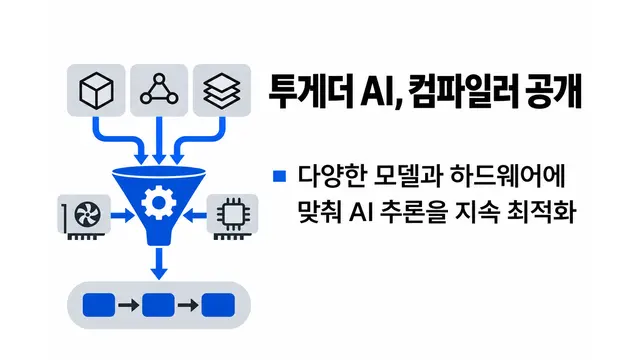
투게더 AI, 메가커널 대신 컴파일러 공개
투게더 AI가 다양한 모델과 하드웨어에 맞춰 추론을 지속 최적화하는 컴파일러를 공개했다.
-
엔비디아, 블랙홀 관측 GPU 도구 공개
cuPhoton.xBeam은 EHT의 페타바이트급 전파 데이터를 GPU로 상관 처리해 복소 가시도를 생성한다.
-
엔비디아 투자금으로 GPU 수요 부풀리기 의혹
엔비디아가 투자한 AI·클라우드 업체의 GPU 구매로 수요를 부풀렸다는 의혹이 제기됐으나 구체적 수치는 공개되지 않았다.
-
엔비디아, GPU 복원 도구 스냅샷 공개
초기화된 GPU 워크로드를 재사용해 LLM 추론 시작과 장애 복구 시간을 분에서 초로 단축한다.
-
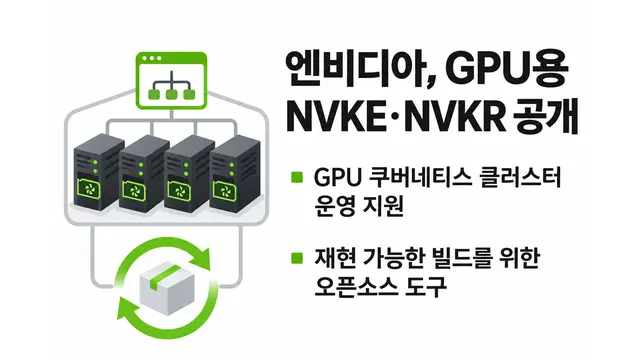
엔비디아, GPU용 NVKE·NVKR 공개
엔비디아가 GPU 쿠버네티스 클러스터 운영과 재현 가능한 빌드를 지원하는 오픈소스 도구를 공개했다.
-
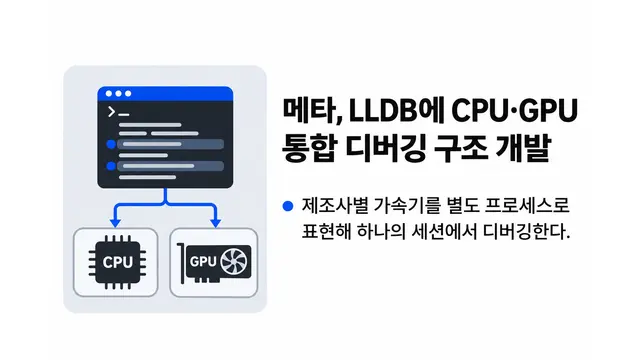
메타, LLDB에 CPU·GPU 통합 디버깅 구조 개발
메타가 제조사별 가속기를 별도 프로세스로 표현하면서 하나의 세션에서 디버깅하는 LLDB 구조를 공개했다.
-
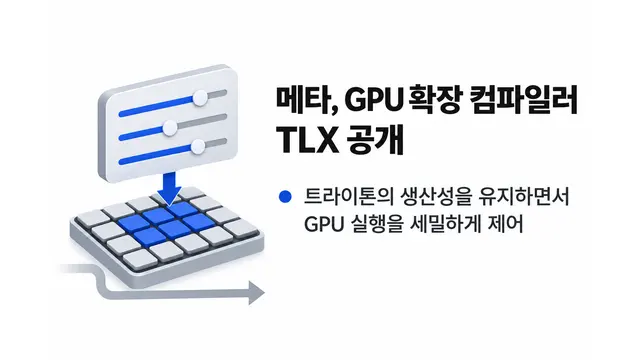
메타, GPU 확장 컴파일러 TLX 공개
메타가 트라이톤의 생산성을 유지하며 GPU 실행을 세밀하게 제어하는 TLX를 공개했다.
-
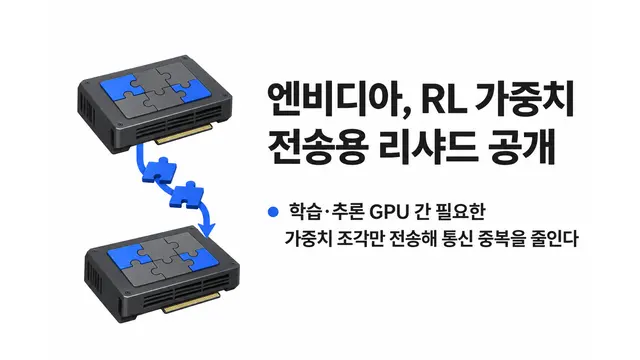
엔비디아, RL 가중치 전송용 리샤드 공개
학습·추론 GPU 간 필요한 가중치 조각만 전송해 RL 후속 훈련의 통신 중복을 줄이는 기술이다.
-
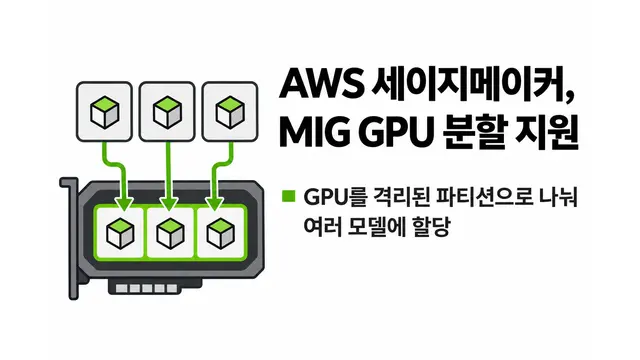
AWS, 세이지메이커에 MIG GPU 분할 지원
세이지메이커 추론이 GPU를 격리된 파티션으로 나눠 여러 모델에 할당하는 기능을 지원한다.
-
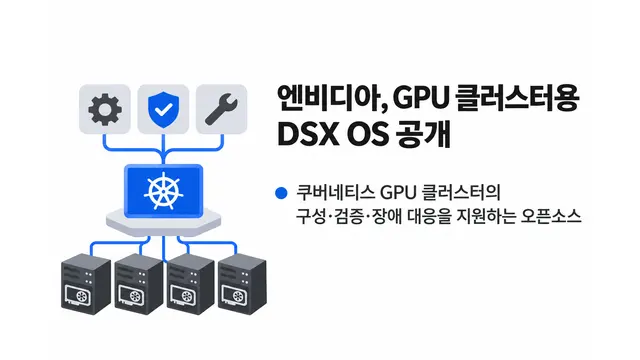
엔비디아, GPU 클러스터용 DSX OS 공개
엔비디아가 쿠버네티스 GPU 클러스터의 구성·검증·장애 대응을 지원하는 오픈소스 DSX OS를 공개했다.
-
AWS 딥러닝 이미지에 우분투 프로 지원
AWS가 우분투 프로 기반 GPU용 DLAMI를 출시해 보안 지원 범위를 넓히고 최대 10년간 업데이트를 제공한다.
-
엔비디아, GPU 장애 진단 AI 에이전트 공개
GPU 클러스터의 계층별 장애 원인을 분석하고 대응책을 제시하는 운영 에이전트를 공개했다.
-
엔비디아, 베라 루빈 지원 CUDA 13.5 출시
베라 루빈을 정식 지원하고 GPU 자원 분할과 MPS 제어·관리 기능을 강화한 CUDA 13.5가 출시됐다.
-
런웨어, 48시간 설치형 AI 데이터센터 추진
런웨어가 모듈식 AI 데이터센터를 48시간 내 가동하고 2028년 하루 30MW 생산하는 계획을 세웠다.
-
넷플릭스, GPU 신뢰성 플랫폼 공개
넷플릭스가 다계층 진단과 자동 복구로 GPU 노드 가용성 99.95%, 작업 성공률 99.5% 이상을 달성했다.
-
스카이파일럿, NVL72 GPU 활용률 27% 개선
랙 내 작업 배치와 자원 조각 모음으로 NVL72의 유휴 GPU를 줄였지만 세부 실험 조건은 공개되지 않았다.
-
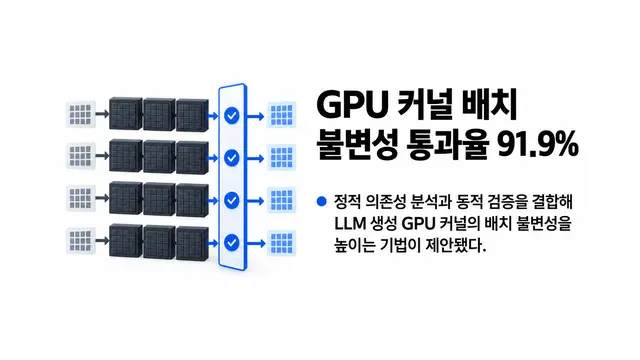
GPU 커널 배치 불변성 통과율 91.9%
정적 의존성 분석과 동적 검증을 결합해 LLM 생성 GPU 커널의 배치 불변성을 높이는 기법이 제안됐다.
-
범용 AI, B200 커널 최적화서 전문가 능가
저스트골은 최소한의 목표와 제약만으로 B200의 다수 연산에서 공개 라이브러리와 전문 에이전트를 앞섰다.
-
CUDA 13.4, 공유 GPU 메모리 제한 지원
엔비디아가 쿠버네티스 공유 GPU에 작업별 메모리 한도를 강제하는 기능과 오픈소스 오퍼레이터를 공개했다.
-
메타 안드로메다 광고 처리량 100배 확대
메타가 모델·검색·GPU를 공동 설계해 초당 10억 개 이상 광고를 평가하고 전환율을 2.4% 높였다.
-
엔비디아, AI 팩토리 운영 플랫폼 공개
미네르바는 분산된 텔레메트리를 지식 그래프로 연결해 장애 원인과 영향을 분석하고 GPU 유휴 시간을 줄인다.
-
엔비디아, GPU 절감 스타트업에 투자
엔비디아가 AI 모델 운영비와 GPU 사용량을 줄이는 인도 스타트업 심플리스마트의 투자에 참여했다.
-
스페이스X, 아폴로와 400억달러 GPU 금융 계약
스페이스X가 아폴로를 통해 차세대 AI 칩과 서버를 약 5년간 임차해 컴퓨팅 인프라를 확충한다.
-
구글, 온디바이스 AI 엔진 ML 드리프트 공개
구글이 다양한 GPU에서 AI 추론을 지원하는 오픈소스 엔진 ML 드리프트를 공개하고 LiteRT 이전을 권고했다.
-
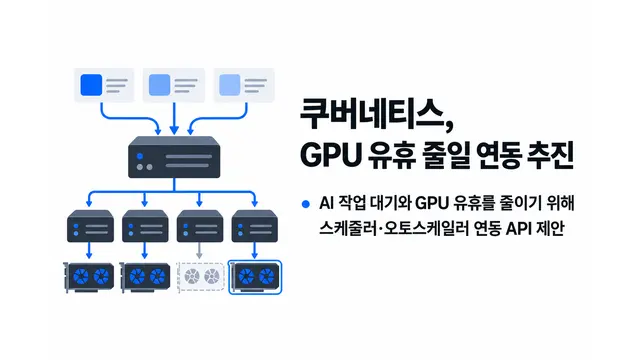
쿠버네티스, GPU 유휴 줄일 연동 추진
쿠버네티스가 AI 작업 대기와 GPU 유휴를 줄이기 위해 스케줄러·오토스케일러 연동 API를 제안했다.
-
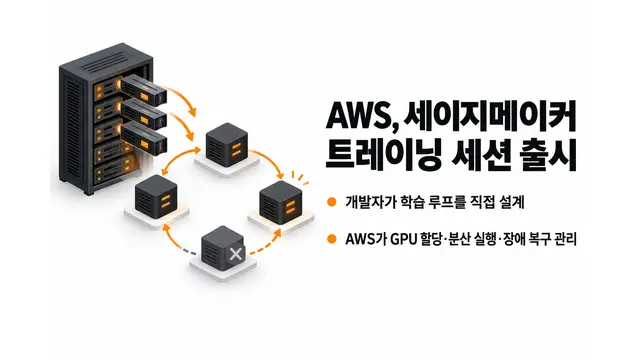
AWS, 세이지메이커 트레이닝 세션 출시
개발자가 학습 루프를 직접 설계하면 AWS가 GPU 할당과 분산 실행, 장애 복구를 관리한다.
-
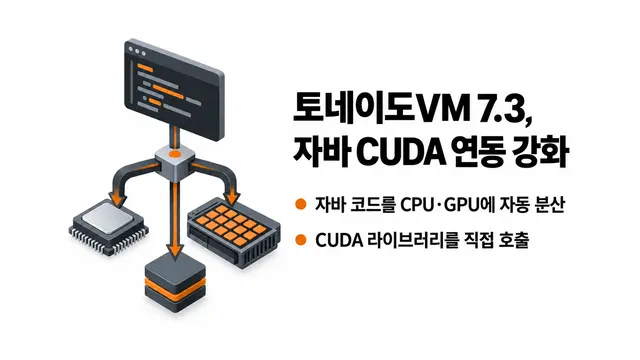
토네이도VM 7.3, 자바 CUDA 연동 강화
자바 코드를 CPU·GPU에 자동 분산하고 CUDA 라이브러리를 직접 호출하는 토네이도VM 7.3이 공개됐다.
-
레이서, GPU 커널 실제 버그 82건 발견
기호 동치 검증 도구 레이서가 프로덕션 GPU 커널 2,408개를 검사해 23개 라이브러리에서 버그 82건을 찾았다.
-
AI 연구소 플래핑 에어플레인스, 10억달러 유치
저데이터·저비용 AI를 내세운 플래핑 에어플레인스가 기업가치 60억달러로 투자받았지만 성능은 아직 검증되지 않았다.
-
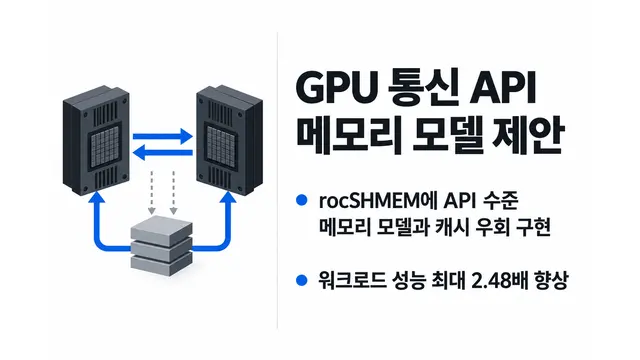
GPU 통신용 API 메모리 모델 제안
rocSHMEM에 API 수준 메모리 모델과 캐시 우회를 구현해 워크로드 성능을 최대 2.48배 높였다.
-
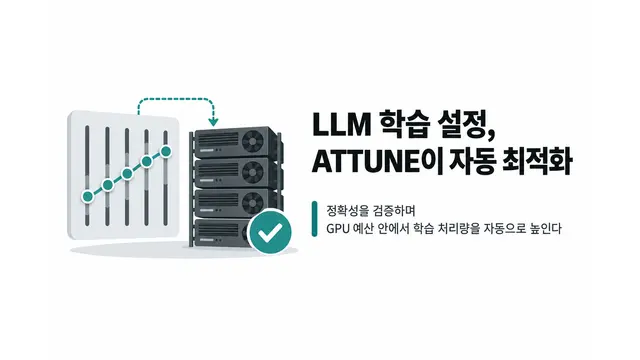
LLM 학습 설정 자동 최적화 ATTUNE 공개
ATTUNE은 정확성을 검증하며 GPU 예산 안에서 LLM 학습 처리량을 자동으로 높인다.
-
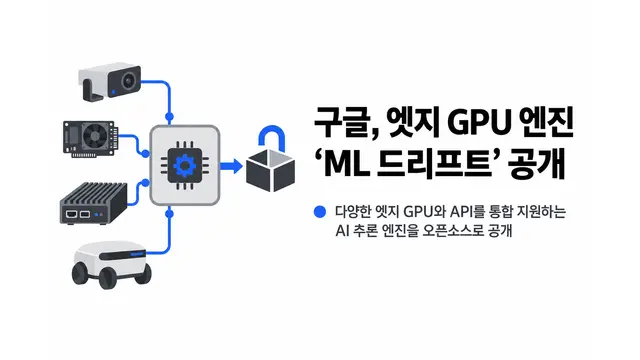
구글, 엣지 GPU 엔진 ML 드리프트 공개
구글이 다양한 엣지 GPU와 API를 통합 지원하는 AI 추론 엔진 ML 드리프트를 오픈소스로 공개했다.
-
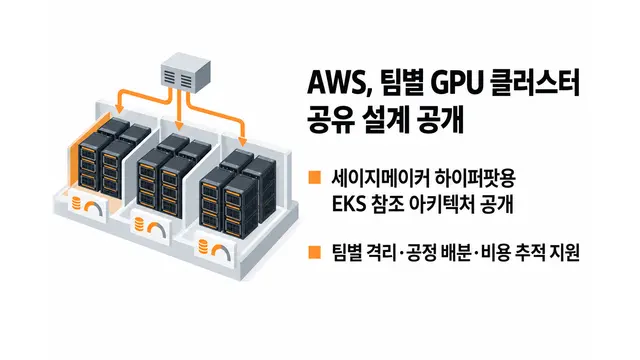
AWS, 팀별 GPU 클러스터 공유 설계 공개
AWS가 세이지메이커 하이퍼팟에서 팀별 격리·공정 배분·비용 추적을 지원하는 EKS 참조 아키텍처를 공개했다.
-
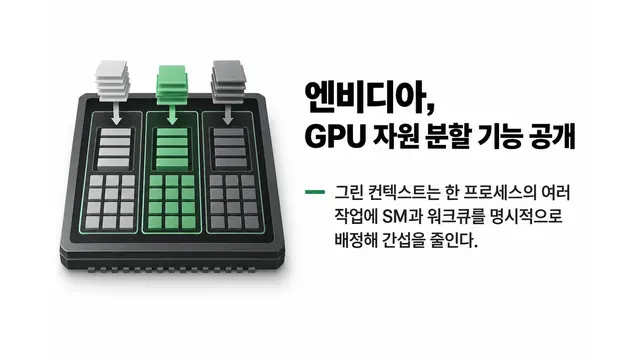
엔비디아, GPU 자원 분할 기능 공개
그린 컨텍스트는 한 프로세스의 여러 작업에 SM과 워크큐를 명시적으로 배정해 간섭을 줄인다.
-
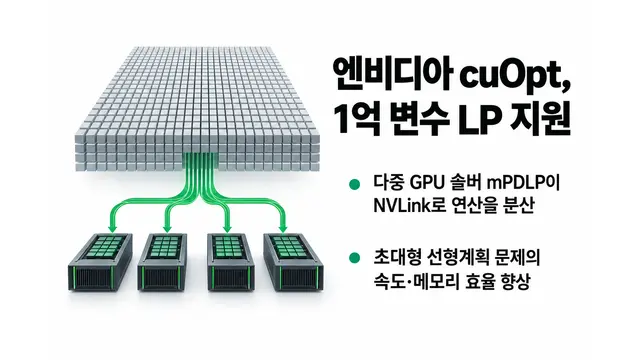
엔비디아 cuOpt, 1억 변수 LP 지원
다중 GPU 솔버 mPDLP이 NVLink로 연산을 분산해 초대형 선형계획 문제의 속도와 메모리 효율을 높였다.
-
엔비디아, GPU 클러스터 검증 체계 AICR 1.0 공개
AICR 1.0은 GPU 쿠버네티스 구성의 호환성을 레시피와 서명된 증거로 검증·재현하는 오픈 체계다.
-
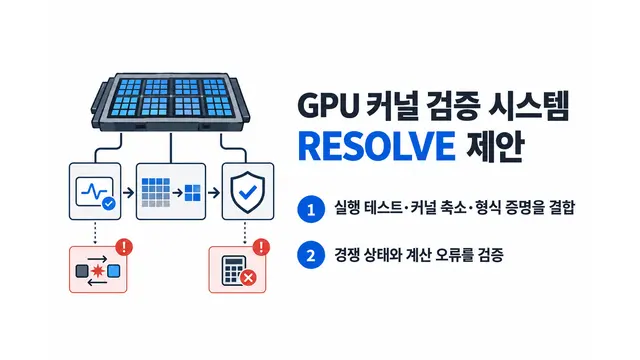
GPU 커널 검증 시스템 RESOLVE 제안
RESOLVE는 실행 테스트와 커널 축소, 형식 증명을 결합해 경쟁 상태와 계산 오류를 검증한다.
-
PyTorch·vLLM, 헬리온 백엔드 통합
헬리온이 선형 연산 알고리즘을 입력별로 자동 튜닝해 호퍼 GPU 일부 작업의 처리량을 10% 이상 높였다.
-
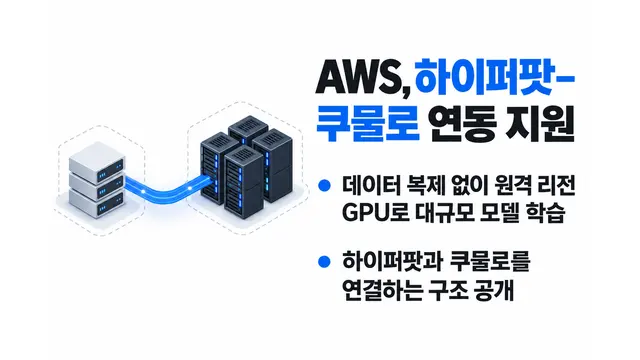
AWS, 세이지메이커 하이퍼팟에 쿠물로 연동 지원 발표
AWS가 데이터 복제 없이 원격 리전 GPU로 대규모 모델을 학습시키는 하이퍼팟-쿠물로 연동 구조를 공개했다.
-
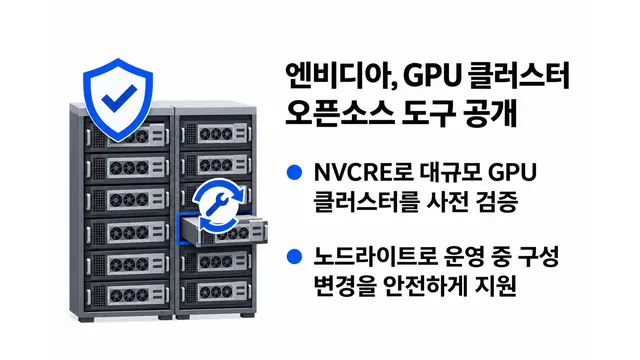
NVIDIA, GPU 클러스터 검증·변경 오픈소스 도구 공개
NVIDIA가 대규모 GPU 클러스터의 사전 검증용 NVCRE와 운영 중 안전한 구성 변경용 노드라이트를 오픈소스로 공개했다.
-
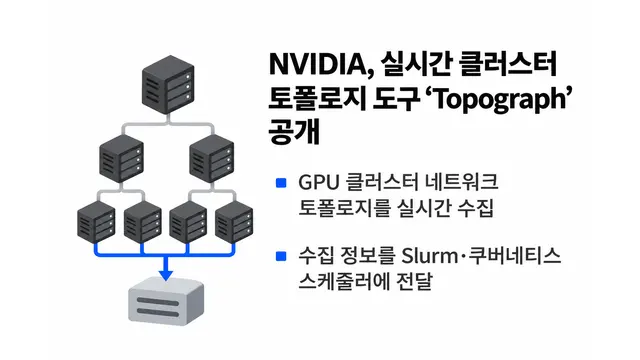
NVIDIA, 클러스터 토폴로지 실시간 파악 도구 'Topograph' 공개
NVIDIA가 GPU 클러스터 네트워크 토폴로지를 실시간 수집해 Slurm·쿠버네티스 스케줄러에 전달하는 오픈소스 도구 Topograph를 공개했다.
-
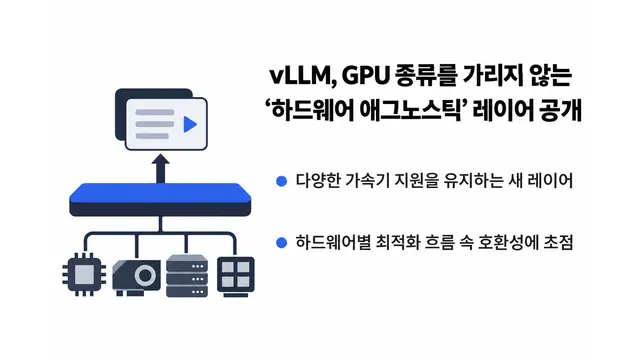
vLLM, GPU 종류 안 가리는 '하드웨어 애그노스틱' 레이어 도입
vLLM이 프런티어 모델의 하드웨어별 최적화 흐름 속에서도 다양한 가속기 지원을 유지하기 위한 새 레이어를 공개했다.
-
토스증권, 쿠버네티스 GPU 클러스터를 GPU-native로 고도화
토스증권이 GPU 인식을 넘어 VRAM 관리·노드 검증까지 아우르는 GPU-native 쿠버네티스 클러스터 구축 과정을 공개했다.
-
AWS 세이지메이커 AI, GPU 인스턴스 우선순위 목록 기능 추가
AWS가 세이지메이커 AI 학습·프로세싱 작업에 최대 5개 GPU 인스턴스를 우선순위로 지정해 자동 시작하는 기능을 도입했다.
-
Together AI, GPU 반값 선점형 컴퓨트 공개 프리뷰 출시
Together AI가 온디맨드 요금의 절반 가격으로 유휴 GPU를 쓸 수 있는 선점형 컴퓨트를 쿠버네티스 클러스터에 공개 프리뷰로 도입했다.
-
레드햇, 'Red Hat AI 3.5'로 GPU 멀티테넌시·격리 강화
레드햇이 우선순위 기반 GPU 자원 배분과 격리 기능을 갖춘 'Red Hat AI 3.5'를 출시해 AI 워크로드를 미션 크리티컬 수준으로 운영할 수 있게 했다.
-
코그니션, AI 에이전트로 RSA-260 인수분해 성공
코그니션이 AI 코딩 에이전트 데빈을 활용해 GPU 기반 GNFS 최적화로 RSA-260 인수분해에 성공했다고 발표했다.
-
NVIDIA, GPU 커널용 Rust 개발 경로 'CUDA Rust' 공개
NVIDIA가 GPU 커널을 Rust로 직접 작성해 PTX로 컴파일할 수 있는 CUDA Rust를 공개했다.
-
PyTorch 2.14 출시, nccl2 백엔드·애플 실리콘 선형대수 지원
PyTorch 2.14가 NCCL 외 통신 백엔드 nccl2와 애플 실리콘용 네이티브 선형대수 연산을 추가해 정식 출시됐다.
-
신형 로우해머 공격 'GPUThor', 엔비디아 GPU ECC 방어 뚫어
토론토대 연구진이 비균일 해머링 기법으로 엔비디아 GPU의 ECC 방어를 무력화하고 루트 권한까지 탈취하는 GPUThor 공격을 공개했다.
-
CUDA 13.3과 함께 'CUDA 파이썬 1.0' 정식 출시
엔비디아가 파이썬을 CUDA C++와 대등한 정식 언어로 만드는 CUDA 파이썬 1.0을 CUDA 13.3과 함께 발표했다.
-
Mojo, 컴파일러·툴체인 아파치 2.0 오픈소스 공개
Mojo 개발사가 1.0 출시 후 컴파일러와 툴체인을 아파치 2.0 라이선스로 공개하며 GPU 특화 독립 언어로 방향을 굳혔다.