엔비디아, AI 팩토리 운영 플랫폼 공개
최근 30일 조회수 — 좋아요 —핵심 요약
미네르바는 분산된 텔레메트리를 지식 그래프로 연결해 장애 원인과 영향을 분석하고 GPU 유휴 시간을 줄인다.
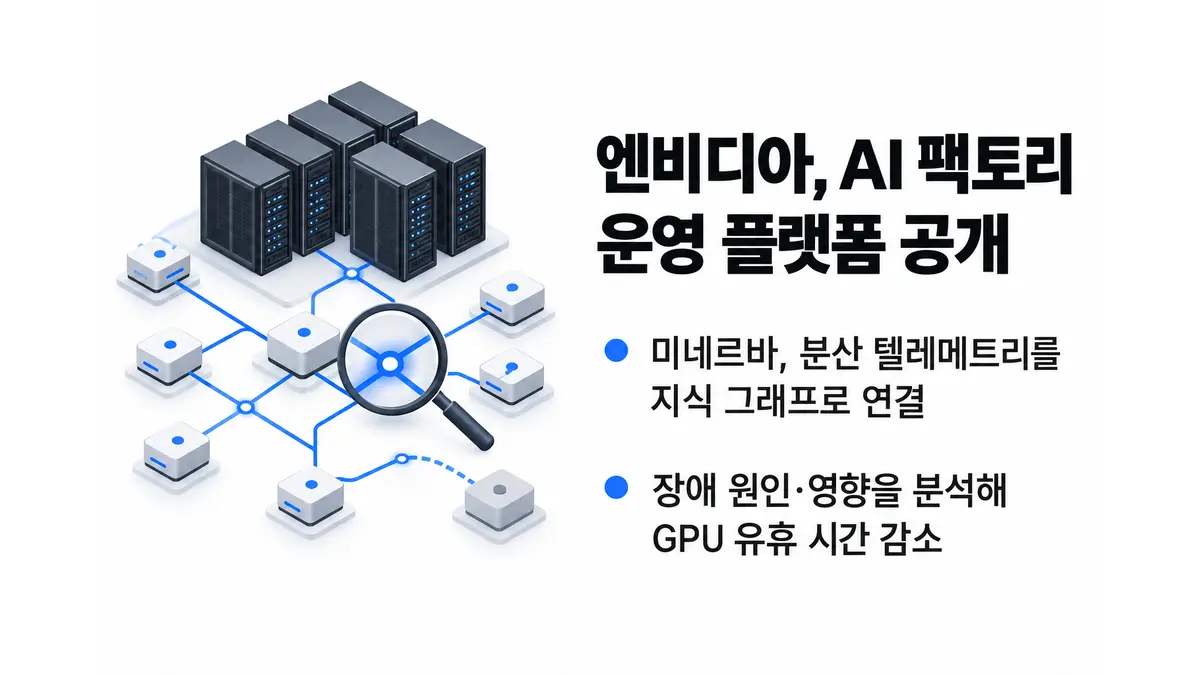
엔비디아(NVIDIA)가 대규모 AI 팩토리의 GPU·네트워크·스토리지·작업 정보를 한데 모아 장애 원인과 영향을 분석하는 운영 플랫폼 미네르바(Minerva)를 공개했다. 흩어진 텔레메트리를 실시간 지식 그래프로 연결하고 전용 머신러닝으로 연관 증상을 하나의 사고로 묶어, 학습 중단과 GPU 유휴 시간을 줄이는 것이 목표다.1
AI 팩토리는 수십만 개의 GPU와 스펙트럼-X(Spectrum-X) 이더넷, NVLink 패브릭, 분산 스케줄러가 함께 움직이는 환경이다. 특히 동기식 분산 학습은 가장 느린 랭크의 속도에 전체 작업이 맞춰진다. GPU 한 개나 네트워크 인터페이스, 저장장치, 스위치 경로 하나만 성능이 떨어져도 정상 자원까지 기다리게 돼 실제로 활용할 수 있는 GPU 시간이 줄어든다.
문제는 이런 이상이 기존 임계값 기반 모니터링에 잘 잡히지 않는다는 데 있다. GPU 온도가 다른 장치보다 몇 도 높거나, NVMe 장치가 지속적인 부하에서만 느려지거나, 스위치의 일시정지 프레임 폭증이 여러 증상으로 흩어지는 식이다. 각 수치는 정해진 경계를 넘지 않을 수 있지만, 함께 나타나면 느린 작업자를 만들고 학습 단계와 체크포인트 저장 시간을 늘린다.
조직별로 관측 화면이 나뉜 점도 진단을 늦춘다. 네트워크 운영자는 인터페이스 카운터와 패브릭 이벤트를 보고, 컴퓨팅 운영자는 노드와 GPU 상태를 확인한다. 머신러닝 팀은 학습 단계 시간이나 작업 실패, 추론 지연 변화를 본다. 각각의 정보는 맞지만 서로의 관계가 드러나지 않아, 대시보드 검색과 부서 간 전달에 몇 시간에서 며칠이 걸릴 수 있다는 것이 엔비디아의 설명이다.1
미네르바는 GPU를 비롯해 Spectrum-X·NVLink 스위치, SuperNIC, 데이터처리장치(DPU), 스토리지, NVIDIA NCCL, 스케줄러와 AI 워크로드에서 지표·로그·토폴로지를 수집한다. 자동 탐색으로 물리·논리 자원과 현재 실행 중인 작업의 관계를 파악하고, 동적으로 바뀌는 지식 그래프에 반영한다. 이를 바탕으로 하나의 물리적 결함이 만든 인터페이스 오류, 수신 일시정지 프레임, 혼잡 신호, GPU 사용률 저하와 작업 지연을 따로 경보하지 않고 의존 관계가 있는 사고로 상관 분석한다.
운영자는 AI 에이전트 기반 도우미를 통해 같은 실시간 증거를 대화식으로 살펴볼 수 있다. 외부 에이전트 도구와 연결하는 모델 컨텍스트 프로토콜(MCP) 서버도 제공한다. 다만 공개된 설명은 미네르바의 설계와 수집 범위를 중심으로 하며, GPU 가동률이 실제로 얼마나 개선됐는지 보여주는 수치나 고객 환경의 비교 결과는 제시하지 않았다. 따라서 효과는 엔비디아가 밝힌 운영 목표와 작동 방식의 범위에서 판단해야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- How NVIDIA Minerva Turns Telemetry Chaos Into Peak GPU Yield | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.