메타, 트리톤 저수준 확장 TLX 공개
최근 30일 조회수 — 좋아요 —핵심 요약
TLX는 트리톤의 생산성을 유지하면서 최신 GPU의 워프·메모리·동기화 기능을 직접 제어한다.
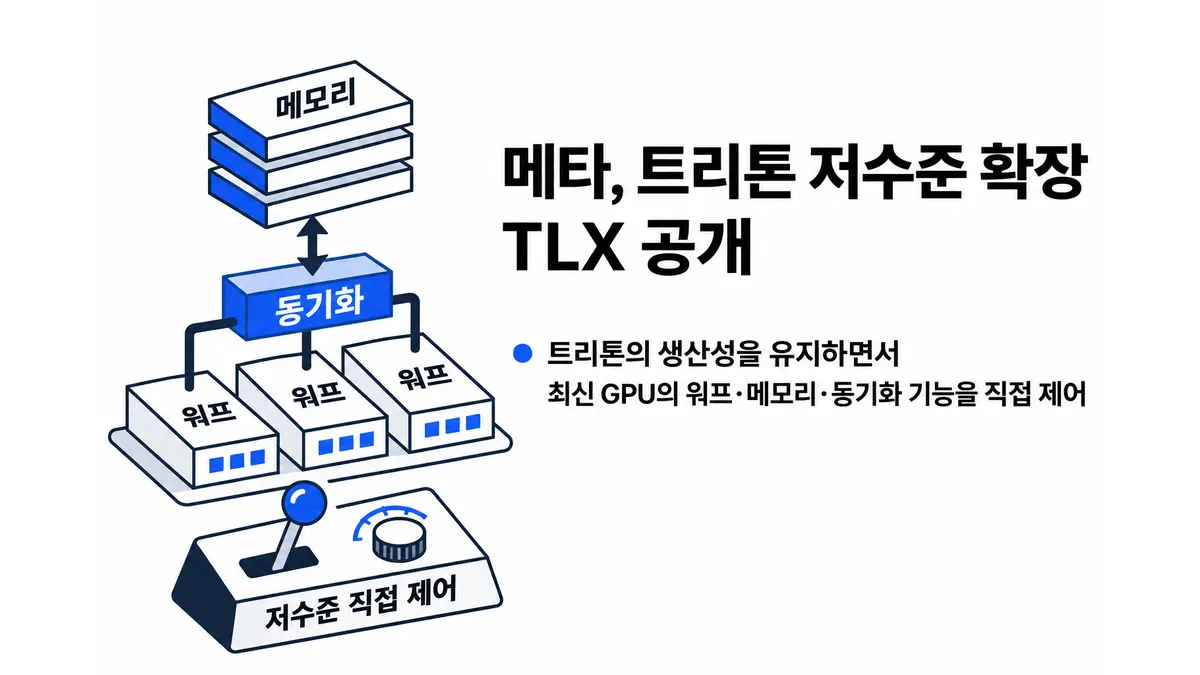
메타(Meta)가 최신 GPU의 저수준 하드웨어 기능을 트리톤(Triton)에서 직접 다룰 수 있도록 확장한 TLX(Triton Low-Level Extensions)를 공개했다. TLX는 파이썬 기반 커널 작성과 자동 튜닝이라는 트리톤의 장점을 유지하면서, 워프 그룹과 메모리 이동, 동기화처럼 성능을 좌우하는 실행 구조를 개발자가 명시적으로 제어하게 해주는 네이티브 GPU 컴파일러 확장이다.1
기존 트리톤은 연산을 블록 단위로 추상화해 GPU 커널 개발을 단순화한다. 그러나 최신 GPU에는 워프 특화, 비동기 메모리 이동, 텐서 메모리, 클러스터 단위 실행 등 기존 프로그래밍 모델로 노출하기 어려운 기능이 늘었다. 가령 최신 플래시어텐션(FlashAttention) 커널은 한 워프 그룹이 TMA 전송을 발행하는 동안 다른 그룹이 텐서 코어 연산을 수행한다. 엔비디아 블랙웰(Blackwell)의 GEMM(일반 행렬 곱셈) 커널은 여러 워프 그룹과 TMEM 할당, 클러스터 자원을 함께 조율한다. 메타 엔지니어들은 이를 기존 방식으로 구현하려면 아키텍처별 조정 코드가 대량으로 필요했다고 설명했다.1
TLX는 CUDA의 스레드 단위 제어와 트리톤의 블록 단위 추상화 사이에 MIMW(Multiple Instructions, Multiple Warps) 실행 모델을 둔다. 확장 범위는 워프 그룹 조정, 동기화, 메모리 조정, 클러스터 실행, 선택적 레이아웃 등 다섯 가지다. 특히 생산자·소비자 역할을 맡은 워프 그룹의 인계 과정을 소스에 드러내면서도, 모든 융합 단계에서 메모리 레이아웃을 수동으로 지정하도록 강제하지 않는 구성이 특징이다.
메타는 TLX를 수개월간 세 가지 실제 작업에 적용했다. 수천 대의 블랙웰 GPU에서 진행한 GEM 모델 학습에서는 종단 간 모델 연산 활용률(MFU) 20~25%를 기록했고, 순전파 속도는 최대 2배 높아졌다. 추천 추론용 인커널 브로드캐스트 최적화(IKBO)에서는 H100의 선형 압축 커널을 4배 빠르게 실행했으며, 함께 설계한 모델의 연산 집약 구간 지연 시간을 최대 3분의 2 줄였다. 대규모 언어 모델(LLM) 사전학습용 분산 그룹 GEMM에서도 장기간 운용되는 대형 GPU 환경의 성능과 신뢰성, 유지보수성을 개선했다고 메타는 밝혔다.1
다만 공개된 수치는 서로 다른 작업과 조건에서 나온 결과여서 TLX 자체의 보편적인 가속률로 볼 수는 없다. 메타는 앞으로 추가적인 엔비디아 아키텍처와 AMD, 자체 가속기 아키텍처 지원을 추가하고, 워프 그룹 조정을 고수준 추상화로 자동화하며, TLX를 torch.compile과 통합할 계획이다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.