메타, LLDB에 CPU·GPU 통합 디버깅 구조 개발
최근 30일 조회수 — 좋아요 —핵심 요약
메타가 제조사별 가속기를 별도 프로세스로 표현하면서 하나의 세션에서 디버깅하는 LLDB 구조를 공개했다.
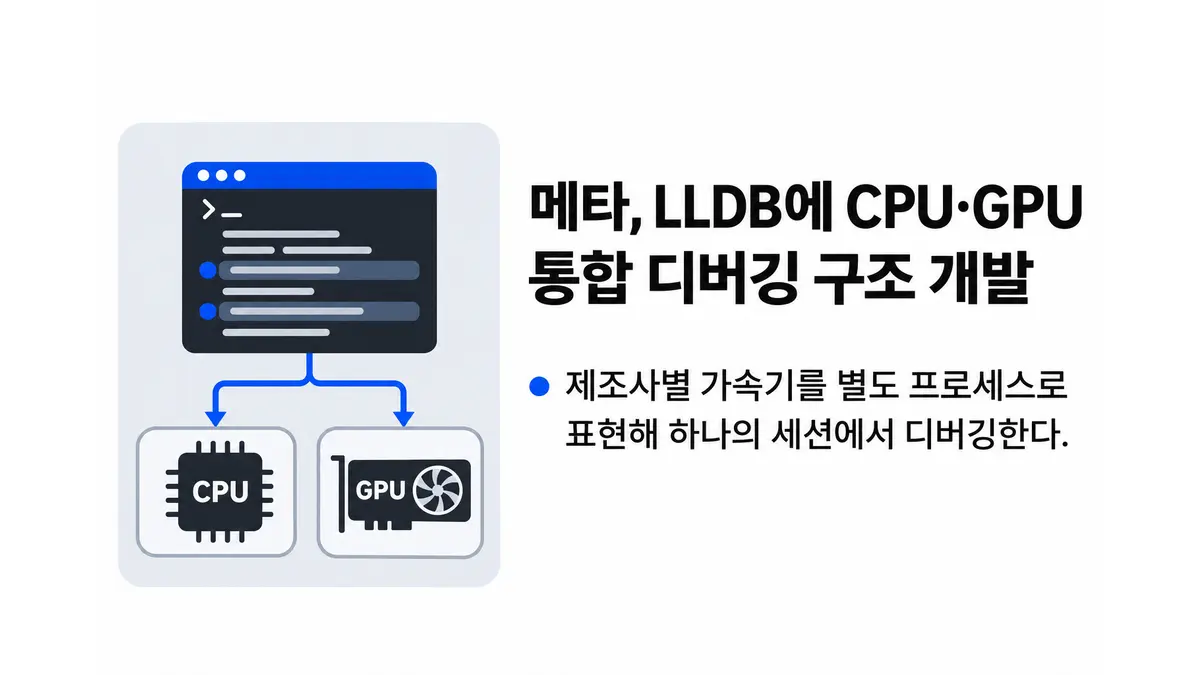
메타가 CPU와 GPU에 걸쳐 실행되는 애플리케이션을 한 세션에서 디버깅할 수 있도록 LLDB의 lldb-server에 제조사 중립적인 가속기 플러그인 구조를 만들었다. CPU와 GPU를 억지로 하나의 프로세스로 합치지 않고 별도 디버거 프로세스로 표현하되, 개발자에게는 통합된 디버깅 세션으로 보여주는 방식이다.1
현대 AI 애플리케이션은 고수준 프레임워크에서 시작해 CPU 네이티브 코드와 GPU 커널 사이를 오간다. 이 경계를 넘나드는 버그를 추적하려면 호스트 애플리케이션과 GPU 상태를 함께 살펴야 한다. 그러나 CPU와 GPU는 명령어 집합과 레지스터, 메모리 공간, 실행 방식이 다르다. GPU가 호스트 프로세스 안의 런타임과 드라이버를 통해 제어된다는 점도 디버깅을 어렵게 만든다.
기존 디버거는 대체로 프로세스 하나에 아키텍처 하나가 대응하고, 스레드·레지스터·메모리를 일관된 방식으로 볼 수 있다고 가정한다. GPU 프로그램은 이 전제를 따르지 않는다. 가령 호스트는 x86-64로 실행되는 반면 GPU 커널은 전혀 다른 명령어를 쓸 수 있다. GPU의 수천 개 실행 레인은 일반적인 디버거의 스레드 모델과도 깔끔하게 맞지 않는다.
CPU와 GPU를 하나의 인위적인 프로세스 모델에 넣으면 메모리 읽기, 중단점, 단계 실행, 정지 이벤트마다 어느 하드웨어에 적용할 작업인지 판단해야 한다. 독립된 주소 공간도 충돌한다. 0x1000이라는 같은 주소가 CPU와 GPU에서 서로 다른 위치를 가리킬 수 있기 때문이다. 메타의 설계는 이런 차이를 숨기는 대신 프로세스 경계로 명확히 드러낸다.
lldb-server는 프로그램을 실행하거나 연결해 저수준 디버깅을 수행하며, LLDB 클라이언트와 GDB 원격 프로토콜로 통신한다. 새 인터페이스에서는 하드웨어별 백엔드가 제조사의 장치 디버깅 API를 프로세스, 스레드, 레지스터, 메모리, 모듈, 정지 원인 같은 LLDB 개념으로 변환한다. 덕분에 클라이언트는 특정 제조사에 종속되지 않고, 명령행 인터페이스와 원격 프로토콜, 심벌 처리, IDE 연동 개선을 여러 가속기가 공유할 수 있다.
AMD의 ROCgdb나 엔비디아의 CUDA-GDB처럼 기존 제조사별 도구는 각 플랫폼을 깊이 지원하지만, 공통 기능을 따로 구현하고 유지해야 했다. 이번 구조는 그 중복을 줄일 기반을 제시한다. 다만 메타가 공개한 내용은 공통 구조와 역할 분리에 초점을 맞췄으며, 구체적인 지원 GPU나 성능·호환성 범위는 제시하지 않았다.
Footnotes
-
Meta Engineering, “Extending LLDB to Debug Applications That Span CPUs and GPUs” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Extending LLDB to Debug Applications That Span CPUs and GPUs — Meta Engineering
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.