타임아웃 캐스케이드, 코딩 GPU 비용 33% 절감
최근 30일 조회수 — 좋아요 —핵심 요약
소형 모델이 실패할 때만 대형 모델로 전환해 정확도를 유지하며 코딩 에이전트의 GPU 비용을 최대 33% 줄였다.
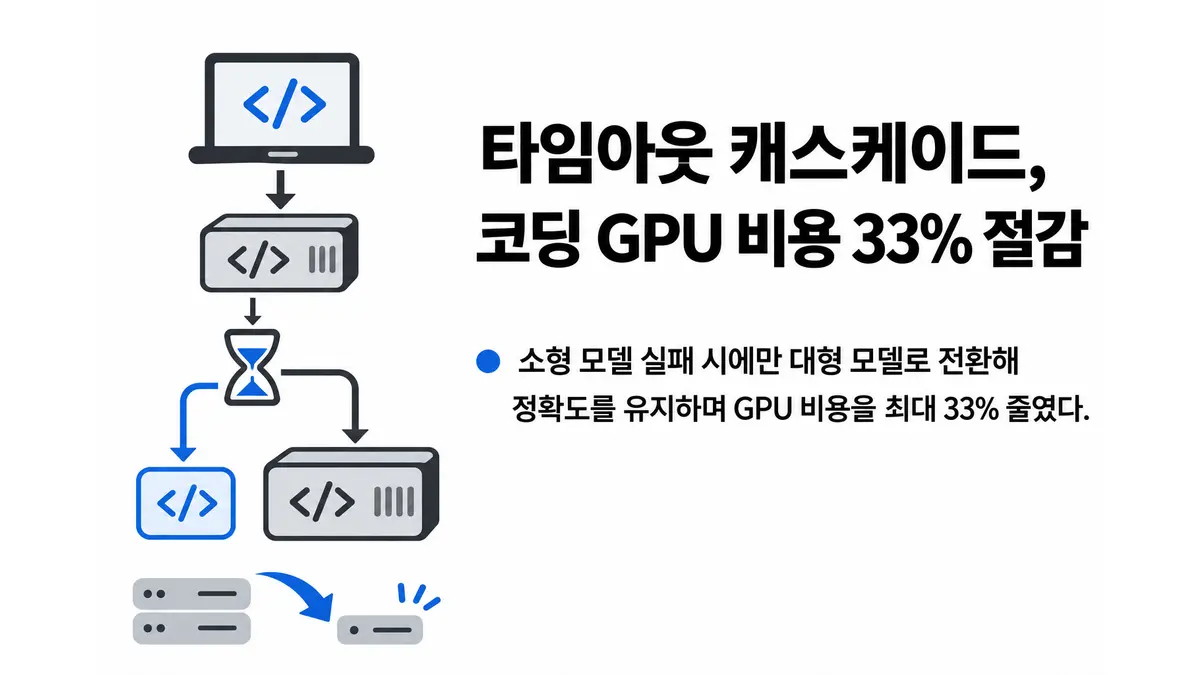
코딩 에이전트가 먼저 소형 언어모델을 실행하고, 정해진 시간 안에 문제를 풀지 못하면 대형 모델로 넘기는 ‘타임아웃 캐스케이드(timeout cascade)’ 기법이 제안됐다. 11월 18일 공개된 arXiv 논문에 따르면, 이 방식은 정확도를 떨어뜨리지 않으면서 전체 GPU 사용시간 비용을 최대 33% 줄였다.1
연구진은 2024년 이후 출시된 공개 가중치 모델 36종을 소프트웨어 공학 벤치마크에서 평가했다. 최근 소형 모델은 쉬운 문제와 중간 난도 문제에서 높은 정확도를 보였고, 대형 모델과의 성능 차이는 소형 모델이 풀지 못하는 어려운 문제에 집중됐다. 모든 작업을 처음부터 비싼 대형 모델에 맡길 필요가 없다는 뜻이다.
타임아웃 캐스케이드는 이 차이를 이용한다. 소형 모델에 먼저 풀이 기회를 주고, 필요할 때만 대형 모델로 전환한다. 논문은 전체 GPU 사용시간 비용을 최대 33%, SWE-bench Verified의 전체 과제를 대상으로는 16.4% 절감했다고 보고했다. 두 경우 모두 정확도는 유지됐다는 것이 연구진의 설명이다.1
특히 이 단순한 방식은 각 과제에 알맞은 모델을 미리 골라 주는 오라클 방식의 작업 라우터와 거의 같은 성과를 냈다. 별도의 학습형 라우터를 구축하지 않아도 소형 모델의 저렴한 추론과 대형 모델의 문제 해결력을 함께 활용할 수 있다는 점이 실무적으로 중요하다. 복잡한 분류 시스템 없이도 코딩 에이전트의 GPU 비용을 낮출 수 있기 때문이다.
다만 이번 결과는 공개 가중치 모델 36종과 SWE-bench Verified를 중심으로 얻은 것이다. 다른 개발 작업이나 폐쇄형 모델에서도 같은 절감률이 나오는지는 자료만으로 확인할 수 없다. 논문 역시 2026년 11월 18일 제출된 초판으로, 제시된 수치는 해당 실험 조건에서의 결과로 봐야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Reducing Inference Cost of Coding Agents with Timeout Cascades — arXiv (cs.SE)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.