투게더 AI, GPU 분산 캐시 TSA 출시
최근 30일 조회수 — 좋아요 —핵심 요약
외부 모델·데이터를 클러스터 NVMe에 캐시해 반복 다운로드 속도와 전송 비용을 줄인다.
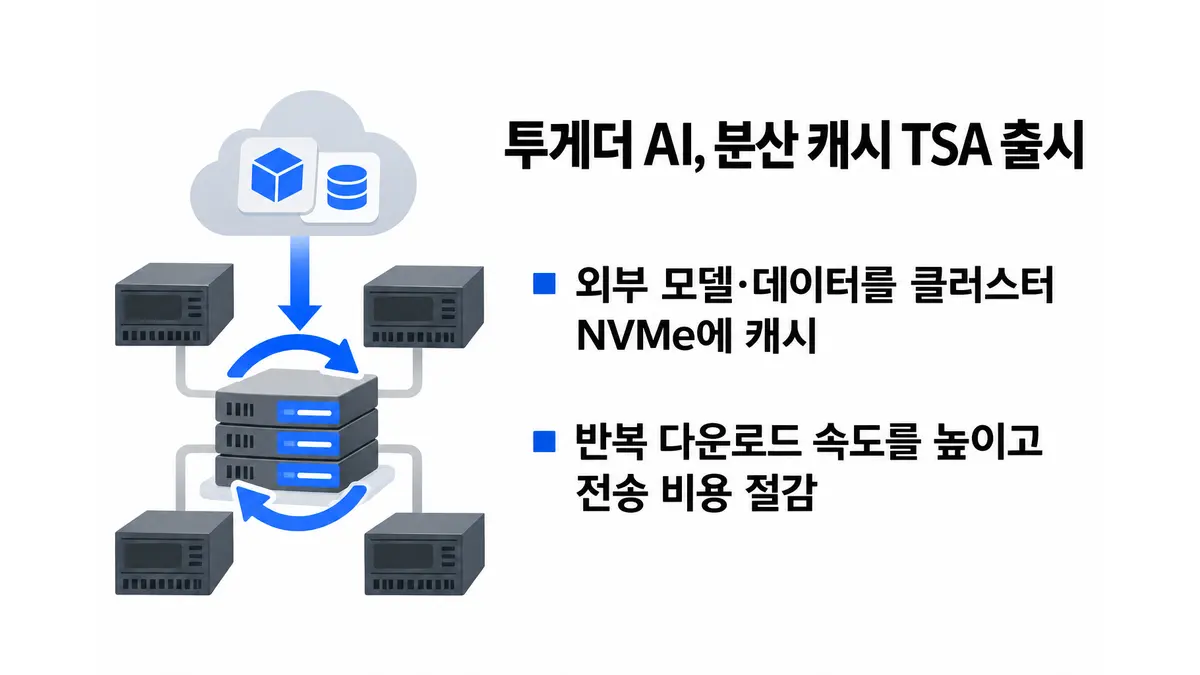
투게더 AI(Together AI)가 GPU 클러스터에서 모델과 데이터의 반복 다운로드를 줄이는 분산 캐시 계층 ‘투게더 스토리지 액셀러레이터(Together Storage Accelerator·TSA)’를 출시했다. TSA는 투게더 GPU 클러스터의 모든 노드에서 작동하며, 기존 오브젝트 스토리지와 허깅페이스 허브(Hugging Face Hub)에서 처음 읽은 데이터를 클러스터 내부 NVMe에 저장한다. 이후 어느 노드가 같은 데이터를 요청해도 원본 저장소 대신 내부 캐시에서 가져온다. 모든 투게더 GPU 클러스터에 추가 비용 없이 포함된다.1
TSA가 겨냥한 문제는 GPU와 데이터 저장 위치 사이의 거리다. 모델과 데이터셋을 아마존 S3, 클라우드플레어 R2 같은 외부 저장소에 두면 작업을 시작할 때마다 클라우드나 리전을 가로질러 내려받아야 한다. 투게더 AI는 AWS의 데이터 전송 비용이 최대 GB당 0.09달러에 이르며, 수백 개 노드가 같은 체크포인트를 각각 받으면 대기 시간과 비용이 함께 늘어난다고 설명했다. 허깅페이스의 속도 제한이나 원본 서비스 장애도 작업 중단으로 이어질 수 있다.1
회사가 H100 노드에서 측정한 결과, 외부 R2 버킷의 2GiB 객체를 직접 읽을 때는 초당 143169MB로 12.715.0초가 걸렸다. 캐시가 채워진 뒤에는 초당 3.03.4GB, 0.640.72초로 약 20배 빨랐다. 5KB와 2.4MB 파일의 지연 시간도 각각 320ms와 680ms에서 5ms와 8ms로 줄었다. 같은 체크포인트를 200개 노드가 받는 상황에서는 원본 접근 횟수가 200회에서 1회로 감소했다. 70GB 체크포인트라면 원본에서 한 번만 내려받는 구조다.1
도입 방식은 기존 애플리케이션을 고치는 대신 엔드포인트를 바꾸는 형태다. S3 호환 저장소는 AWS_ENDPOINT_URL, 허깅페이스는 HF_ENDPOINT를 TSA 주소로 지정하면 된다. 회사 설명에 따르면 기존 boto3, 트랜스포머 호출과 명령줄 작업을 그대로 쓸 수 있으며, 인증 정보는 암호화해 비밀정보 저장소에 보관한다.1
다만 성능 수치는 2026년 10월 28일 미국 중부 리전의 미리보기 배포판(TSA chart 0.6.0)에서 같은 객체를 반복해 읽은 결과다. 원본 위치와 객체 크기, 네트워크 경로에 따라 차이가 나며, 첫 번째 읽기는 캐시 효과를 받지 않는다. 투게더 AI는 첫 읽기의 성능 차이가 직접 다운로드 대비 약 5% 이내였다고 밝혔다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Introducing Together Storage Accelerator: fast, free data caching for your GPU cluster — Together AI Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.