쿠버네티스, GPU 유휴 줄일 연동 추진
최근 30일 조회수 — 좋아요 —핵심 요약
쿠버네티스가 AI 작업 대기와 GPU 유휴를 줄이기 위해 스케줄러·오토스케일러 연동 API를 제안했다.
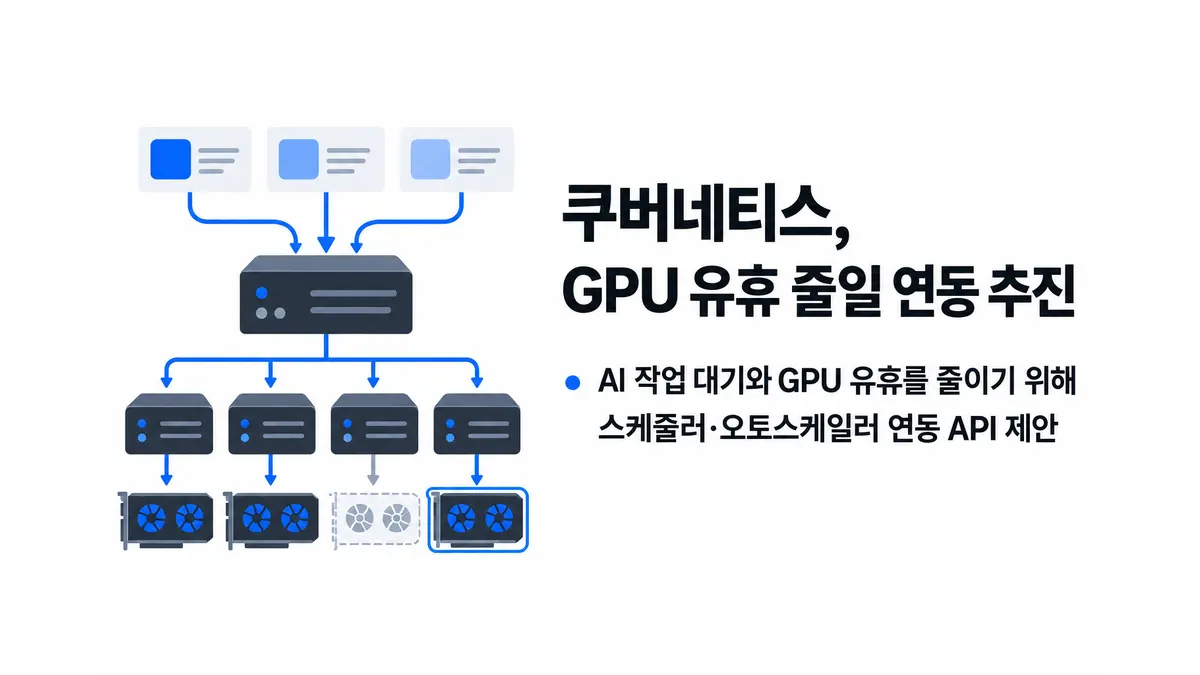
쿠버네티스(Kubernetes) 커뮤니티가 AI 추론 작업은 대기하는데 값비싼 GPU는 놀고 있는 문제를 줄이기 위해 스케줄러와 오토스케일러의 직접 연동을 추진한다. 스케줄러는 현재 노드에 파드를 배치하고, 오토스케일러는 부족한 노드를 추가하지만, 두 제어 루프가 서로 다른 정보로 판단하면서 필요한 GPU가 있어도 파드가 Pending 상태에 머무는 일이 생긴다.1
AWS의 사잔 군다푸니디와 닐렌드라 반다리는 GPU 같은 희소한 가속기를 효율적으로 쓰려면 자원을 배치하는 스케줄러와 공급하는 오토스케일러가 같은 계획을 공유해야 한다고 지적했다. 특히 요청량이 급변하는 추론 서비스와 에이전틱 AI 작업은 새 노드가 준비될 때까지 기다리는 ‘콜드 노드’ 지연에 민감하다. 용량 예약, 장치 토폴로지, GPU 공유까지 얽히면 현재처럼 두 기능이 분리된 구조에서는 판단이 더 어려워진다.1
해법으로는 동적 자원 할당(DRA)을 인식하는 오토스케일러와 작업 특성을 반영하는 스케줄링, 두 기능을 잇는 프로비저닝 요청이 거론된다. 쿠버네티스 SIG-Autoscaling에 공개된 제안은 여기서 한발 더 나아간다. 스케줄러가 앞으로 공급할 수 있는 용량을 확인하고, 그 용량에 대한 배치 선호도를 표시한 뒤 필요한 자원을 명시적으로 요청할 수 있도록 API를 마련하는 구상이다. 오토스케일러를 단순히 노드 수를 늘리는 구성요소가 아니라 스케줄러의 의도를 이해하는 협력자로 바꾸려는 것이다.1
다만 이는 공개 제안 단계이며, 기사에는 API 확정 여부나 적용 일정, 실제 GPU 이용률 개선 수치가 제시되지 않았다. 방향은 분명하지만 효과를 판단하려면 구현 이후 대기 시간과 유휴 GPU 비율을 검증해야 한다. 쿠버네티스의 AI 대응도 추론 배치에만 머물지 않는다. HPE는 장시간 AI·머신러닝 작업에서 발생하는 파드 재시작 진단을 자동화해 정보를 슬랙으로 보내는 오픈소스 도구를 활용하고 있으며, 분산 추론 프로젝트 llm-d도 PyTorch 개발 환경과 운영용 클라우드 네이티브 스택을 잇는 v1.0에 도달했다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.