장기 실행 에이전트 비용 줄이는 접두어 캐싱
최근 30일 조회수 — 좋아요 —핵심 요약
접두어를 유지하는 클라이언트 설계와 캐시 GPU 라우팅이 장기 실행 에이전트의 추론 비용을 줄인다.
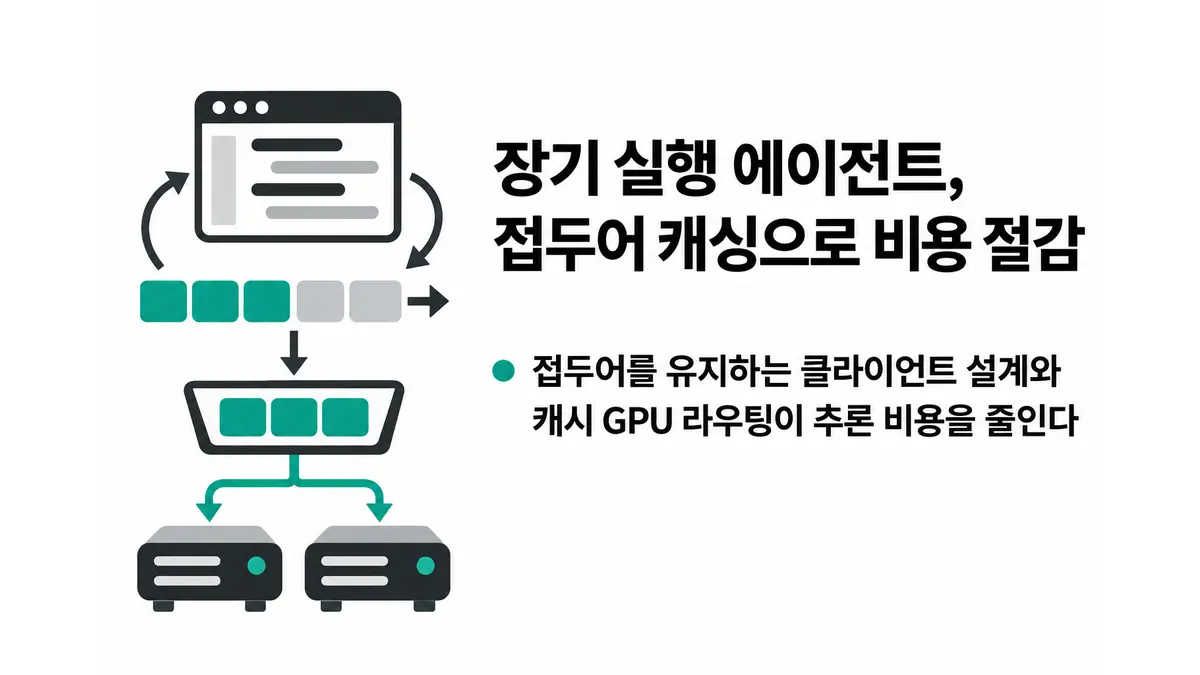
코딩 에이전트가 긴 작업을 반복할수록 커지는 추론 비용을 줄이려면, 추론 엔진의 접두어 캐싱(prefix caching)뿐 아니라 프롬프트 앞부분을 바꾸지 않는 클라이언트 설계와 캐시가 있는 GPU로 요청을 되돌려 보내는 라우팅이 함께 필요하다. Together AI는 Ollama와의 협업 경험을 토대로 오픈 모델 기반 장기 실행 에이전트에서 양쪽이 지켜야 할 조건을 공개했다.1
코딩 에이전트의 요청 구조는 일반 챗봇과 다르다. 에이전트 하네스는 매 단계마다 시스템 프롬프트와 도구 정의, 사용자 요청, 읽은 파일, 실행한 명령을 포함한 전체 대화를 다시 전송한다. 입력 시퀀스 길이(ISL)는 계속 늘지만, 모델이 돌려주는 출력 시퀀스 길이(OSL)는 대개 수십 토큰짜리 도구 호출에 그친다. 추론은 전체 프롬프트를 병렬로 읽어 첫 토큰을 만드는 프리필(prefill)과 이후 토큰을 하나씩 생성하는 디코드(decode)로 나뉘는데, 이런 작업에서는 긴 입력을 처리하는 프리필이 지연 시간의 대부분을 차지한다. 추론 모델이 사고 토큰을 추가하더라도 세션이 수만 토큰으로 자라면 입력의 비중이 여전히 크다는 설명이다.1
핵심은 앞선 요청에서 계산한 키·값(KV) 상태를 다음 요청에서도 재사용하는 것이다. 7번째 요청이 6번째 요청에 새 내용만 덧붙인 형태라면, 접두어 캐시는 기존 부분을 다시 계산하지 않고 추가분만 처리한다. 매 단계 같은 분량이 늘어난다고 단순화하면, 캐시가 없을 때 10회 동안 처리하는 프롬프트 양은 1+2+…+10=55단위지만 캐시를 쓰면 10단위다. 100회에서는 5,050단위와 100단위로 차이가 벌어진다.1
다만 캐시는 자동으로 성능을 보장하지 않는다. 하네스가 프롬프트 시작 부분을 수정하면 뒤에 이어진 내용까지 기존 접두어와 일치하지 않아 재사용 범위가 사라질 수 있다. 프롬프트가 그대로여도 다음 요청이 캐시를 보유하지 않은 GPU로 전달되면 같은 문제가 생긴다. 따라서 Ollama 같은 클라이언트 통합 계층은 요청의 앞부분을 안정적으로 유지하고, Together AI 같은 추론 엔진은 세션의 후속 요청을 기존 캐시가 남아 있는 GPU로 보내야 한다. 장기 실행 에이전트의 최적화 단위가 모델이나 서버 한쪽이 아니라, 프롬프트를 조립하는 단계부터 GPU 라우팅까지 이어지는 전체 경로라는 것이 이번 공개의 요지다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Making open models work for long-horizon agentic workloads — Together AI Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.