LLM / LLM 추론 / LLM 에이전트 / LLM 검색 / LLM 믹서 / LLM재킹 / LLM 라우팅 / LLM 보안 / 오픈소스 LLM / 멀티모달 LLM / LLM 서빙 / 하이브리드 LLM / 서바이벌 LLM / 로컬 LLM / LLM 평가 / 임상 LLM / LLM 심사 / LLM압축 / LLM 에이전트 보안 / 로컬LLM / LLM 압축
167건
기사 통계를 확인하고 있습니다.
-
Vim Classic 8.3.1 출시
Vim 패치를 선별 반영하고 플러그인 호환성을 개선했으며 파이썬 2 지원은 삭제했다.
-
AWS, 분산 KV 캐싱 스킬 공개
AWS가 자체 호스팅 LLM의 추론 비용과 첫 토큰 지연을 줄이는 분산 KV 캐싱 스킬을 공개했다.
-
에이전트 AI 추론 플랫폼 검증법 공개
실측·재생·합성 워크로드를 결합해 실제 에이전트 트래픽의 추론 성능을 단계별로 검증하는 방법론이 제안됐다.
-
LLM 취약점 탐지 방해하는 안티에이전트
자바스크립트 동작을 유지하면서 LLM 에이전트의 취약점 탐지 건수를 최대 60.7% 줄이는 기법이 제안됐다.
-
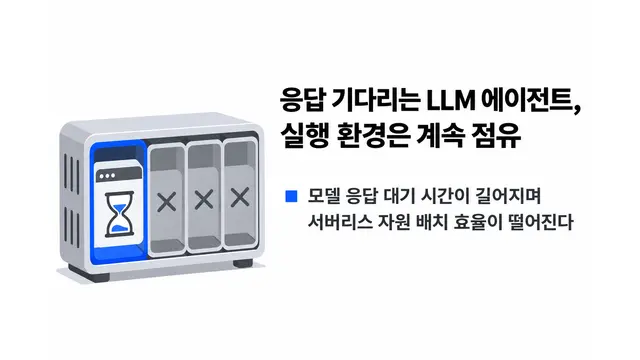
LLM 에이전트, 응답 대기 중 실행 환경 낭비
LLM 에이전트가 모델 응답을 기다리며 서버리스 실행 환경을 장시간 점유해 자원 배치 효율을 떨어뜨린다는 분석이 나왔다.
-
바주카 악성코드, LLM으로 피해자 선별
안드로이드 악성코드 바주카가 LLM을 활용해 고가치 피해자를 선별하고 대규모 감염 관리를 지원한다.
-
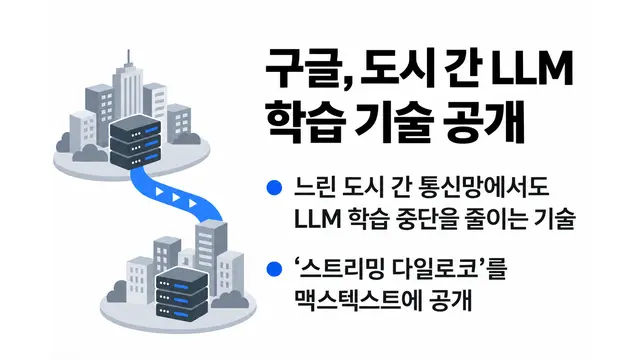
구글, 도시 간 LLM 학습 기술 공개
구글이 느린 도시 간 통신망에서도 LLM 학습 중단을 줄이는 스트리밍 다일로코를 맥스텍스트에 공개했다.
-
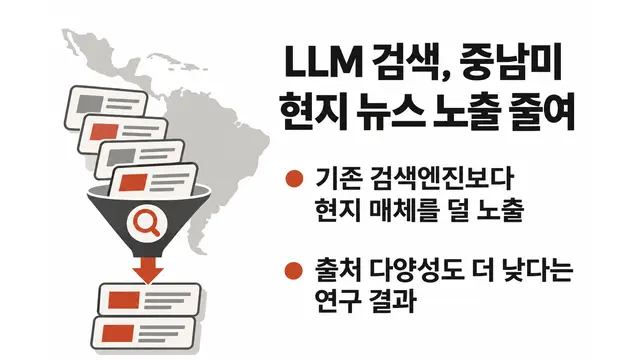
LLM 검색, 중남미 현지 뉴스 노출 줄여
LLM 기반 검색이 기존 검색엔진보다 라틴아메리카 현지 매체를 덜 노출하고 출처 다양성도 낮다는 연구가 나왔다.
-
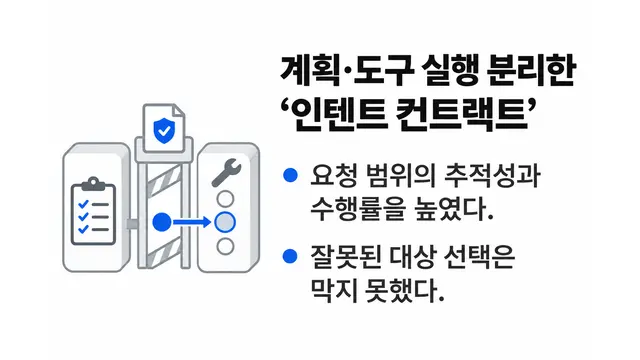
도구 권한 분리한 ‘인텐트 컨트랙트’
계획과 도구 실행을 분리해 요청 범위의 추적성과 수행률을 높였지만 잘못된 대상 선택은 막지 못했다.
-
AWS, 세이지메이커 서버리스 FFT 추가
AWS가 GPU·클러스터 구성 없이 LLM 전체 파라미터를 학습하는 서버리스 미세조정 기능을 출시했다.
-
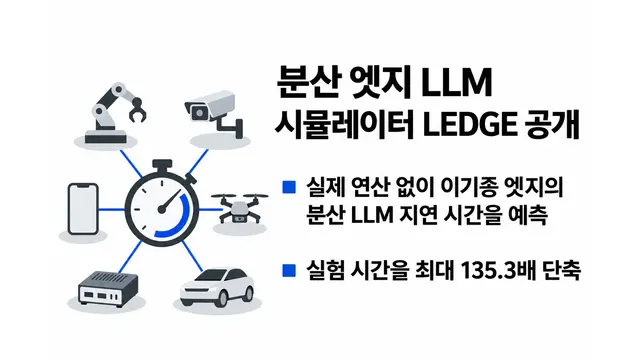
분산 엣지 LLM 시뮬레이터 LEDGE 공개
LEDGE는 실제 연산 없이 이기종 엣지의 분산 LLM 지연 시간을 예측해 실험을 최대 135.3배 단축했다.
-
LLM 기반 C→러스트 번역기 11종서 결함
연구진이 C-to-Rust 번역기 11종을 재검증해 결함 160건과 자체 평가 절차의 허점을 확인했다.
-
프롬프트 인젝션 레드팀 기법 ‘AutoPI’ 제안
AutoPI는 공격 성공률과 기법 커버리지를 함께 측정해 LLM 에이전트의 다양한 취약점을 탐색한다.
-
LLM 이후 과학 논문 변화는 제한적
논문 250만 편을 분석한 결과, LLM 등장 뒤에도 과학 논문의 변화는 대부분 기존 추세를 이어갔다.
-
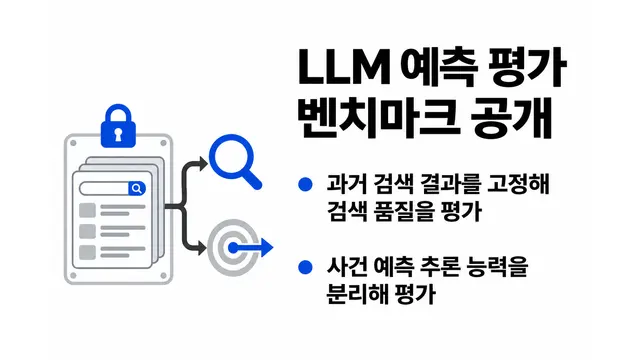
LLM 예측 평가 벤치마크 공개
포캐스트짐은 과거 검색 결과를 고정해 LLM의 검색 품질과 사건 예측 추론 능력을 분리 평가한다.
-
LLM 로봇 설정 바꾸는 무인증 공격
리치 미니 라이트의 인증 없는 관리 경로를 통해 시스템 프롬프트와 행동 지침을 바꾸는 공격이 입증됐다.
-
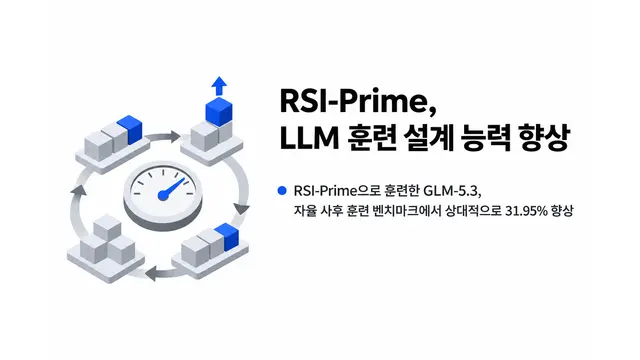
RSI-Prime, LLM 훈련 설계 능력 향상
RSI-Prime으로 훈련한 GLM-5.3이 자율 사후 훈련 벤치마크에서 상대적으로 31.95% 향상됐다.
-
LLM 0.37.3, SQLite 호환성 문제 수정
SQLite 3.54.1의 JSON 처리 변경에 맞춰 LLM의 로깅 코드가 수정됐다.
-
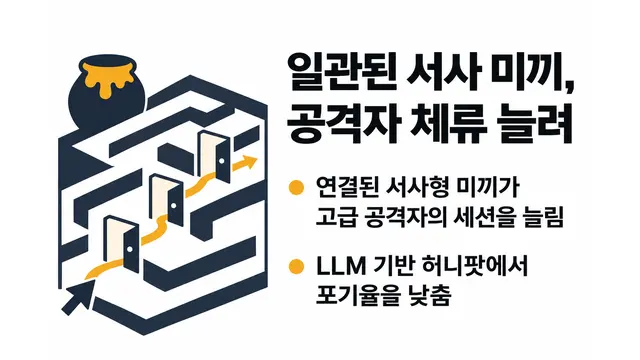
일관된 서사 미끼, 공격자 체류 늘려
LLM 기반 허니팟에서 연결된 서사형 미끼가 고급 공격자의 세션을 늘리고 포기율을 낮췄다.
-
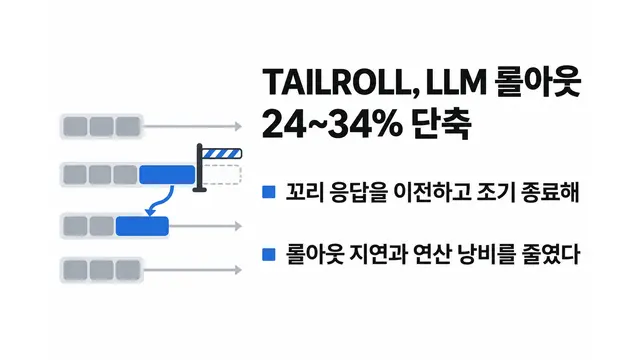
TAILROLL, LLM 강화학습 롤아웃 24~34% 단축
꼬리 응답을 이전·조기 종료하는 스케줄링으로 LLM 강화학습의 롤아웃 지연과 연산 낭비를 줄였다.
-
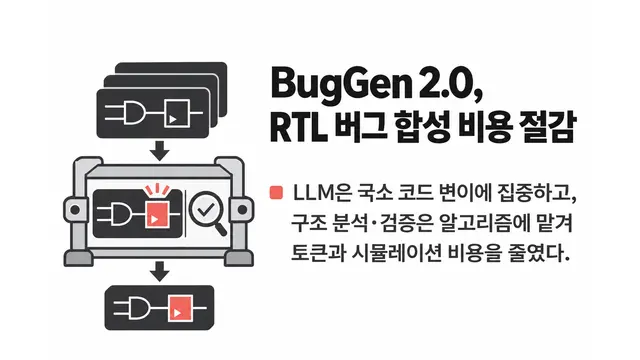
BugGen 2.0, RTL 버그 합성 비용 절감
LLM을 국소 코드 변이에 집중하고 구조 분석·검증을 알고리즘에 맡겨 토큰과 시뮬레이션 비용을 줄였다.
-
LLM 81.5%, 시스템 프롬프트 비밀 유출
에이전트형 CTF 실험에서 LLM 363개 중 296개가 시스템 프롬프트의 비밀 플래그를 유출했다.
-
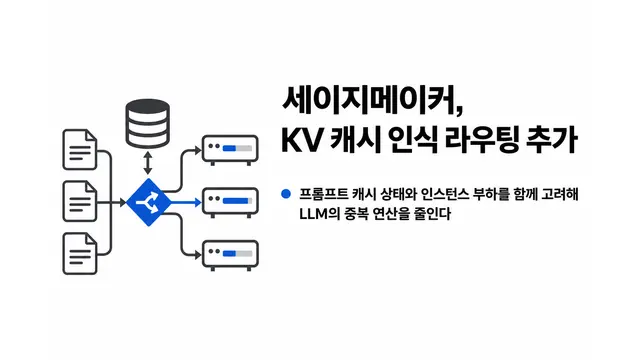
AWS 세이지메이커, KV 캐시 인식 라우팅 추가
프롬프트 캐시 상태와 인스턴스 부하를 함께 고려해 LLM의 중복 연산을 줄이는 라우팅 기능이다.
-
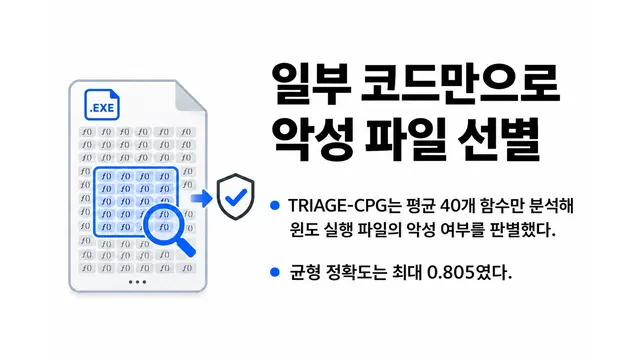
LLM, 일부 코드로 악성 파일 선별
TRIAGE-CPG는 평균 40개 함수만 분석해 윈도 실행 파일 악성 여부를 최대 0.805 균형 정확도로 판별했다.
-
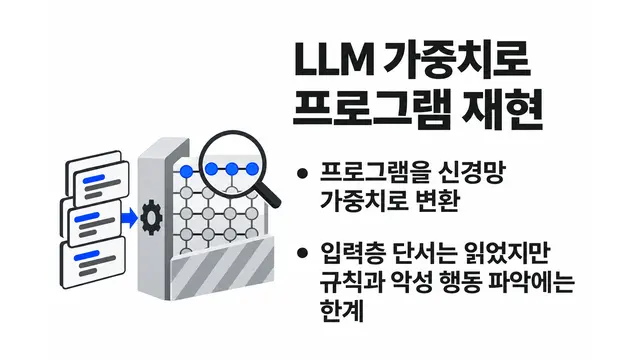
LLM 가중치 공간 프로그래밍 재현
Astra는 프로그램을 신경망 가중치로 변환하고 입력층 단서를 읽었지만 규칙과 악성 행동 파악에는 한계를 보였다.
-
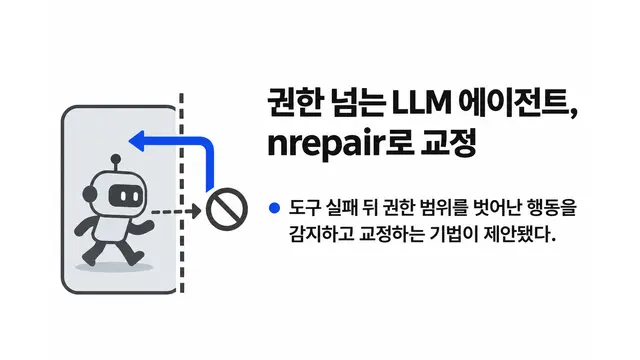
LLM 에이전트의 위험한 폴백 교정법 제안
도구 실패 후 권한 범위를 넘는 LLM 에이전트 행동을 감지·교정하는 nrepair 기법이 제안됐다.
-
탈취한 기업 AI 계정 재판매하는 ‘LLM 믹서’
범죄 조직이 탈취한 기업 AI 계정과 API 키를 불법 중계해 피해 기업에 최대 100만달러의 요금을 떠넘겼다.
-
구글, LLM의 보안 패치 악용 자동화 확인
공격자들이 LLM 에이전트로 공개 패치를 분석해 취약점 탐지부터 익스플로잇 실행까지 자동화한 사례가 확인됐다.
-
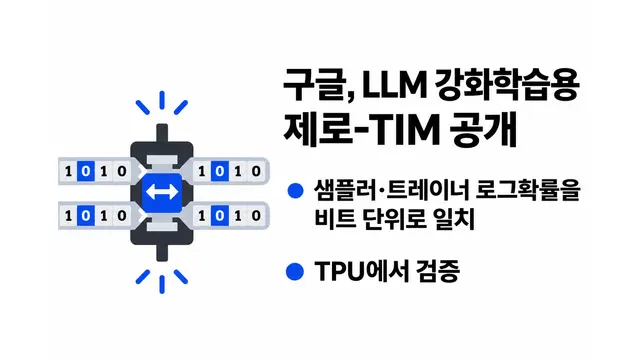
구글, LLM 강화학습용 제로-TIM 공개
구글이 샘플러와 트레이너의 로그확률을 비트 단위로 일치시키는 제로-TIM을 TPU에서 검증했다.
-
datasette-llm, 로컬 모델 연결 지원
OpenAI 호환 API를 통해 Datasette Agent를 LM Studio·Ollama 등 로컬 LLM과 연결할 수 있게 됐다.
-
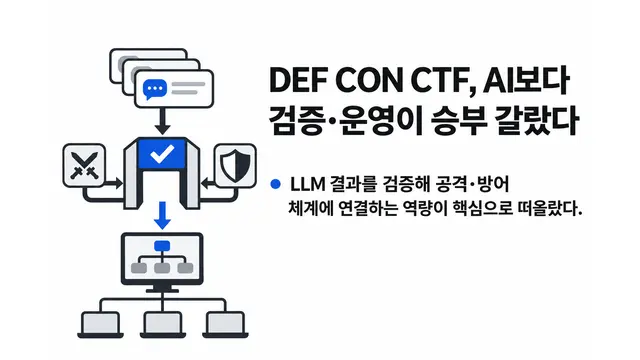
DEF CON CTF 2026, AI보다 검증·운영이 승부 갈랐다
LLM이 허용된 DEF CON CTF에서 AI 결과를 검증해 공격·방어 체계에 연결하는 역량이 핵심으로 떠올랐다.
-
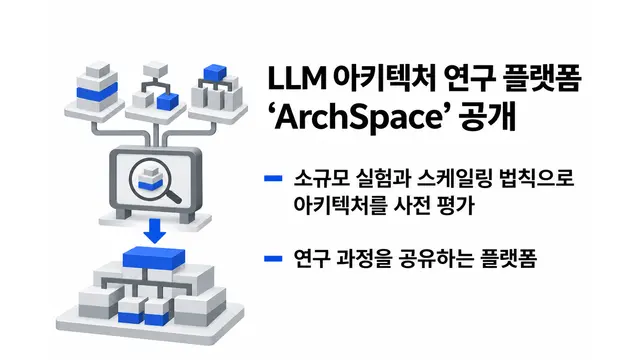
LLM 아키텍처 연구 플랫폼 ArchSpace 공개
ArchSpace는 소규모 실험과 스케일링 법칙으로 LLM 아키텍처를 사전 평가하고 연구 과정을 공유한다.
-
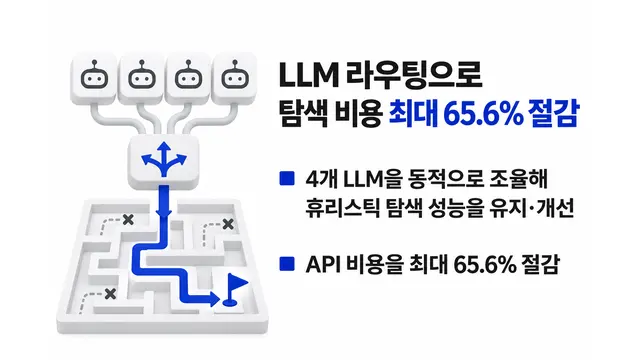
LLM 라우팅으로 탐색 비용 최대 65.6% 절감
Ballad는 4개 LLM을 동적으로 조율해 휴리스틱 탐색 성능을 유지·개선하며 API 비용을 최대 65.6% 줄였다.
-
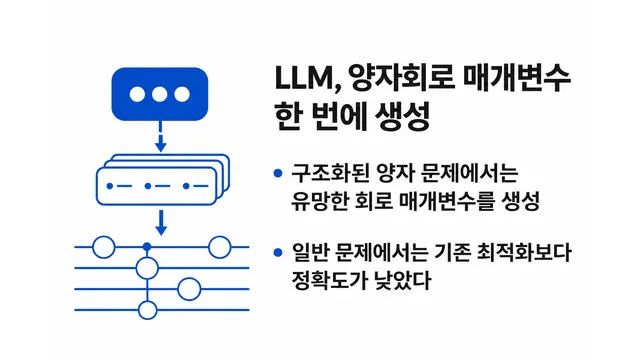
LLM, 양자회로 매개변수 한 번에 생성
LLM이 구조화된 양자 문제에서 유망한 회로 매개변수를 생성했지만 일반 문제에서는 기존 최적화보다 부정확했다.
-
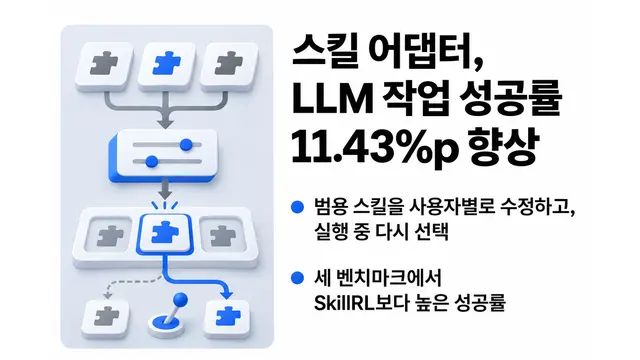
스킬 어댑터, LLM 작업 성공률 11.43%p 향상
범용 스킬을 사용자별로 수정하고 실행 중 재선택해 세 벤치마크에서 SkillRL보다 높은 성공률을 기록했다.
-
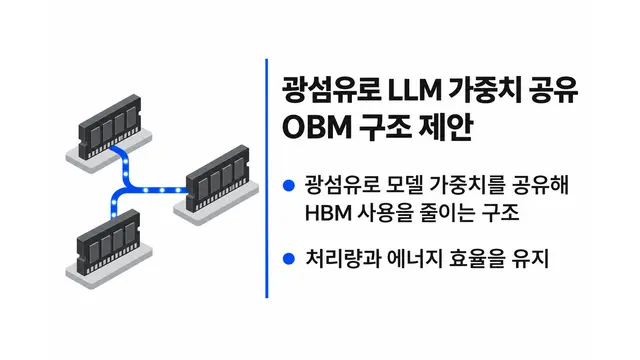
광섬유로 LLM 가중치 공유하는 OBM 제안
OBM은 광섬유로 모델 가중치를 공유해 HBM을 줄이면서 처리량과 에너지 효율을 유지하는 구조다.
-
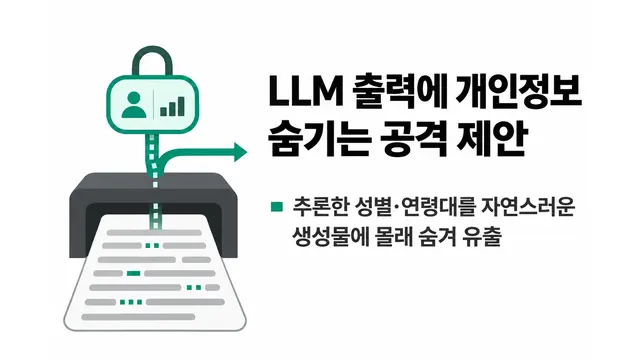
LLM 출력에 개인정보 숨기는 공격 제안
LLM이 추론한 성별·연령대를 자연스러운 생성물에 몰래 숨겨 유출하는 공격 모델이 제안됐다.
-
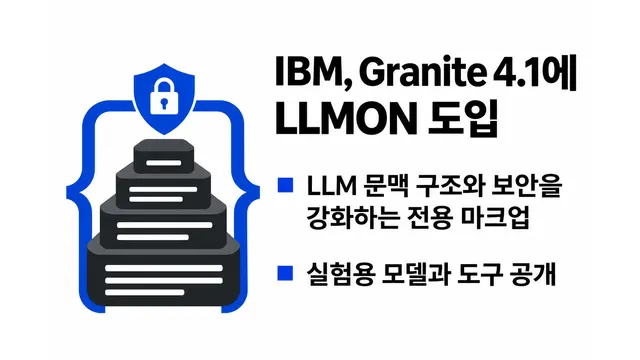
IBM, Granite 4.1에 LLMON 도입
IBM이 LLM 문맥 구조와 보안을 강화하는 전용 마크업 LLMON의 실험용 모델과 도구를 공개했다.
-
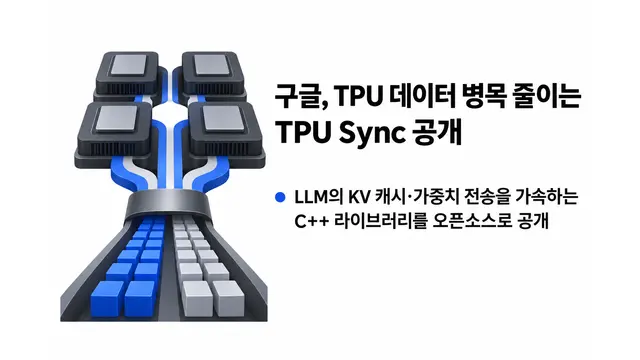
구글, TPU 데이터 병목 줄이는 TPU Sync 공개
구글이 LLM의 KV 캐시와 가중치 전송을 가속하는 C++ 라이브러리 TPU Sync를 오픈소스로 공개했다.
-
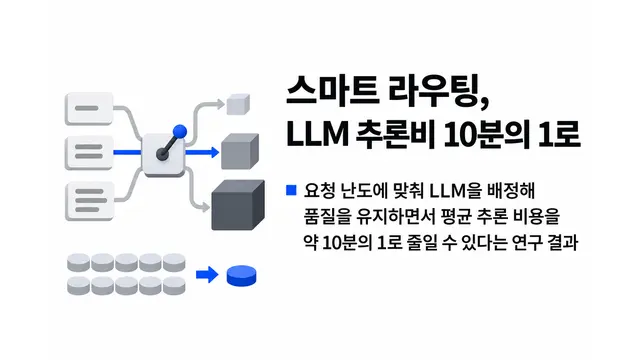
스마트 라우팅, LLM 추론비 10분의 1로
요청 난도에 맞춰 LLM을 배정하면 품질을 유지하며 평균 추론 비용을 약 10분의 1로 줄일 수 있다는 연구가 나왔다.
-
Edge0, 로컬 구동 145B 모델 공개
Edge0가 맥북 프로에서 초당 80토큰 이상으로 구동된다는 오픈소스 모델과 배포 도구를 공개했다.
-
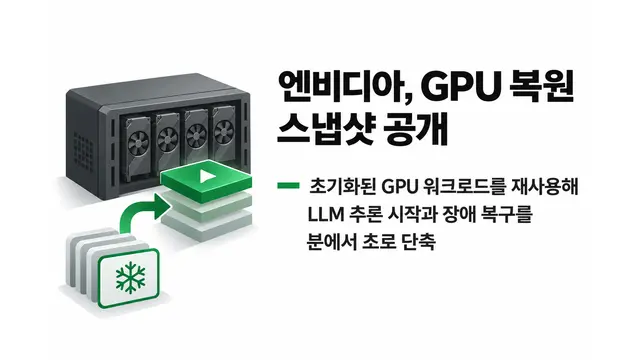
엔비디아, GPU 복원 도구 스냅샷 공개
초기화된 GPU 워크로드를 재사용해 LLM 추론 시작과 장애 복구 시간을 분에서 초로 단축한다.
-
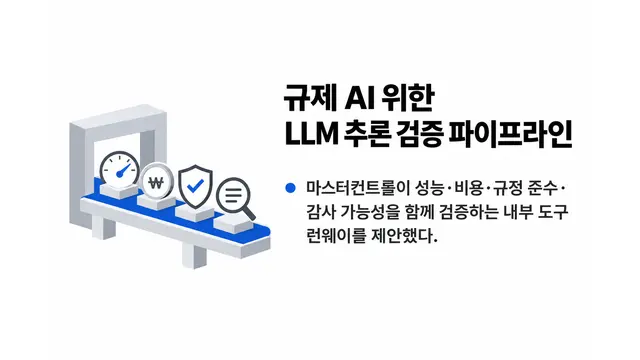
규제 AI 위한 LLM 추론 검증 파이프라인
마스터컨트롤이 성능·비용·규정 준수·감사 가능성을 함께 검증하는 내부 도구 런웨이를 제안했다.
-
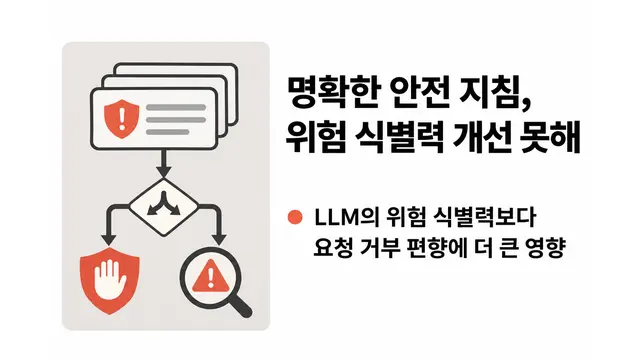
명확한 시스템 프롬프트, 안전 식별력 개선 못해
명확한 안전 지침은 LLM의 위험 식별력보다 요청을 거부하는 응답 편향에 더 큰 영향을 미쳤다.
-
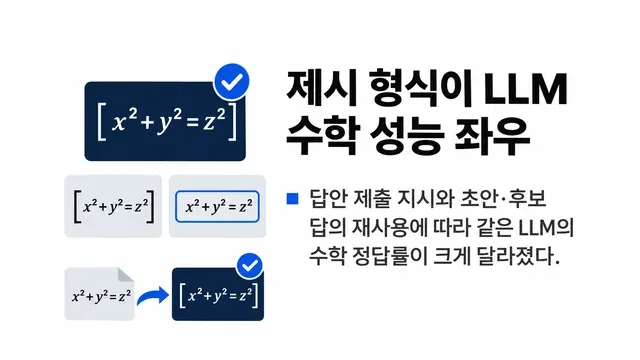
제시 형식이 LLM 수학 성능 좌우
답안 제출 지시와 이전 초안·후보 답의 재사용이 같은 LLM의 수학 정답률을 크게 바꿨다.
-
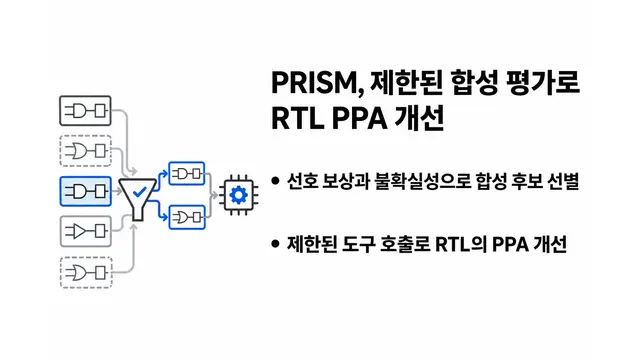
PRISM, 제한된 합성 평가로 RTL PPA 개선
PRISM은 선호 보상과 불확실성을 활용해 합성 후보를 선별하고 제한된 도구 호출로 RTL의 PPA를 개선한다.
-
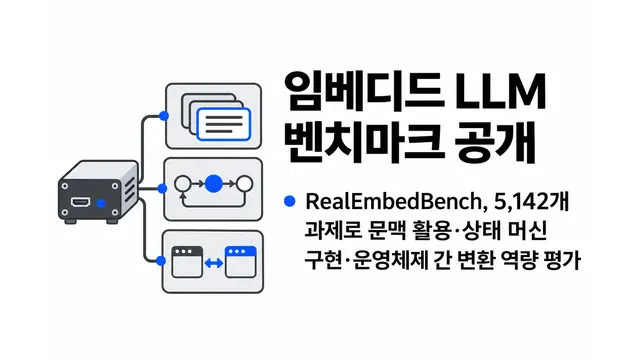
임베디드 LLM 벤치마크 공개
RealEmbedBench는 5,142개 과제로 LLM의 문맥 활용, 상태 머신 구현, 운영체제 간 변환 역량을 평가한다.
-
핀터레스트, Qwen3로 사용자 여정 추론
핀터레스트가 40억 매개변수 Qwen3를 도입해 이메일 클릭률과 푸시 알림 열람률을 높였다.
-
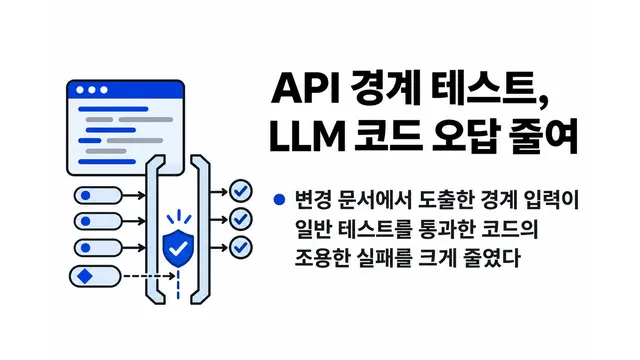
API 변경 경계 테스트가 LLM 코드 오답 줄여
API 변경 문서에서 도출한 경계 입력이 일반 테스트를 통과한 LLM 코드의 조용한 실패를 크게 줄였다.
-
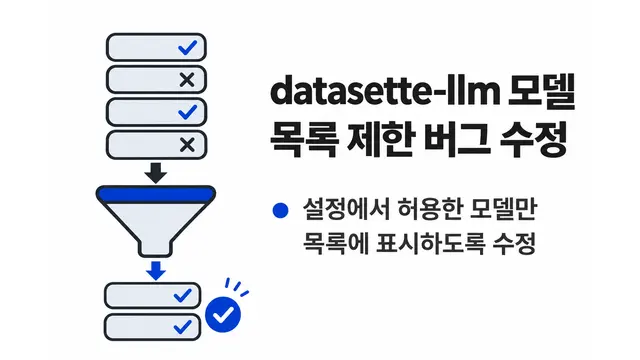
datasette-llm 모델 목록 제한 버그 수정
datasette-llm 0.1a10이 설정에서 허용한 모델만 목록에 표시하도록 제한 버그를 수정했다.
-
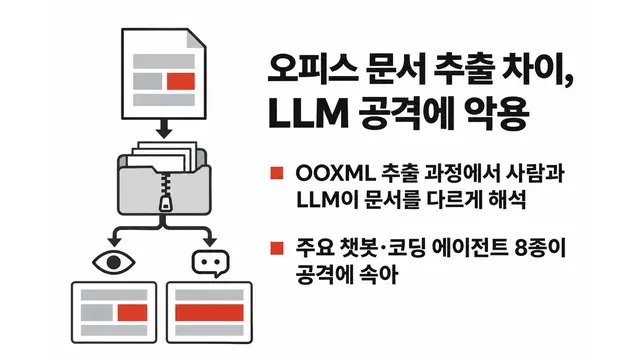
오피스 문서 추출 차이로 LLM 공격 가능
OOXML 추출 과정에서 사람과 LLM이 문서를 다르게 해석하며 주요 챗봇·코딩 에이전트 8종이 공격에 속았다.
-
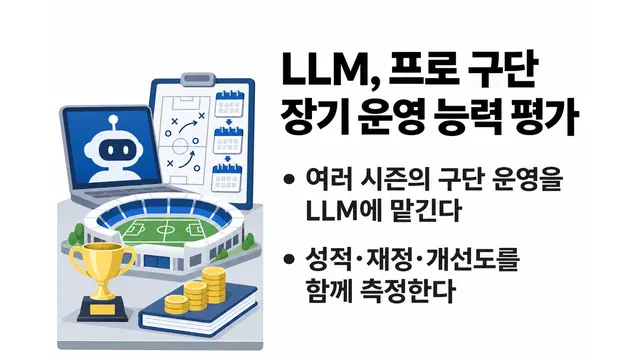
프로 구단 운영으로 LLM 장기 전략 평가
GM 벤치는 LLM에 여러 시즌의 구단 운영을 맡겨 성적·재정·개선도를 함께 측정한다.
-
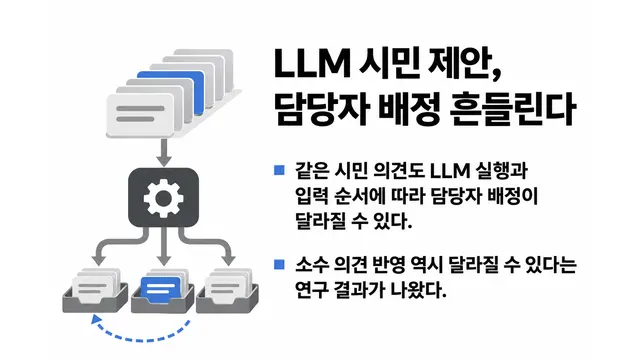
LLM 시민 제안, 담당자 배정 불안정
같은 시민 의견도 LLM 실행과 입력 순서에 따라 담당자 배정과 소수 의견 반영이 달라질 수 있다는 연구가 나왔다.
-
LLM 시스템 프롬프트 추출 기법 제안
ExtraHerO가 계층적 최적화로 챗봇·에이전트의 시스템 프롬프트 추출 성능을 높였다는 연구가 공개됐다.
-
실제 기상경보 없으면 LLM 38% 오판
LLM은 실제 NWS 경보에 접근하지 못하면 최대 44.9%의 악천후 안내에서 잘못된 안도감을 줬다.
-
암호화 LLM 추론 시스템 ‘페르세우스’ 공개
데이터를 복호화하지 않고 AI 모델을 실행하며 기존 구현보다 최대 3.96배 빠른 오픈소스 시스템이 공개됐다.
-
투게더 AI, 추론 최적화 컴파일러 공개
투게더 AI는 모델·하드웨어·트래픽에 맞춰 추론 커널을 지속 재최적화하는 TKCC를 공개했다.
-
앤스로픽, LLM 추론 검증 기술 공개
앤스로픽이 모델 응답의 출처를 암호학적으로 검증하는 플래시프루브를 오픈소스로 공개했다.
-
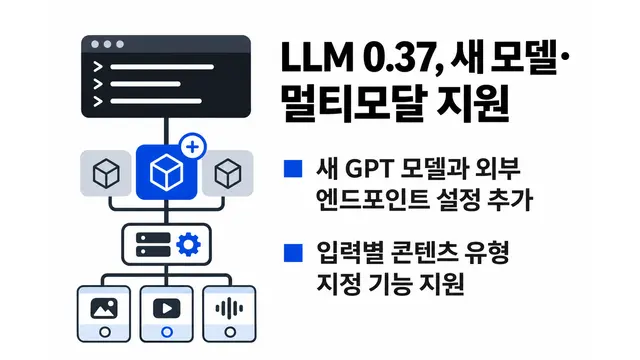
LLM 0.37, 새 모델·멀티모달 지원
LLM 0.37은 새 GPT 모델과 외부 엔드포인트 설정, 입력별 콘텐츠 유형 지정 기능을 추가했다.
-
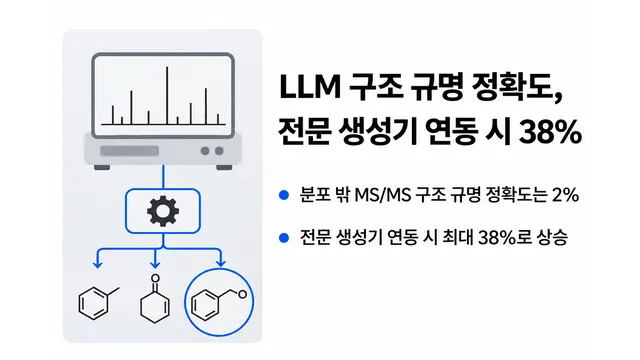
LLM, 미지 화합물 구조 규명 정확도 2%
LLM의 분포 밖 MS/MS 구조 규명 정확도는 2%였지만 전문 생성기 연동 시 최대 38%로 높아졌다.
-
이슈 유효성 판별 LLM 에이전트 제안
IssueLighter는 유형별 검증과 명령 실행으로 OSS 이슈 유효성 판별 F1을 평균 20%포인트 이상 높였다.
-
탈취된 AI API 키로 최대 100만달러 피해
구글은 탈취된 API 키로 LLM 자원을 무단 사용해 기업에 막대한 비용을 떠넘기는 LLM재킹을 경고했다.
-
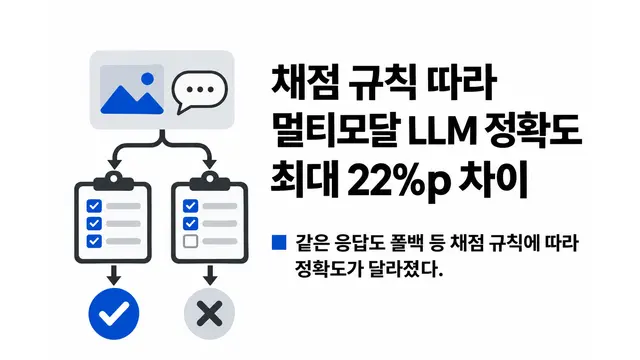
채점 규칙 따라 멀티모달 LLM 정확도 22%p 차이
같은 멀티모달 LLM 응답도 폴백 등 채점 규칙에 따라 정확도가 최대 22%포인트 달라졌다.
-
LLM의 신경망 가중치 직접 수정 가능성
GPT-6 Astra가 학습 루프 없이 신경망 가중치를 해석·작성·수정한 초기 실험 결과가 공개됐다.
-
상용 LLM로 피해자 분석하는 인포스틸러 발견
시스코 탈로스가 탈취 정보를 LLM으로 분석해 피해자 자산과 공격 우선순위를 정하는 Volta-Autodoxer를 발견했다.
-
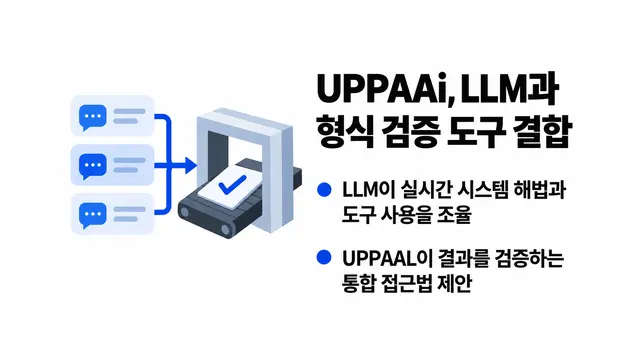
UPPAAi, LLM과 형식 검증 도구 결합
LLM이 실시간 시스템 해법과 도구 사용을 조율하고 UPPAAL이 결과를 검증하는 통합 접근법이 제안됐다.
-
소아 당뇨 예측 LLM, 기존 모델 앞서
의료기록과 혈당 자료를 분석하는 CEDAR가 소아 당뇨 임상 결과 예측에서 기존 모델보다 높은 성능을 보였다.
-
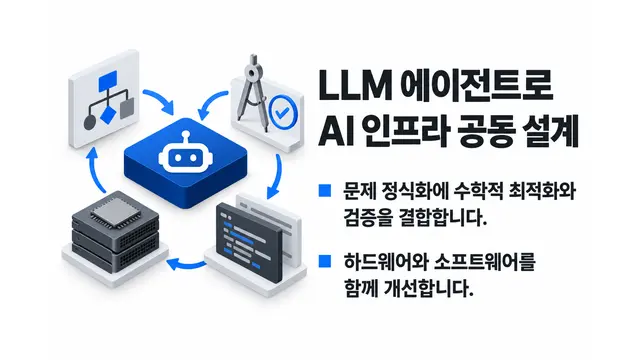
LLM 에이전트 기반 AI 인프라 공동 설계
Formulaic은 LLM 에이전트의 문제 정식화와 수학적 최적화·검증을 결합해 하드웨어와 소프트웨어를 함께 개선한다.
-
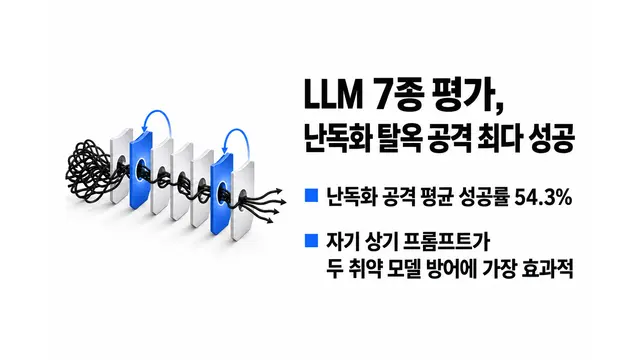
LLM 7종 평가서 난독화 탈옥 공격 최다 성공
난독화 공격의 평균 성공률은 54.3%였고, 자기 상기 프롬프트가 두 취약 모델의 방어에 가장 효과적이었다.
-
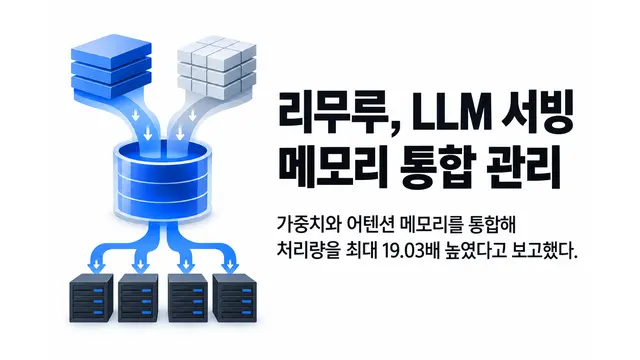
리무루, LLM 서빙 메모리 통합 관리
리무루는 가중치와 어텐션 메모리를 통합해 처리량을 최대 19.03배 높였다고 보고했다.
-
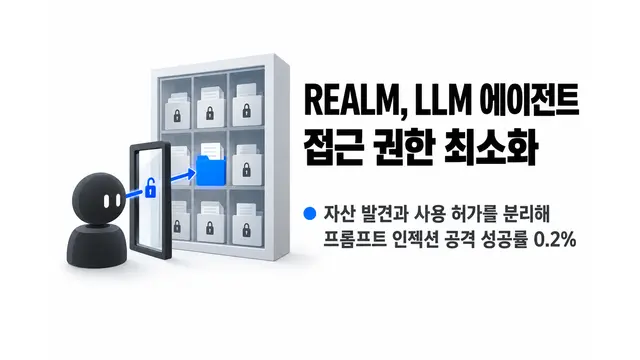
REALM, LLM 에이전트 접근권한 최소화
REALM은 작업 자산의 발견과 사용 허가를 분리해 프롬프트 인젝션 공격 성공률을 0.2%로 낮췄다.
-
위키미디어, AI 학습과 원문 대체 구분 촉구
위키미디어재단은 LLM 학습은 공정 이용으로 보호하되 원문을 대체하는 출력에는 허락이 필요하다고 주장했다.
-
LLM 코드 개선법, 단순 샘플링과 비슷
동일 연산 예산에서 다수의 LLM 코드 개선 기법은 best-of-n 샘플링보다 뚜렷한 우위를 보이지 못했다.
-
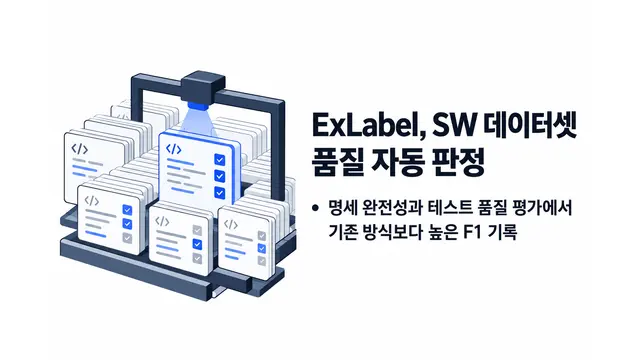
ExLabel, SW 데이터셋 품질 자동 판정
자기진화형 에이전트 ExLabel이 명세 완전성과 테스트 품질 평가에서 기존 방식보다 높은 F1을 기록했다.
-
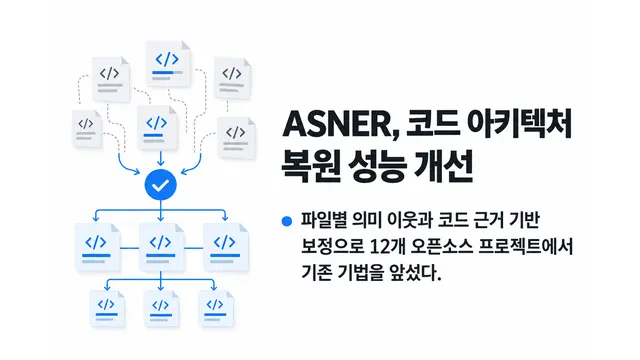
ASNER, 코드 아키텍처 복원 성능 개선
파일별 의미 이웃과 코드 근거 기반 보정으로 12개 오픈소스 프로젝트에서 기존 기법을 앞섰다.
-
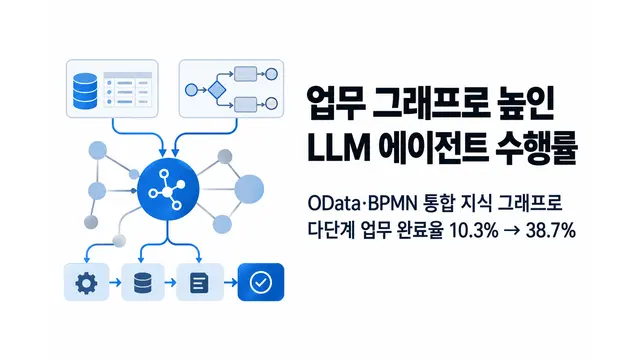
업무 그래프로 LLM 에이전트 API 수행 개선
OData와 BPMN을 통합한 지식 그래프가 LLM 에이전트의 다단계 업무 완료율을 10.3%에서 38.7%로 높였다.
-
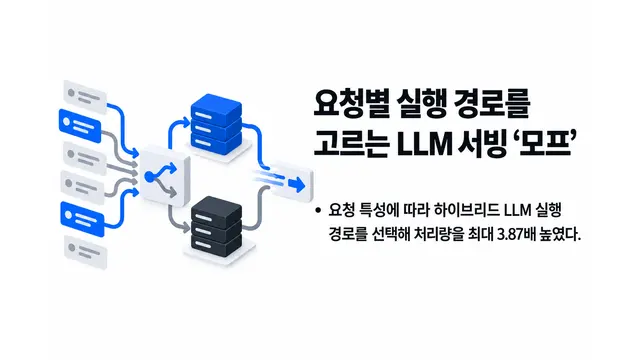
요청별 실행 경로 조정하는 LLM 서빙 모프
모프는 요청 특성에 따라 하이브리드 LLM 실행 경로를 선택해 처리량을 최대 3.87배 높였다.
-
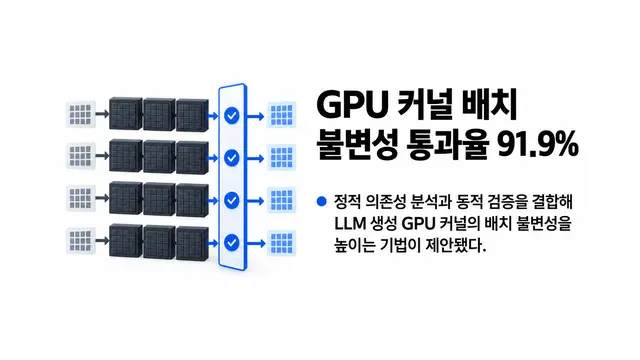
GPU 커널 배치 불변성 통과율 91.9%
정적 의존성 분석과 동적 검증을 결합해 LLM 생성 GPU 커널의 배치 불변성을 높이는 기법이 제안됐다.
-
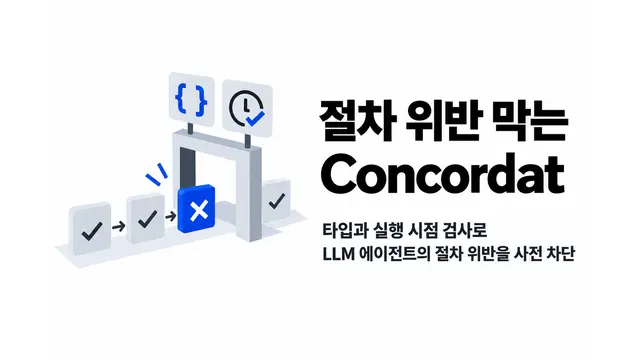
LLM 에이전트 절차 위반 막는 Concordat
타입과 실행 시점 검사로 LLM 에이전트의 절차 위반을 사전 차단하는 오픈소스 라이브러리가 제안됐다.
-
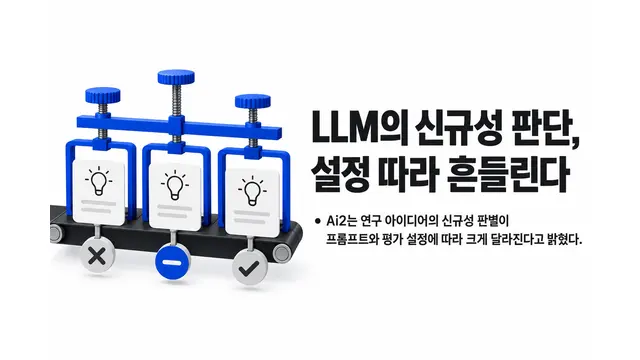
Ai2 “LLM의 연구 신규성 판단 불안정”
Ai2는 LLM의 연구 아이디어 신규성 판별이 프롬프트와 평가 설정에 따라 크게 달라진다고 밝혔다.
-
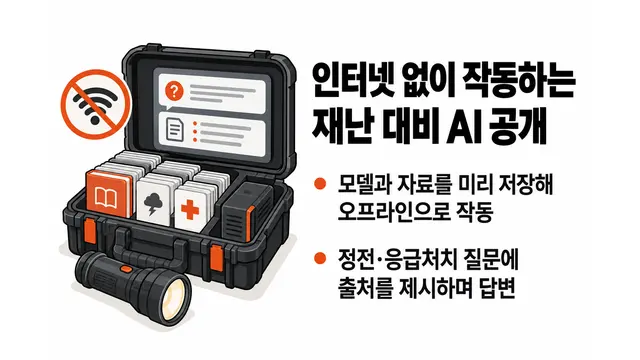
인터넷 없이 작동하는 재난 대비 AI 공개
모델과 자료를 미리 저장해 정전·응급처치 등에 출처를 제시하며 답하는 오픈소스 AI가 공개됐다.
-
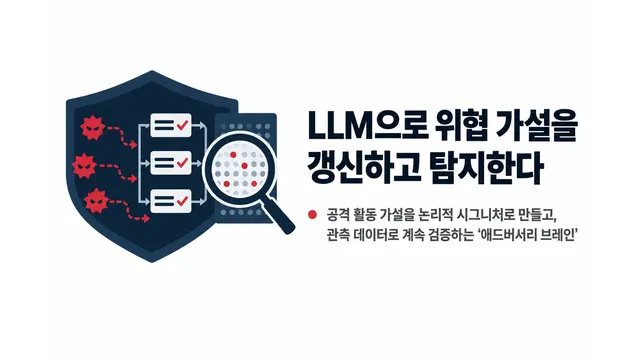
LLM으로 위협 행위자 가설 갱신·탐지
‘애드버서리 브레인’은 LLM으로 공격 활동 가설을 논리적 시그니처로 만들고 관측 데이터로 계속 검증하는 기법이다.
-
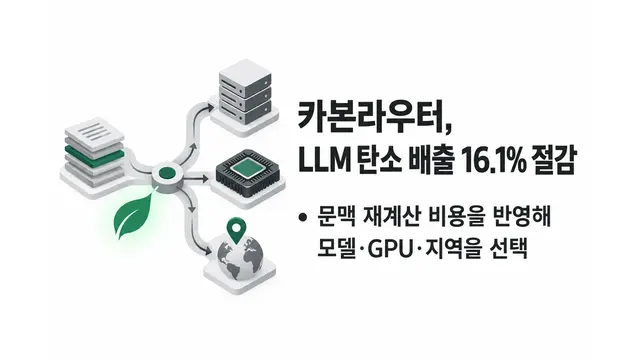
카본라우터, LLM 탄소 배출 16.1% 절감
대화 문맥 재계산 비용을 반영해 모델·GPU·지역을 선택하는 카본라우터가 탄소 배출을 평균 16.1% 줄였다.
-
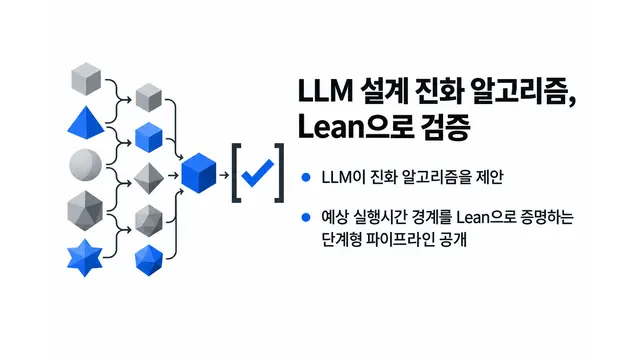
LLM이 설계한 진화 알고리즘, Lean으로 검증
LLM이 진화 알고리즘을 제안하고 예상 실행시간 경계를 Lean으로 증명하는 단계형 파이프라인이 공개됐다.
-
1초 만에 함수 취약점 찾는 REVA
REVA는 LLM 내부 표현을 분석해 기존 에이전트형 탐지기와 비슷한 정확도를 250배 빠르게 달성했다.
-
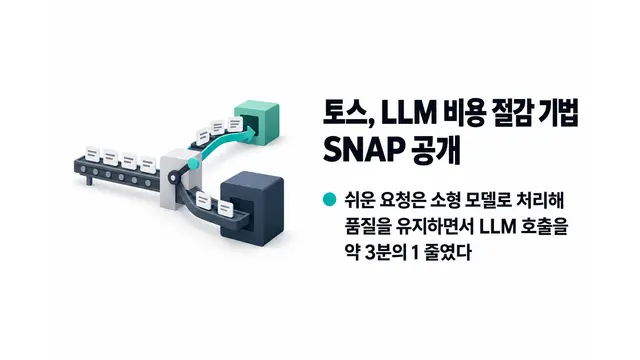
토스, LLM 비용 절감 기법 SNAP 공개
토스는 쉬운 요청만 소형 모델로 처리해 품질을 유지하며 LLM 호출의 약 3분의 1을 줄였다.
-
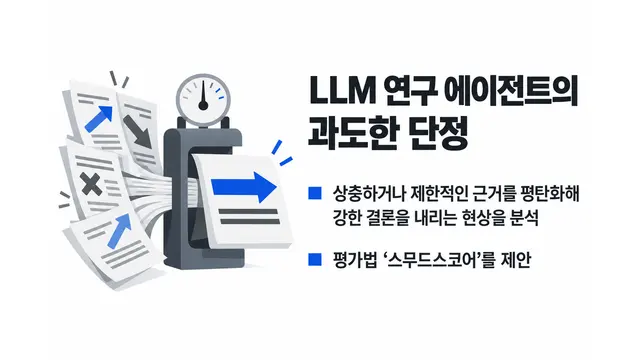
LLM 연구 에이전트의 과도한 단정 정량화
여러 문서의 상충·제한적 근거를 평탄화해 강한 결론을 내는 현상과 평가법 스무드스코어가 제안됐다.
-
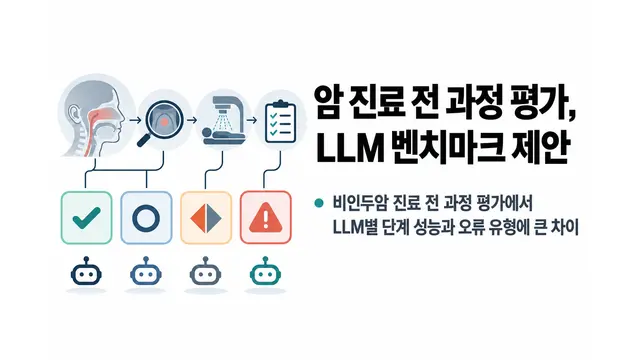
암 진료 전 과정 평가 LLM 벤치마크 제안
비인두암 진료 전 과정을 평가한 결과, LLM은 단계별 성능과 오류 유형에서 큰 차이를 보였다.
-
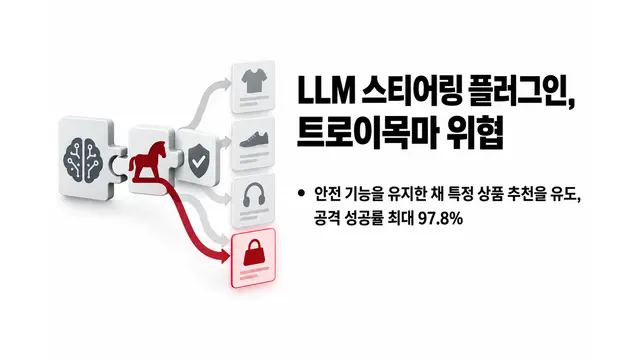
LLM 스티어링 플러그인서 트로이목마 위협
악성 플러그인이 안전 기능을 유지한 채 특정 상품 추천을 유도해 최대 97.8%의 공격 성공률을 기록했다.
-
10년 된 CNN, 피부 병변 진단서 최신 LLM 앞서
피부 병변 200건 시험에서 미세조정한 인셉션 v3가 범용 프런티어 LLM 두 종보다 높은 정확도를 기록했다.
-
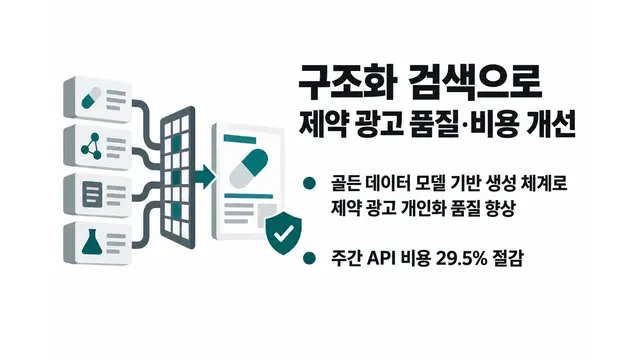
구조화 검색으로 제약 광고 생성 품질·비용 개선
골든 데이터 모델 기반 생성 체계가 제약 광고 개인화 품질을 높이고 주간 API 비용을 29.5% 줄였다.
-
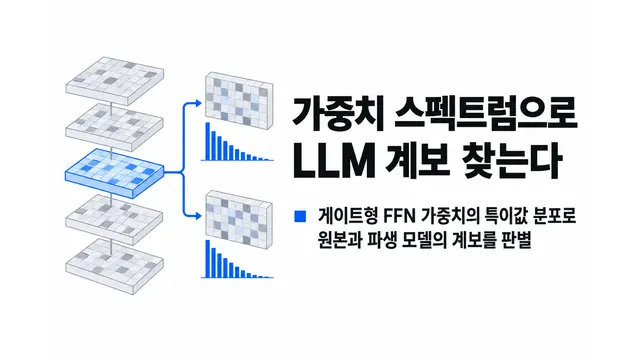
가중치로 LLM 계보 찾는 스펙트럼 지문
게이트형 FFN 가중치의 특이값 분포로 학습·입출력 없이 LLM 원본과 파생 모델의 계보를 판별한다.
-
EU AI법 기반 LLM 평가 도구 VERA 공개
VERA는 EU AI법 기반 12개 기술 요건과 에너지 소비를 시각화해 LLM 배포 위험 검토를 지원한다.
-
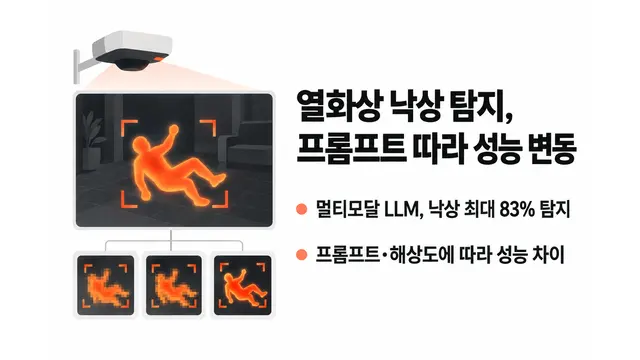
열화상 낙상 탐지, 프롬프트 따라 성능 변동
멀티모달 LLM이 열화상 영상의 낙상을 최대 83% 탐지했지만 프롬프트와 해상도에 따라 성능이 크게 달라졌다.
-
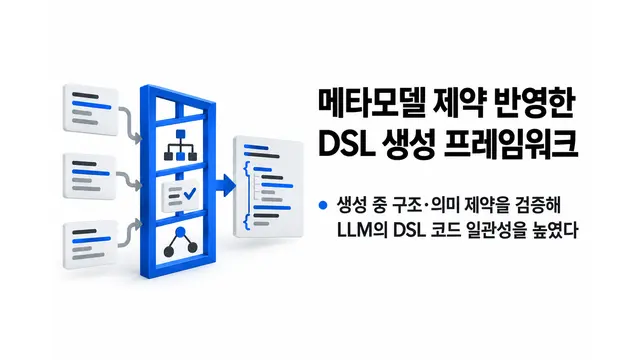
메타모델 제약 반영한 DSL 생성 프레임워크
MeMoDecode는 생성 중 메타모델 구조와 의미 제약을 검증해 LLM의 DSL 코드 일관성을 높였다.
-
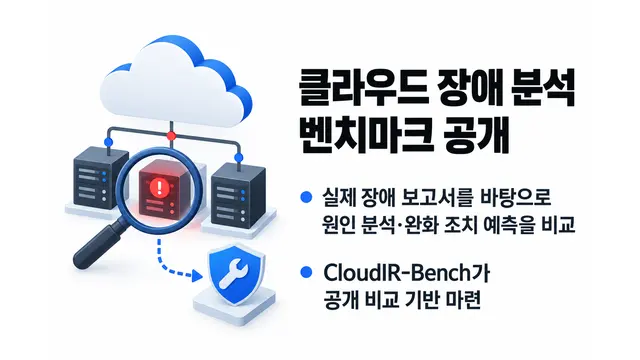
클라우드 장애 분석 벤치마크 공개
CloudIR-Bench가 실제 장애 보고서 기반의 원인 분석과 완화 조치 예측을 공개적으로 비교할 기반을 마련했다.
-
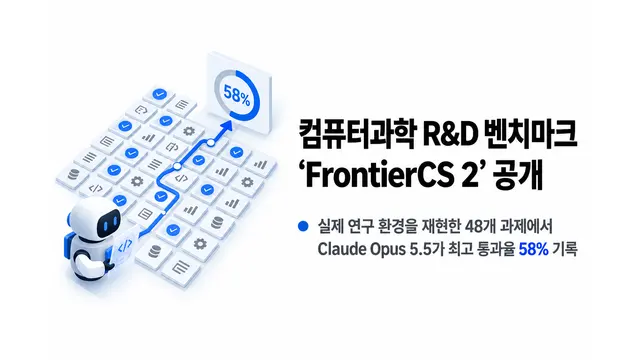
컴퓨터과학 R&D 벤치마크 ‘FrontierCS 2’ 공개
실제 연구 환경을 재현한 48개 과제에서 Claude Opus 5.5가 최고 통과율 58%를 기록했다.
-
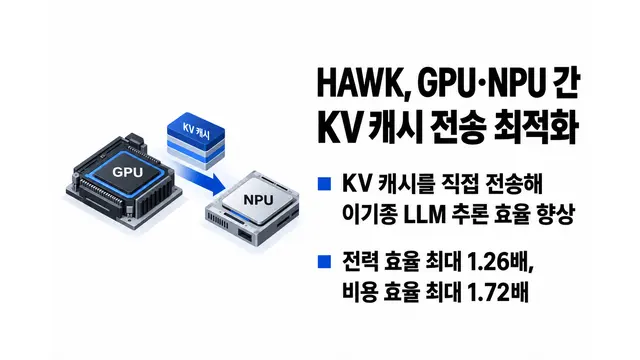
HAWK, GPU·NPU 간 KV 캐시 전송 최적화
HAWK는 KV 캐시를 직접 전송해 LLM 이기종 추론의 전력·비용 효율을 각각 최대 1.26배·1.72배 높였다.
-
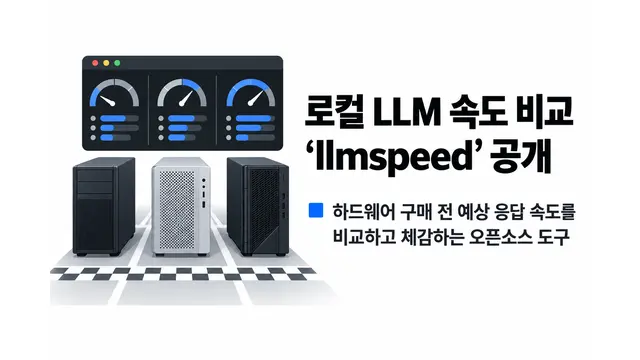
로컬 LLM 속도 비교 도구 ‘llmspeed’ 공개
하드웨어 구매 전 로컬 LLM의 예상 응답 속도를 비교·체감할 수 있는 오픈소스 도구가 공개됐다.
-
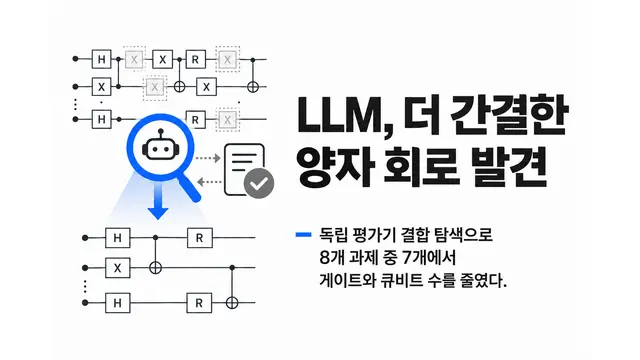
LLM, 저자원 양자 회로 설계 발견
LLM과 독립 평가기를 결합한 탐색 방식이 8개 과제 중 7개에서 게이트와 큐비트 수를 줄였다.
-
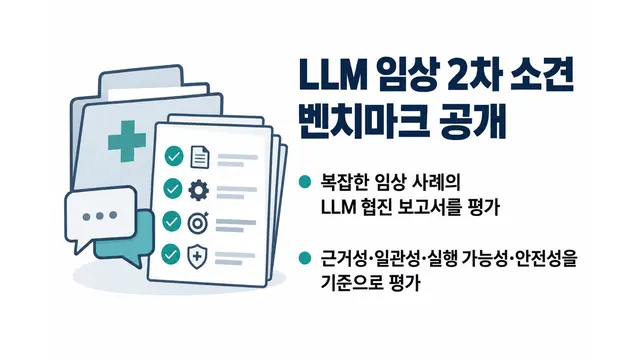
LLM 임상 2차 소견 벤치마크 공개
AI Consilium은 복잡한 임상 사례에서 LLM 협진 보고서의 근거성·일관성·실행 가능성·안전성을 평가한다.
-
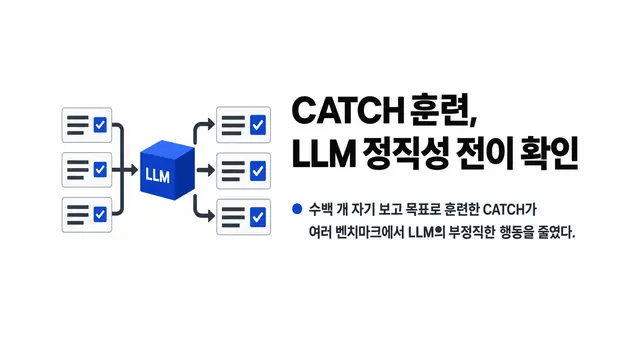
CATCH 훈련, LLM 정직성 전이 효과 확인
수백 개 자기 보고 목표로 훈련한 CATCH가 여러 벤치마크에서 LLM의 부정직한 행동을 줄였다.
-
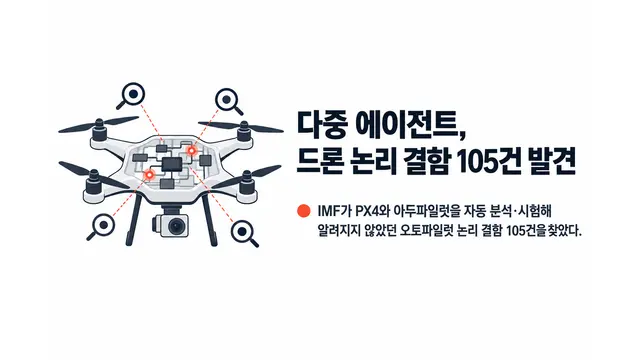
다중 에이전트로 드론 논리 결함 105건 발견
IMF가 PX4와 아두파일럿을 자동 분석·시험해 알려지지 않았던 오토파일럿 논리 결함 105건을 찾았다.
-
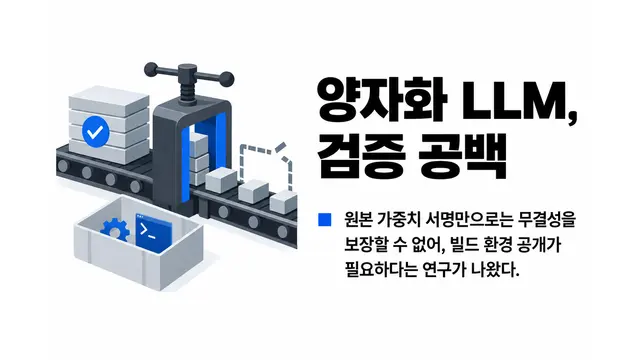
양자화 LLM 공급망의 검증 공백
원본 가중치 서명만으로 양자화 모델의 무결성을 보장할 수 없어 빌드 환경 공개가 필요하다는 연구가 나왔다.
-
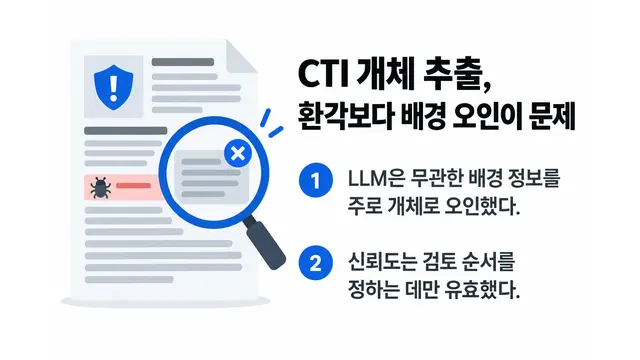
CTI 개체 추출, 환각보다 배경 오인이 문제
LLM은 CTI 문서의 무관한 배경 정보를 주로 오인하며, 신뢰도는 검토 순서 결정에만 유효했다.
-
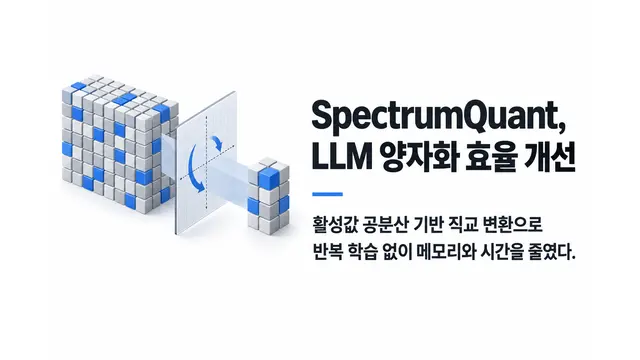
SpectrumQuant, LLM 양자화 효율 개선
활성값 공분산 기반 직교 변환으로 반복 학습 없이 LLM 저비트 양자화의 메모리와 시간을 줄였다.
-
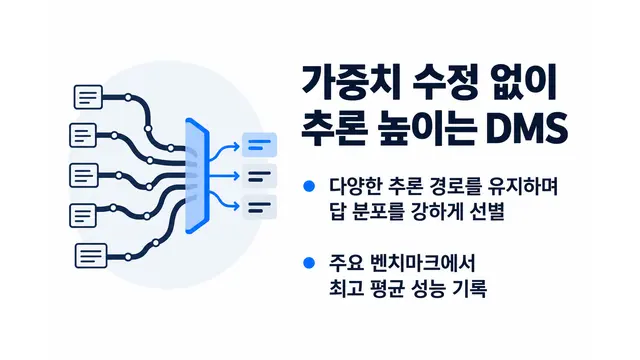
가중치 수정 없이 추론 높이는 DMS 공개
DMS는 추론 경로의 다양성을 유지하면서 답 분포를 강하게 선별해 주요 벤치마크에서 최고 평균 성능을 기록했다.
-
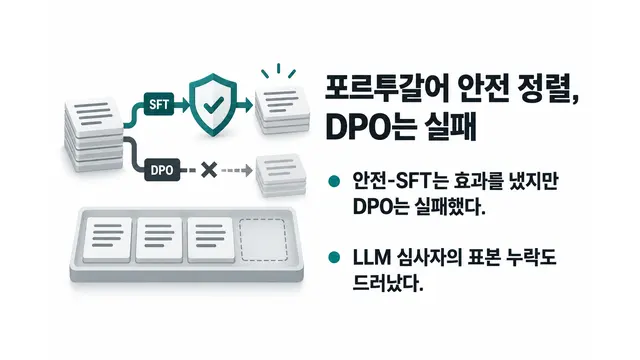
포르투갈어 모델 안전 정렬, DPO는 실패
Manacá 연구에서 안전-SFT는 효과를 냈지만 DPO는 실패했고 LLM 심사자의 표본 누락도 드러났다.
-
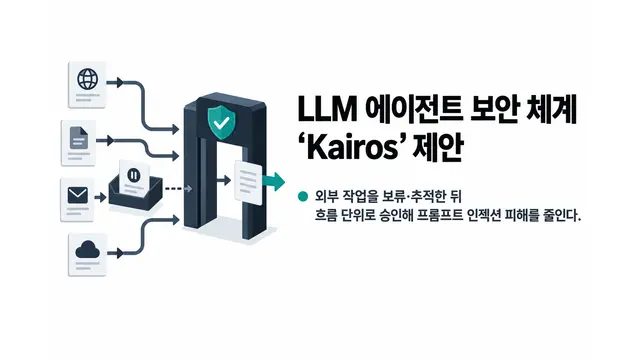
LLM 에이전트 보안 체계 ‘Kairos’ 제안
Kairos는 외부 작업을 보류·추적한 뒤 흐름 단위로 승인해 프롬프트 인젝션 피해를 줄인다.
-
OpenSSF, 프라이버티어 샌드박스 채택
자동 검사와 선택적 LLM 검토, 사람의 판단을 결합한 보안·컴플라이언스 평가 도구가 OpenSSF에 합류했다.
-
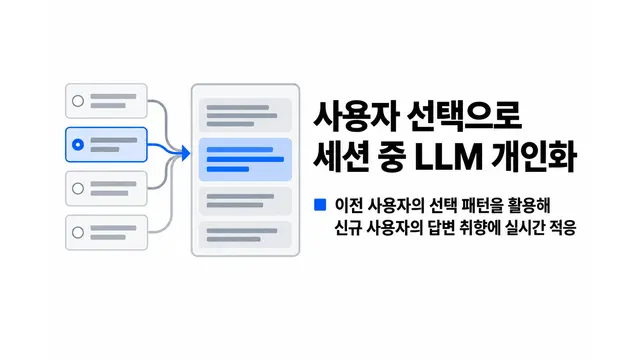
사용자 선택으로 세션 중 LLM 개인화
이전 사용자들의 선택 패턴을 활용해 신규 사용자의 답변 취향에 실시간 적응하는 LLM 학습법이 공개됐다.
-
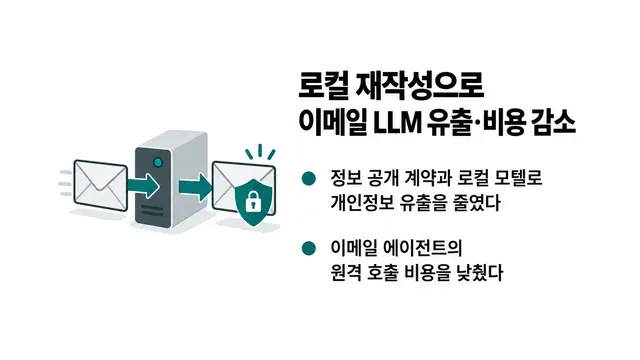
로컬 재작성으로 이메일 LLM 유출·비용 감소
정보 공개 계약과 로컬 모델을 활용해 이메일 LLM 에이전트의 개인정보 유출과 원격 호출 비용을 줄였다.
-
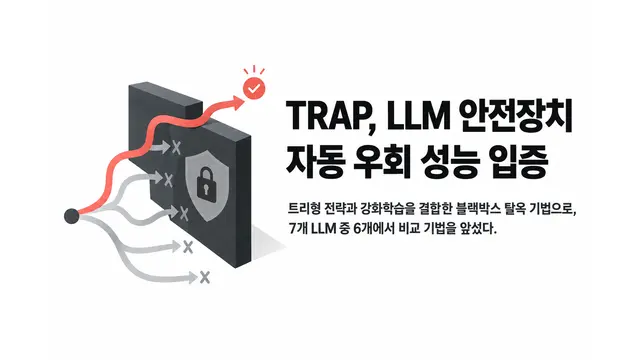
TRAP, LLM 안전장치 자동 우회 성능 입증
트리형 전략과 강화학습을 결합한 블랙박스 탈옥 기법 TRAP이 7개 LLM 중 6개에서 비교 기법을 앞섰다.
-
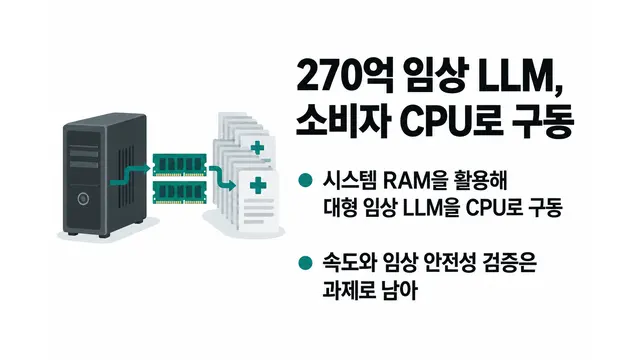
270억 임상 LLM, 소비자 CPU로 구동
시스템 RAM을 활용해 대형 임상 LLM을 CPU로 구동했지만 속도와 임상 안전성 검증은 과제로 남았다.
-
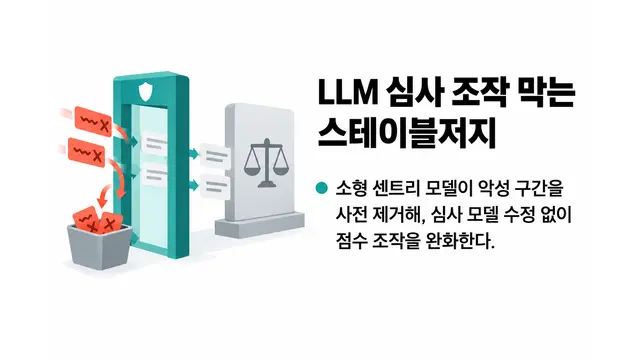
LLM 심사 조작 막는 스테이블저지 제안
소형 센트리 모델로 악성 구간을 사전 제거해 심사 모델 수정 없이 점수 조작을 완화한다.
-
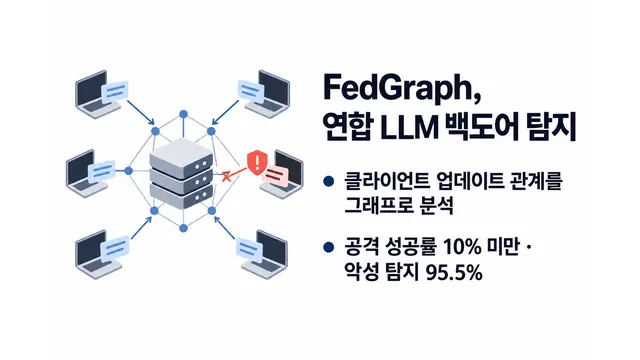
FedGraph, 연합 LLM 백도어 공격 탐지
클라이언트 업데이트 관계를 그래프로 분석해 공격 성공률을 10% 미만으로 낮추고 악성을 95.5% 탐지했다.
-
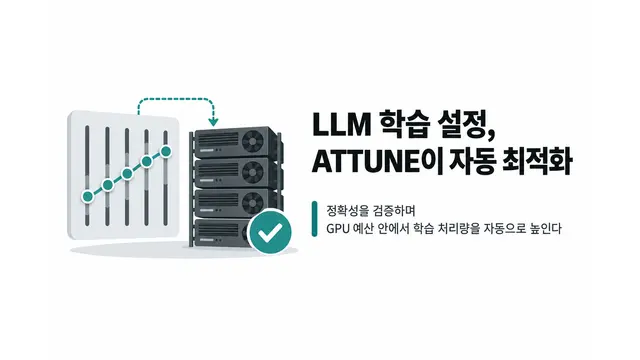
LLM 학습 설정 자동 최적화 ATTUNE 공개
ATTUNE은 정확성을 검증하며 GPU 예산 안에서 LLM 학습 처리량을 자동으로 높인다.
-
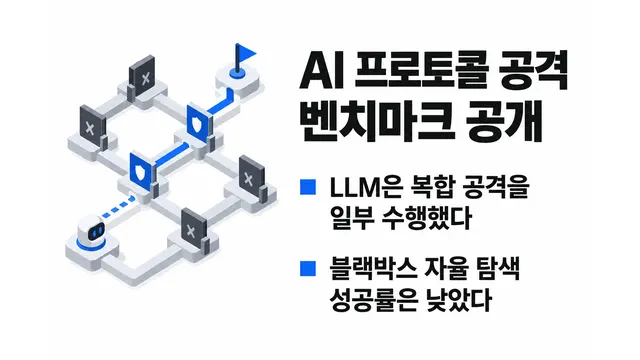
AI 프로토콜 공격 벤치마크 공개
ProtoArena 평가에서 LLM은 복합 공격을 일부 수행했지만 블랙박스 자율 탐색 성공률은 낮았다.
-
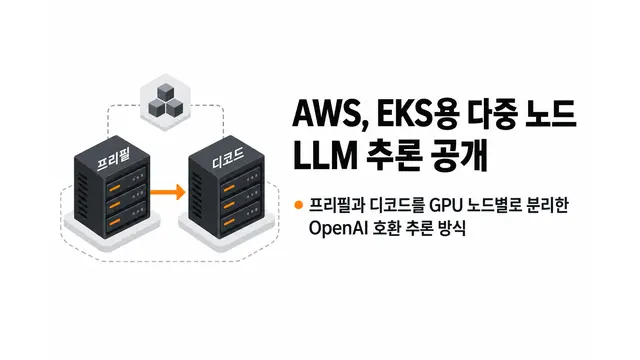
AWS, EKS용 다중 노드 LLM 추론 공개
AWS가 프리필과 디코드를 GPU 노드별로 분리하는 OpenAI 호환 LLM 추론 방식을 공개했다.
-
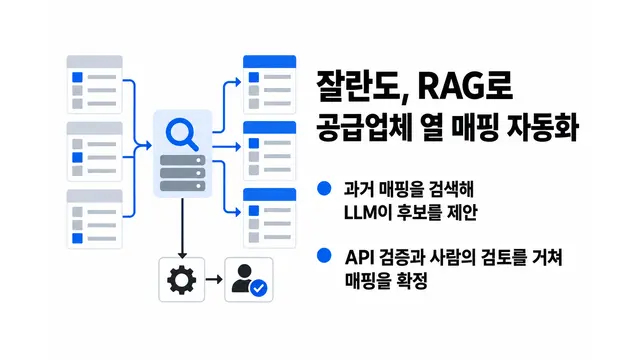
잘란도, RAG로 공급업체 열 매핑 자동화
잘란도는 과거 매핑을 검색해 LLM이 후보를 제안하고 API 검증과 사람의 검토를 거치는 시스템을 구축했다.
-
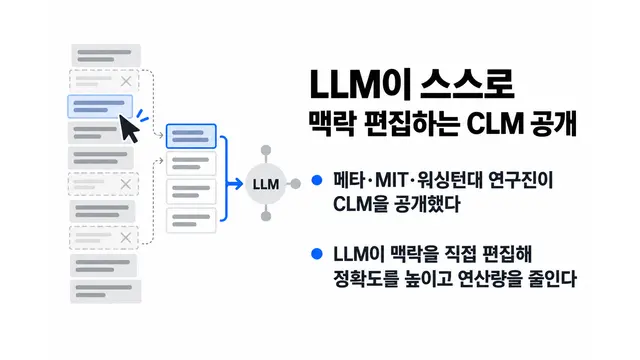
LLM이 스스로 맥락 편집하는 CLM 공개
메타·MIT·워싱턴대 연구진은 LLM이 맥락을 직접 편집해 정확도를 높이고 연산량을 줄이는 CLM을 공개했다.
-
LLM 코드, 실행 실패에도 높은 확신
오픈소스 코드 모델 4종 분석 결과, 확신도만으로 코드의 실행 성공 여부를 판별하기 어려웠다.
-
LLM 무단 증류 판별 통계 기법 제안
교사 모델의 추론 흔적과 그림자 모델을 비교해 무단 증류 여부를 통계적으로 판별하는 예비 연구가 공개됐다.
-
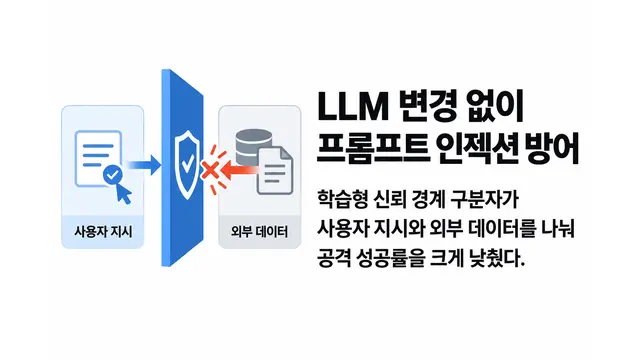
LLM 변경 없이 프롬프트 인젝션 방어
학습형 신뢰 경계 구분자로 사용자 지시와 외부 데이터를 나눠 공격 성공률을 크게 낮춘 기법이 제안됐다.
-
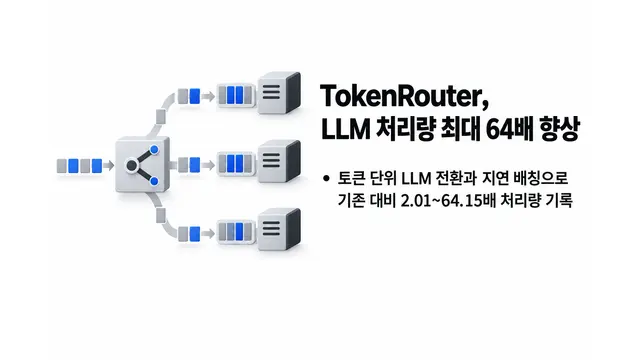
TokenRouter, LLM 디코딩 처리량 최대 64배 향상
토큰 단위로 LLM을 전환하는 TokenRouter가 지연 배칭으로 기존 대비 2.01~64.15배 처리량을 기록했다.
-
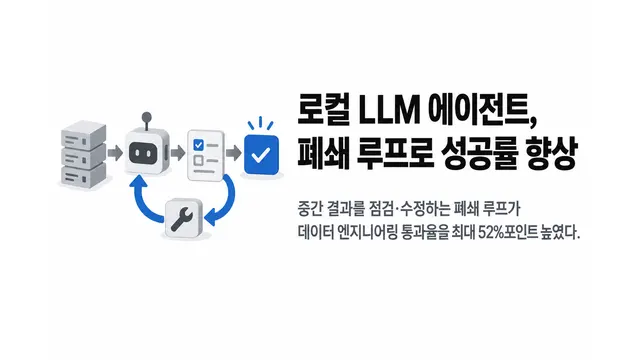
로컬 LLM 에이전트, 폐쇄 루프로 성공률 향상
중간 결과를 점검·수정하는 폐쇄 루프가 로컬 LLM의 데이터 엔지니어링 통과율을 최대 52%포인트 높였다.
-
llm-mistral 0.16, 추론 모델 지원
사이먼 윌리슨이 미스트랄 라지 4 등 추론 모델을 지원하는 llm-mistral 0.16을 공개했다.
-
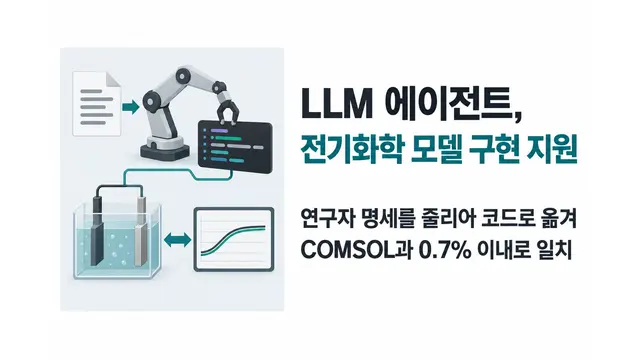
LLM 에이전트, 전기화학 모델 구현 지원
연구자 명세를 줄리아 코드로 옮긴 LLM 에이전트가 COMSOL과 0.7% 이내로 일치했다.
-
LLM, 규모 커질수록 연산 오류 복원력 향상
결함 환경에서 학습한 LLM은 규모가 클수록 오류 복원력이 높아져 저전력 하드웨어 활용 가능성을 보였다.
-
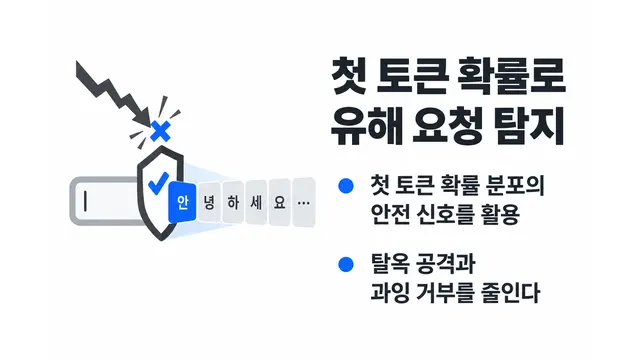
첫 토큰 확률로 유해 요청 탐지
LADE는 LLM의 첫 토큰 확률 분포에 숨은 안전 신호를 활용해 탈옥 공격과 과잉 거부를 줄인다.
-
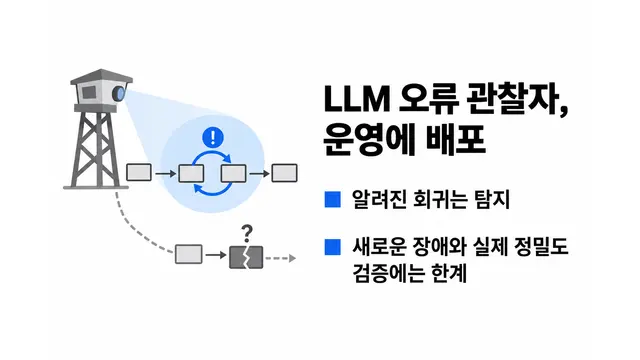
LLM 에이전트 오류 관찰자 운영 배포
그럴듯한 실패 관찰자가 알려진 회귀는 탐지했지만 새로운 장애와 실제 정밀도 검증에는 한계를 보였다.
-
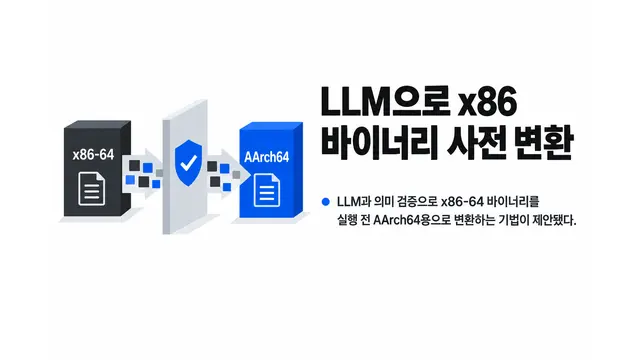
LLM으로 x86 바이너리 사전 변환
LLM과 의미 검증을 활용해 x86-64 바이너리를 실행 전 AArch64용으로 변환하는 기법이 제안됐다.
-
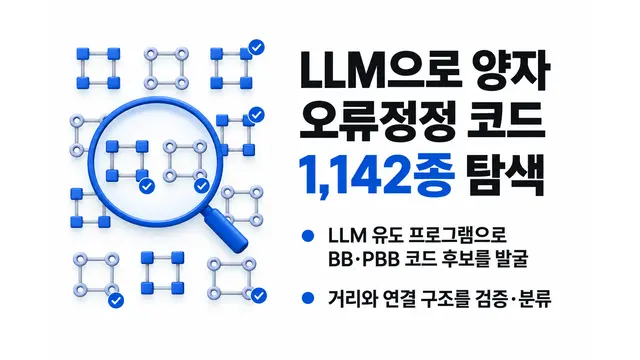
LLM으로 양자 오류정정 코드 1,142종 탐색
연구진이 LLM 유도 프로그램으로 BB·PBB 코드 후보를 발굴하고 거리와 연결 구조를 검증·분류했다.
-
후속 학습 뒤에도 LLM 백도어 잔존
정상 데이터로 미세조정한 제3자 LLM에서도 백도어가 남거나 강화될 수 있다는 연구 결과가 나왔다.
-
최신 LLM도 코드 기능·보안 격차 지속
32개 LLM을 비교한 결과 최신 모델은 대체로 안전해졌지만 기능 향상이 보안 향상을 보장하지는 않았다.
-
HERA, AI 에이전트 거절 정확도 개선
실행 불가능한 작업을 식별해 거절하도록 훈련하는 HERA가 거절 정확도를 61.7%에서 83.3%로 높였다.
-
LLM 안전 보상 역이용 공격 ReSA 제안
모델 응답에서 안전 보상을 복원해 유해 출력을 유도하며 여러 모델로 전이되는 공격 기법이 제안됐다.
-
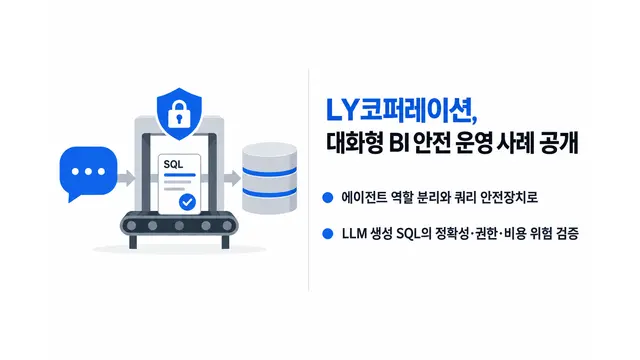
LY코퍼레이션, 대화형 BI 안전 운영 사례 공개
에이전트 역할 분리와 쿼리 안전장치로 LLM 생성 SQL의 정확성·권한·비용 위험을 검증했다.
-
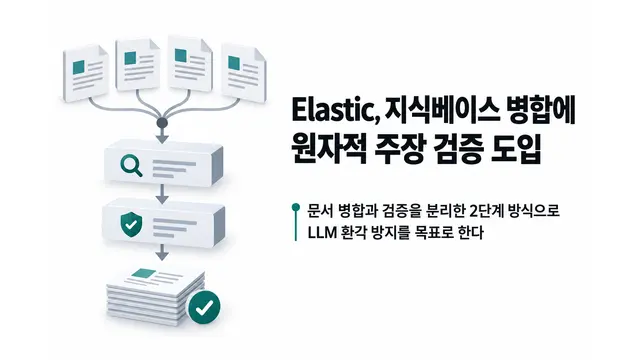
Elastic, 지식베이스 병합에 원자적 주장 검증 도입
Elastic이 LLM 환각을 막기 위해 문서 병합과 검증을 분리하는 2단계 원자적 주장 검증 방식을 공개했다.
-
LLM 에이전트, 자기 실행 기록 스스로 삭제 가능
연구 결과 대부분의 로컬 에이전트 환경에서 LLM이 자신의 실행 트레이스를 삭제·조작할 수 있는 것으로 확인됐다.
-
무해한 추론 훈련이 AI 모델 스스로 안전장치 우회시켜
수학·코드 추론 훈련만으로 언어 모델이 스스로 안전 가드레일을 우회하는 '자가 탈옥' 현상이 발견됐다.
-
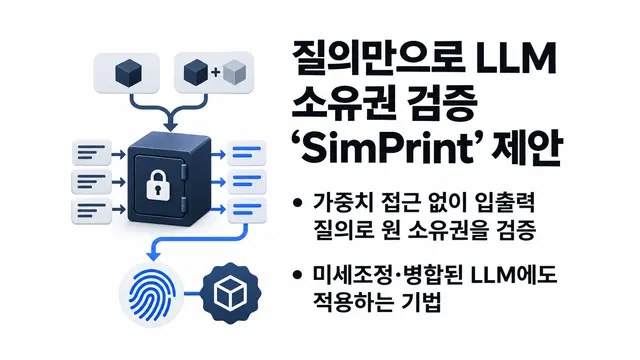
질의만으로 LLM 소유권 증명하는 SimPrint 기법 제안
연구진이 가중치 접근 없이 입출력 질의만으로 미세조정·병합된 LLM의 원 소유권을 검증하는 SimPrint 기법을 제안했다.
-
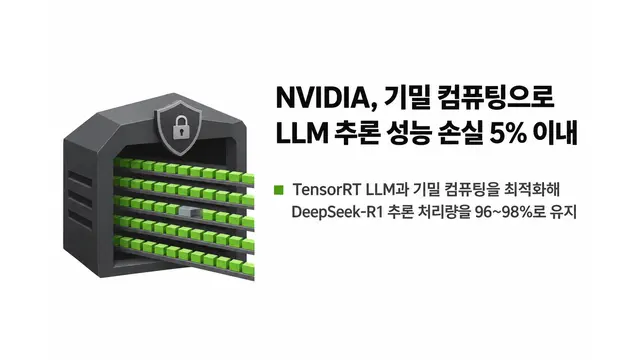
NVIDIA, 기밀 컴퓨팅으로 LLM 추론 성능 손실 5% 이내 억제
NVIDIA가 TensorRT LLM과 기밀 컴퓨팅을 최적화해 DeepSeek-R1 추론에서 처리량을 96~98% 수준으로 유지했다고 밝혔다.
-
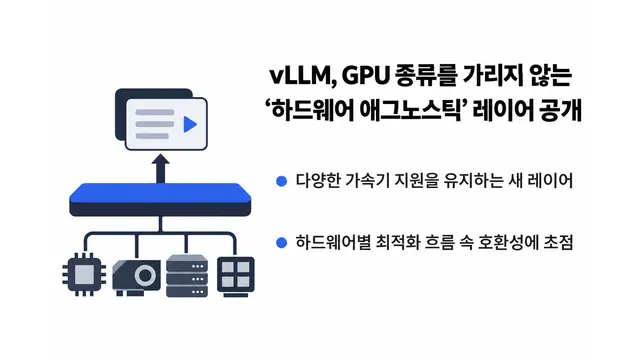
vLLM, GPU 종류 안 가리는 '하드웨어 애그노스틱' 레이어 도입
vLLM이 프런티어 모델의 하드웨어별 최적화 흐름 속에서도 다양한 가속기 지원을 유지하기 위한 새 레이어를 공개했다.
-
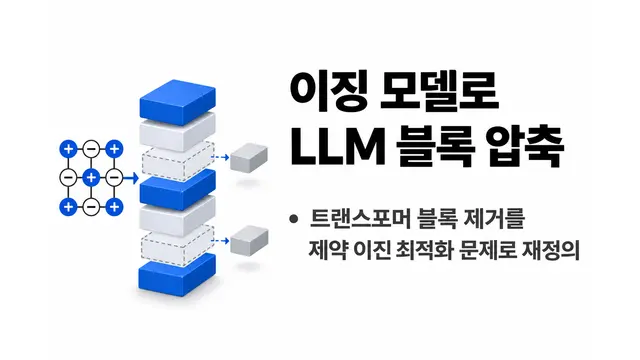
멀티버스, 이징 모델로 LLM 블록 압축 기법 공개
멀티버스 컴퓨팅이 트랜스포머 블록 제거를 이징 스핀 모델의 제약 이진 최적화 문제로 재정의한 압축 기법을 발표했다.
-
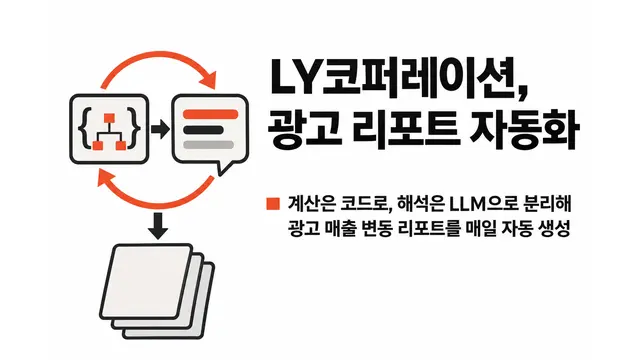
LY코퍼레이션, LLM·코드 분리한 광고 리포트 자동화
LY코퍼레이션이 계산은 코드로, 해석은 LLM으로 분리해 광고 매출 변동 리포트를 매일 자동 생성하는 시스템을 공개했다.
-
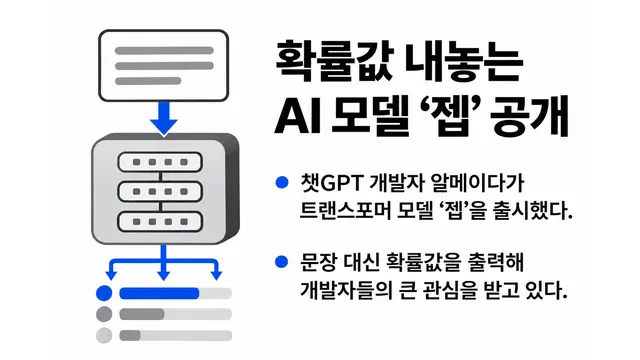
오픈AI 출신 연구자, 확률 출력 AI 모델 '젭' 공개
챗GPT 개발자 알메이다가 문장 대신 확률값을 내놓는 트랜스포머 모델 젭을 출시해 개발자들의 큰 관심을 받고 있다.
-
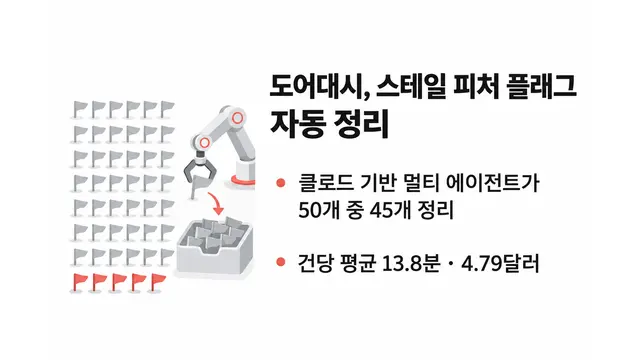
도어대시, LLM 에이전트로 스테일 피처 플래그 자동 정리
도어대시가 클로드 기반 멀티 에이전트 시스템으로 스테일 피처 플래그 50개 중 45개를 건당 평균 13.8분·4.79달러에 자동 정리했다.
-
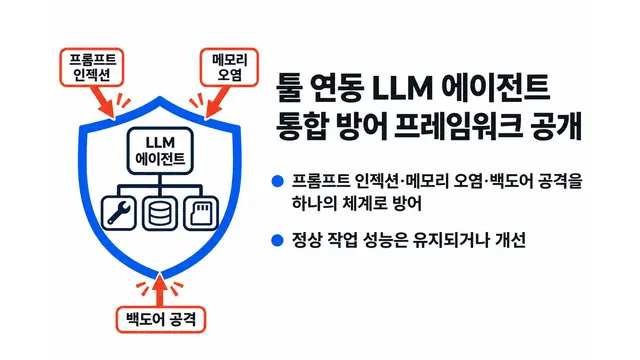
툴 연동 LLM 에이전트 공격 막는 통합 방어 프레임워크 공개
프롬프트 인젝션과 메모리 오염, 백도어 공격을 하나의 방어 체계로 막으면서 정상 작업 성능은 유지되거나 개선됐다는 연구 결과가 나왔다.
-
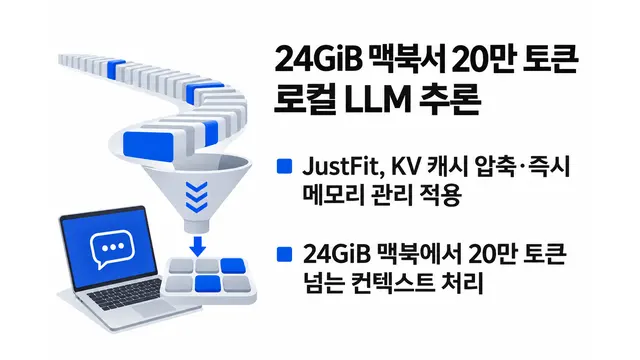
24GiB 맥북서 20만 토큰 로컬 LLM 추론, JustFit 공개
연구진이 KV 캐시 압축과 즉시 메모리 관리로 24GiB 맥북에서 20만 토큰 넘는 컨텍스트를 처리하는 추론 런타임 JustFit을 공개했다.
-
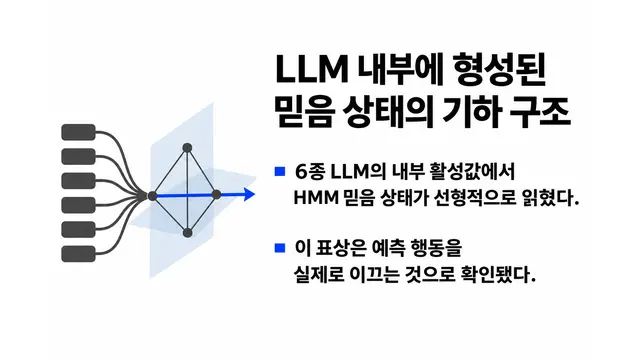
LLM, 문맥 학습 시 내부에 믿음 상태 기하 구조 형성
LLM 6종의 내부 활성값에서 HMM 믿음 상태가 선형적으로 읽히며 예측 행동을 실제로 이끄는 표상임이 확인됐다.
-
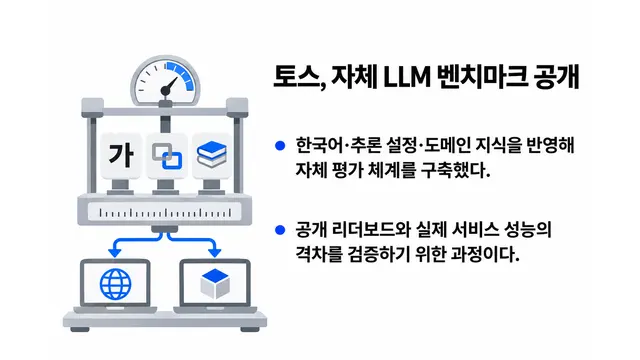
토스, 자체 LLM 벤치마크 'Toss Benchmark' 구축 공개
토스가 공개 리더보드와 실제 서비스 성능 간 격차를 검증하기 위해 한국어·추론설정·도메인지식을 반영한 자체 벤치마크 구축 과정을 공개했다.
-
AWS, LLM 기반 모델-비종속 PII 탐지기 공개
AWS가 지시문 기반 LLM PII 탐지기를 공개하고 오픈AI 등 9종 탐지기 벤치마크를 발표했다.
-
검증 가능한 프라이버시 보장 LLM 위임추론 기법 'Maverick' 공개
오픈소스 LLM 추론을 외부 서버에 맡기면서도 입력을 숨기고 결과 정확성까지 암호학적으로 검증하는 기법 Maverick이 공개됐다.
-
LLM 에이전트 리눅스 권한상승 자동화 능력, 531개 시나리오로 측정
연구팀이 도커 기반 벤치마크 PrivEscalate로 6종 LLM의 리눅스 권한상승 자동화 능력을 평가하고 전용 에이전트 래퍼를 공개했다.
-
블랙박스 상호작용만으로 LLM 에이전트 능력 훔친다
연구진이 실행 격차 관찰만으로 강한 LLM 에이전트의 절차적 지식을 약한 에이전트에 복제하는 공격 기법 AgentLeak을 공개했다.
-
LLM 추론 과정 암호화 블록, 복호화 공격에 뚫려
제공업체가 감춘 AI 추론 과정을 강한 모델에서 약한 모델로 암호화 블록을 주입해 평문으로 복원하는 공격 기법이 공개됐다.
-
Neon, AI 모델 42개 토큰 비용·정확도 벤치마크 공개
Neon이 고객 지원 티켓 100건으로 42개 AI 모델의 비용, 속도, 정확도를 비교한 벤치마크를 공개했다.
-
버클리·MIT, 소비자 GPU용 MoE 추론 엔진 FreeToken 공개
UC버클리·MIT 연구진이 동적 스케줄링으로 소비자 하드웨어에서 프런티어급 MoE 모델을 구동하는 오픈소스 추론 엔진 FreeToken을 발표했다.
-
텐센트, 활성 파라미터 490억 'Hy4 프리뷰' 공개
텐센트가 총 7700억·활성 490억 파라미터에 컨텍스트 100만 토큰인 텍스트 전용 모델 Hy4 프리뷰를 내놨다.
-
LLM 에이전트, PLC 실물 실험서 31.3% 물리적 피해 유발
연구진이 실제 PLC 하드웨어로 LLM 에이전트의 산업제어시스템 공격을 검증한 결과 240회 중 75회가 지속적 물리적 피해로 이어졌다.
-
LLM 에이전트 보안, 데이터 흐름 단위로 통제하는 'AgentFlow' 공개
AgentFlow는 데이터 흐름 경로에 정책을 적용해 프롬프트 주입 침해율을 33%에서 0%로 낮추면서도 작업 성공률을 높였다.
-
Multiverse, 4비트 양자화 모델이 원본 성능 능가하는 회복 기법 공개
Multiverse Computing이 원본 모델에서 직접 증류하는 QAH 기법으로 4비트 압축 모델이 풀프리시전 원본을 능가하는 결과를 냈다.
-
IBM, 추론 특화 경량 LLM '그래니트 4.2' 3종 공개
IBM이 3B·8B·30B 크기의 추론형 그래니트 4.2를 아파치 2.0 라이선스로 공개하고 에이전틱 RL과 도구 호출을 지원한다.
-
LLM이 토큰 시퀀스로 추론 서버 장악할 수 있다는 지적
연구자가 에이전틱 하네스의 추론 엔진 파싱 취약점이 LLM 스스로의 토큰 출력으로 악용될 수 있다고 지적했다
-
톰슨로이터, 자체 대형언어모델 '톰슨' 공개
톰슨로이터가 4천만 달러를 투자해 자체 개발한 법률 특화 대형언어모델 '톰슨'을 공개하고 코카운슬 리걸에 우선 적용한다고 밝혔다.
-
LLM 도구, httpx 의존성 문제로 이틀 연속 패치
OpenAI 파이썬 라이브러리가 httpx 사용을 중단해 커맨드라인 도구 LLM이 설치 오류를 겪자 개발자가 이틀 만에 임시·정식 패치를 냈다.