MoE
15건
기사 통계를 확인하고 있습니다.
-
허깅페이스, 로컬용 Inkling 2 Mini 공개
260억 매개변수 중 30억만 활성화하며 이미지와 100만 토큰 문맥을 처리하는 경량 MoE 모델이다.
-
허깅페이스, 32GB서 180B MoE 구동
허깅페이스가 선택된 전문가 가중치만 SSD에서 불러와 32GB 메모리에서 180B MoE를 구동하는 기법을 공개했다.
-
알리바바, 에이전트용 Qwen4-Max 공개
알리바바가 100만 토큰과 도구 호출을 지원하는 고효율 추론 모델 Qwen4-Max를 API 전용으로 출시했다.
-
45개 언어 학습한 ‘라라 미니 베이스’ 공개
72억 매개변수 MoE 구조로 45개 언어를 학습하고 연산 효율을 높인 소형 언어모델이 공개됐다.
-
유럽 공공 슈퍼컴퓨터서 1조 매개변수 AI 학습
EUROPA가 JUPITER와 소프트웨어 최적화로 9,519억 매개변수 MoE 모델의 처리량을 14배 높였다.
-
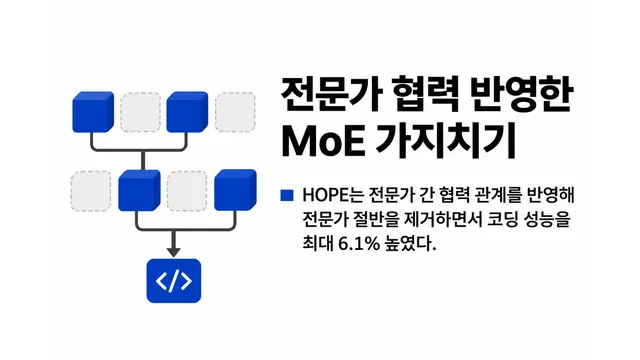
아마존, 전문가 협력 반영한 MoE 가지치기 공개
HOPE는 전문가 간 협력 관계를 반영해 MoE 전문가 절반을 제거하면서 코딩 성능을 최대 6.1% 높였다.
-
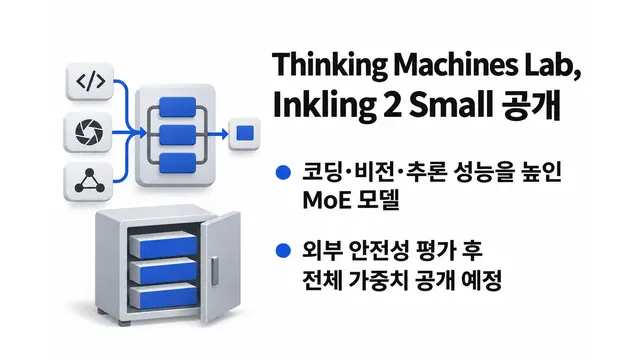
Thinking Machines Lab, Inkling 2 Small 공개
코딩·비전·추론 성능을 높인 MoE 모델로, 외부 안전성 평가 후 전체 가중치를 공개할 예정이다.
-
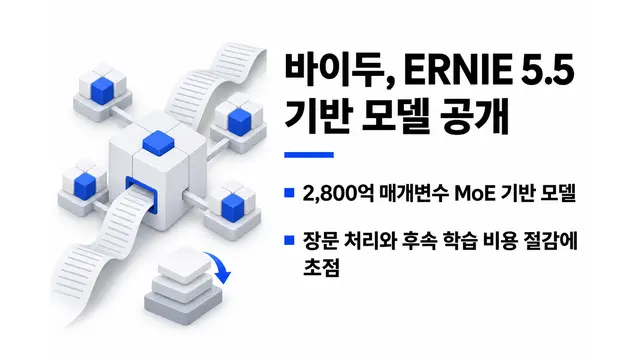
바이두, ERNIE 5.5 기반 모델 공개
바이두가 장문 처리와 후속 학습 비용 절감에 초점을 둔 2,800억 매개변수 MoE 기반 모델을 공개했다.
-
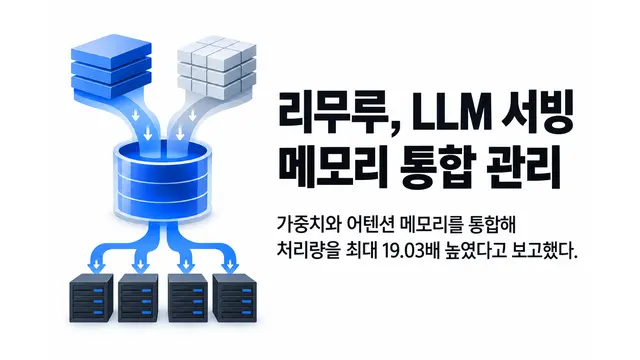
리무루, LLM 서빙 메모리 통합 관리
리무루는 가중치와 어텐션 메모리를 통합해 처리량을 최대 19.03배 높였다고 보고했다.
-
MLExpert, ML 실험 자율 최적화 성능 공개
350억 매개변수 MoE 모델 MLExpert가 MLE-Bench Lite에서 평균 메달 획득률 72.7%를 기록했다.
-
리퀴드AI, 온디바이스 MoE 모델 공개
토큰당 20억 매개변수만 활성화해 빠른 추론과 도구 사용에 집중한 LFM2.5-24B-A2B가 공개됐다.
-
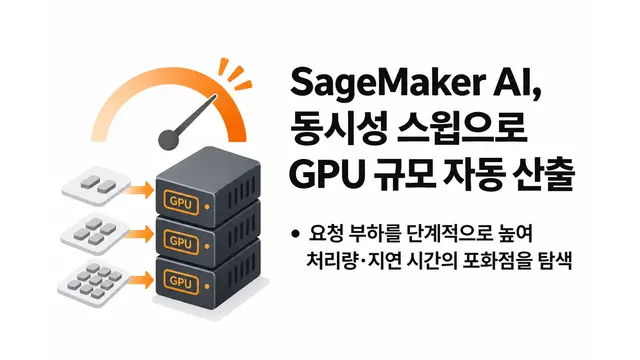
SageMaker AI, 동시성 스윕으로 GPU 인스턴스 규모 자동 산출
AWS가 SageMaker AI에 동시 요청 부하를 단계적으로 늘려 처리량·지연 시간의 포화점을 찾는 동시성 스윕 기능을 추가했다.
-
NVIDIA, JAX용 Transformer Engine으로 드롭리스 MoE 학습 10배 가속
NVIDIA가 JAX Transformer Engine 커널 최적화로 DeepSeek-V3 MoE 학습의 GPU당 처리량을 10.4배 높였다고 밝혔다.
-
Qwen, 오픈웨이트 최대 모델 Qwen3.8-2.4T-A95B 공개
Qwen 팀이 2.4조 파라미터에 활성 파라미터 950억 개인 하이브리드 MoE 모델을 오픈웨이트로 공개했다.
-
버클리·MIT, 소비자 GPU용 MoE 추론 엔진 FreeToken 공개
UC버클리·MIT 연구진이 동적 스케줄링으로 소비자 하드웨어에서 프런티어급 MoE 모델을 구동하는 오픈소스 추론 엔진 FreeToken을 발표했다.