AWS, EKS용 다중 노드 LLM 추론 공개
최근 30일 조회수 — 좋아요 —핵심 요약
AWS가 프리필과 디코드를 GPU 노드별로 분리하는 OpenAI 호환 LLM 추론 방식을 공개했다.
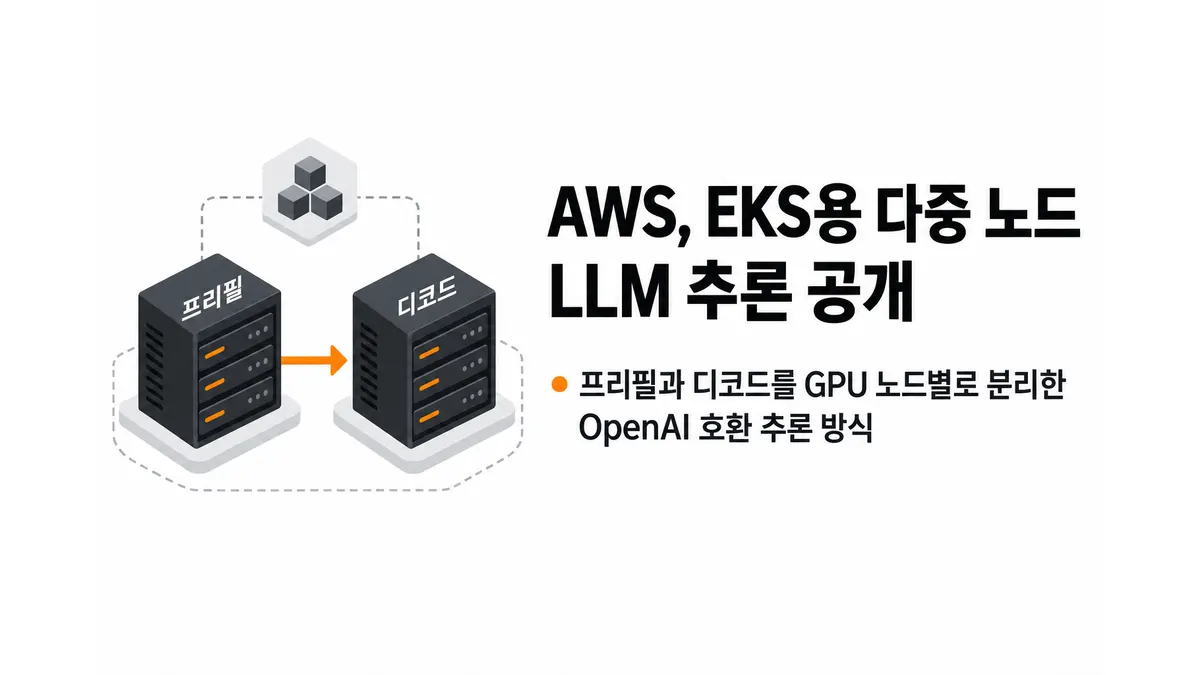
AWS가 하나의 대규모 언어 모델(LLM)을 아마존 엘라스틱 쿠버네티스 서비스(Amazon EKS)의 GPU 노드 두 대에 나눠 배포하는 방식을 공개했다. 10월 12일 AWS 머신러닝 블로그에 따르면, 새 다중 노드용 레이 LLM 딥러닝 컨테이너(Ray LLM Deep Learning Container)는 입력을 처리하는 프리필(prefill)과 토큰을 생성하는 디코드(decode)를 각각 별도 노드에서 실행하면서도 외부에는 하나의 OpenAI 호환 API를 제공한다.1
LLM 추론에서 프리필은 전체 입력 프롬프트를 병렬 처리해 키-값 캐시(KV cache)를 만든다. 연산량의 영향을 크게 받는 단계다. 반면 디코드는 이 캐시를 읽고 확장하며 응답을 한 토큰씩 생성하므로 메모리 대역폭이 중요하다. 두 작업을 같은 GPU에서 처리하면 길고 연산 집약적인 프롬프트가 이미 진행 중인 요청의 토큰 생성을 지연시킬 수 있다.
AWS가 소개한 프리필·디코드 분리(PD disaggregation)는 두 단계를 서로 다른 GPU 노드에 배치해 자원 경합을 줄이고, 단계별로 하드웨어 구성과 확장 규모를 따로 조절할 수 있게 한다. 긴 입력을 자주 다루는 검색 증강 생성(RAG), 문서 요약, 에이전트 애플리케이션이 주요 적용 대상으로 제시됐다. 단일 GPU에 담기 어려운 오픈 웨이트 모델을 실행하거나, 복제본 하나보다 높은 처리량이 필요한 경우에도 같은 다중 노드 구성을 활용할 수 있다.1
배포에 쓰는 컨테이너에는 레이 서브 LLM(Ray Serve LLM), 엔비디아 추론 전송 라이브러리(NVIDIA Inference Transfer Library·NIXL), 엘라스틱 패브릭 어댑터(Elastic Fabric Adapter·EFA) 스택이 포함된다. AWS가 프레임워크와 의존성, CUDA 라이브러리를 비롯한 GPU 소프트웨어 조합을 미리 시험하고 패치해 제공하므로, 사용자가 호환되는 구성요소를 직접 조립하거나 별도 애플리케이션 코드를 작성할 필요가 없다는 설명이다.
다만 노드를 분리하면 프리필 노드에서 만든 KV 캐시를 디코드 노드로 옮겨야 한다. 전송이 느리면 자원 경합을 줄여 얻은 이점이 사라질 수 있어 노드 간 연결 성능이 핵심 조건이다. AWS가 공개한 글은 배포 구조와 구현 절차를 제시하지만, 단일 노드 대비 지연시간이나 처리량이 얼마나 개선되는지 보여주는 벤치마크 수치는 자료에 포함되지 않았다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Run multi-node inference workloads using Ray LLM Deep Learning Containers | Amazon Web Services — AWS Machine Learning Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.