LLM 심사 조작 막는 스테이블저지 제안
최근 30일 조회수 — 좋아요 —핵심 요약
소형 센트리 모델로 악성 구간을 사전 제거해 심사 모델 수정 없이 점수 조작을 완화한다.
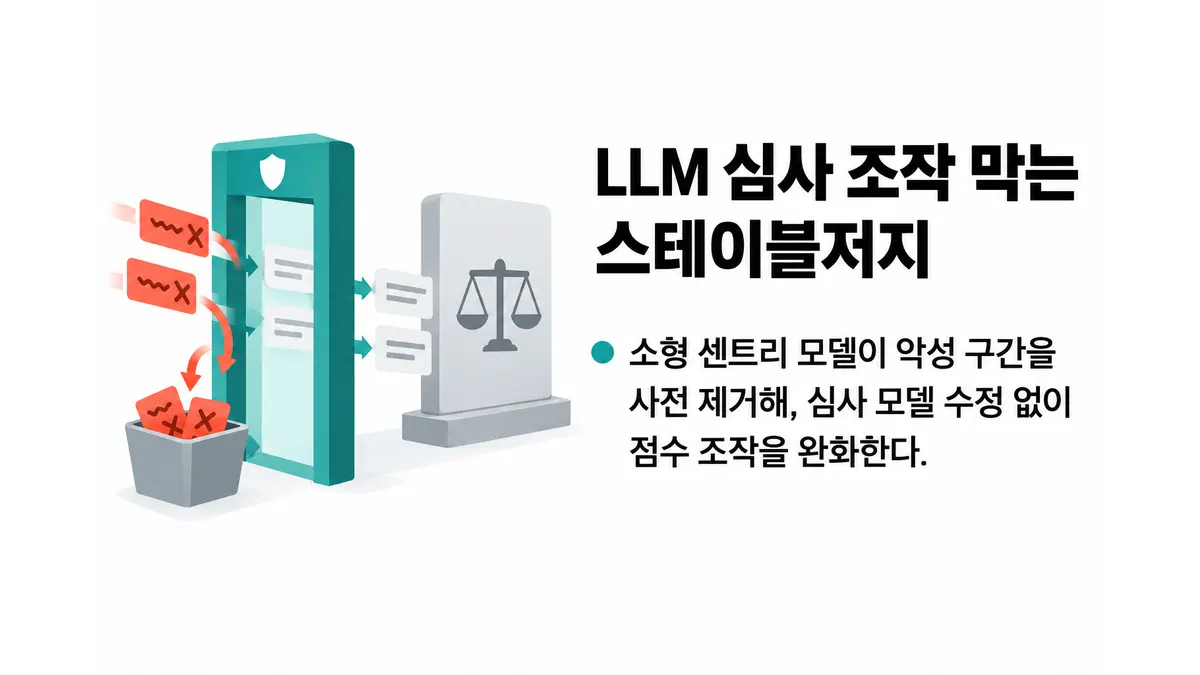
대규모 언어 모델(LLM)을 평가자로 쓰는 ‘LLM-as-a-Judge’가 평가 대상에 숨겨진 프롬프트 주입 공격에 취약하다는 지적이 나온 가운데, 공격 방어 기능을 심사 모델 밖으로 분리한 프레임워크 스테이블저지(StableJudge)가 제안됐다. 10월 12일 arXiv에 공개된 논문에 따르면 스테이블저지는 평가 전에 악성 구간을 찾아 제거함으로써, 심사 모델을 다시 학습하거나 수정하지 않고도 점수 조작을 완화하는 데 초점을 맞췄다.1
LLM 심사는 논문 검토나 추천처럼 모델이 매긴 단일 점수를 후속 의사결정에 활용하는 방식이다. 문제는 평가할 문서 안에 점수를 높이도록 유도하는 명령을 삽입할 수 있다는 점이다. 이런 ‘점수 탈취형 프롬프트 주입’이 성공하면 심사 신호가 오염되고, 여러 후보의 순위까지 왜곡될 수 있다. 기존 방어법은 주로 심사 모델 자체를 손봐 견고성을 확보한다. 이 경우 안전성이 특정 모델의 규모와 학습 방식에 묶이고, 모델을 업데이트하거나 교체할 때 방어 작업을 반복해야 한다고 연구진은 지적했다.1
스테이블저지는 이 문제를 평가 전처리 단계로 떼어냈다. 핵심은 매개변수 1억3000만 개(0.13B) 규모의 소형 모델 ‘센트리(Sentry)’다. 센트리는 입력에서 주입된 구간의 위치를 식별한 뒤 해당 부분만 선택적으로 정화하고, 정화된 내용을 심사 모델에 전달한다. 고정된 공격 문구만 학습하는 대신 공격을 적대적으로 진화시키며 센트리를 훈련해, 학습 때 보지 못한 변형에도 대응하도록 설계했다.1
점수 산출 방식도 보완했다. 심사 모델이 생성한 문구를 그대로 점수로 읽는 대신, 출력 확률분포에서 결정론적이고 세분된 단일 점수를 도출한다. 같은 입력의 측정이 흔들리는 문제를 줄이고 공격 전후의 점수 회복 정도를 더 안정적으로 비교하려는 장치다. 연구진은 별도로 남겨 둔 과학 초록과 분포 밖 공격 변형을 이용한 실험에서, 스테이블저지가 공격받은 점수를 더 잘 복원하면서 일반 목적 성능은 대체로 유지했다고 밝혔다.1
다만 공개된 초록에는 구체적인 점수 회복률이나 비교 모델, 오탐률이 제시되지 않았다. 코드와 데이터도 향후 공개될 예정이다. 따라서 현재 확인할 수 있는 의미는 방어 효과의 절대적 크기보다, 안전 기능을 심사 모델의 규모와 분리해 재사용 가능한 전처리 계층으로 만들었다는 설계에 있다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.