LLM 변경 없이 프롬프트 인젝션 방어
최근 30일 조회수 — 좋아요 —핵심 요약
학습형 신뢰 경계 구분자로 사용자 지시와 외부 데이터를 나눠 공격 성공률을 크게 낮춘 기법이 제안됐다.
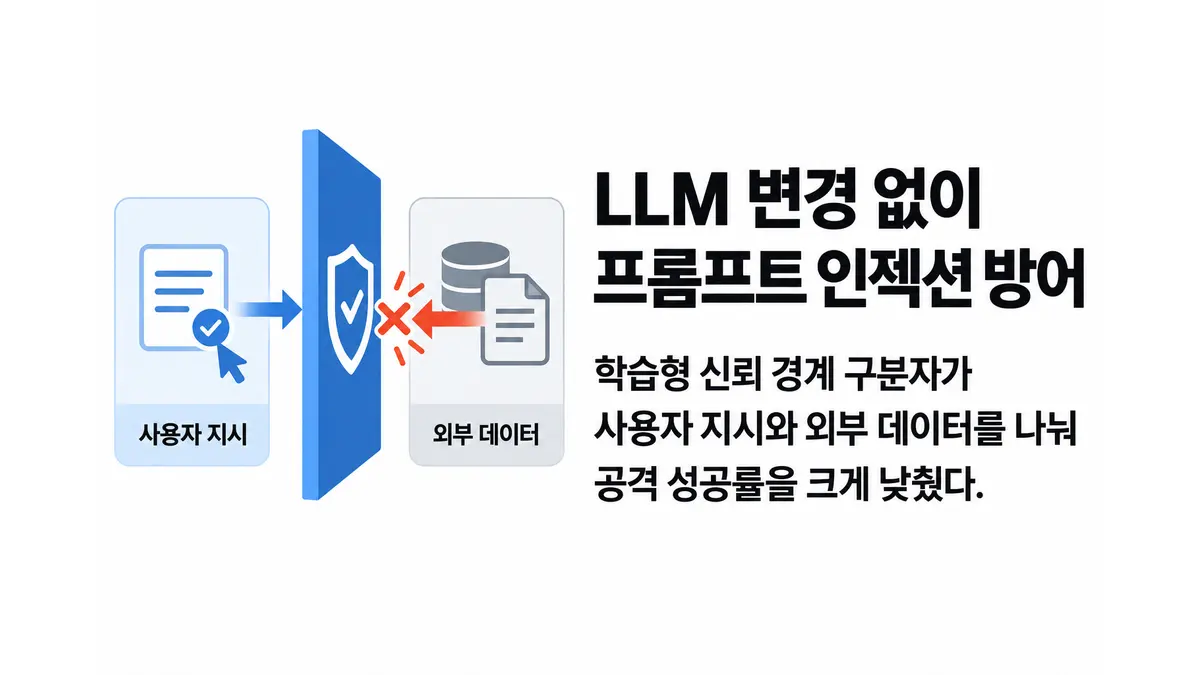
대규모 언어 모델(LLM)의 매개변수를 바꾸지 않고도 프롬프트 인젝션을 막는 기법이 제안됐다. 10월 8일 arXiv에 공개된 논문은 학습 가능한 신뢰 경계 구분자(Learnable Trust-Boundary Delimiters·LTBD)를 입력에 삽입해, 사용자가 내린 지시와 외부에서 들어온 데이터를 명시적으로 구별한다. 연구진이 보고한 공격 성공률(Attack Success Rate·ASR)은 AlpacaFarm에서 0.00%, TaskTracker에서 0.11~0.19%였다.1
프롬프트 인젝션은 문서나 웹페이지 같은 외부 데이터에 악성 지시를 숨겨 LLM이 원래 사용자 의도보다 이를 우선하도록 만드는 공격이다. 연구진은 근본 원인을 입력에 정보의 출처와 신뢰 수준을 나타내는 표현이 없다는 데서 찾았다. 사용자 지시와 외부 데이터가 같은 문맥 안에 놓이면, 모델이 어느 쪽을 따라야 하는지 안정적으로 판단하기 어렵다는 설명이다.
LTBD는 소수의 학습 가능한 구분자로 이 문제를 다룬다. 신뢰할 수 있는 사용자 지시와 신뢰할 수 없는 외부 데이터의 경계를 입력 단계에서 표시해 모델이 의도된 신뢰 계층을 따르도록 유도한다. 구분자 자체는 학습하지만 LLM의 매개변수는 그대로 유지한다는 점이 핵심이다. 모델 전체를 미세조정하는 방어법보다 적용 부담을 줄이면서, 사람이 직접 만든 프롬프트 규칙이 공격 표현의 변화에 쉽게 깨지는 문제도 피하려는 접근이다.
논문에 따르면 LTBD는 추론 시점에만 적용하는 기존 방어법보다 공격 방어 성능이 높았고, 별도 모델 학습을 동반하는 접근과도 경쟁할 만한 결과를 냈다. 정상 작업의 유용성을 유지했으며 추론 오버헤드는 미미했다고 연구진은 밝혔다. 공격자가 방어 구조를 모두 알고 이를 우회하도록 입력을 설계하는 적응형 공격에서도 효과가 유지됐다는 결과도 제시했다.
다만 공개된 자료는 논문 초록과 연구진의 실험 결과이며, LTBD가 모든 모델과 실제 서비스 환경에서 같은 수치를 낸다고 단정할 근거는 없다. 특히 0.00%라는 수치는 AlpacaFarm에서 연구진이 보고한 ASR이며, 실제 공격 성공 건수가 0건이었다거나 프롬프트 인젝션 가능성이 완전히 사라졌다는 의미로 단정할 수는 없다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.