화면 조작 AI 공격 막는 ‘SA-CUA’ 제안
최근 30일 조회수 — 좋아요 —핵심 요약
신뢰 화면 영역과 외부 콘텐츠를 분리해 컴퓨터 사용 AI의 프롬프트 주입 공격을 차단하는 구조가 제안됐다.
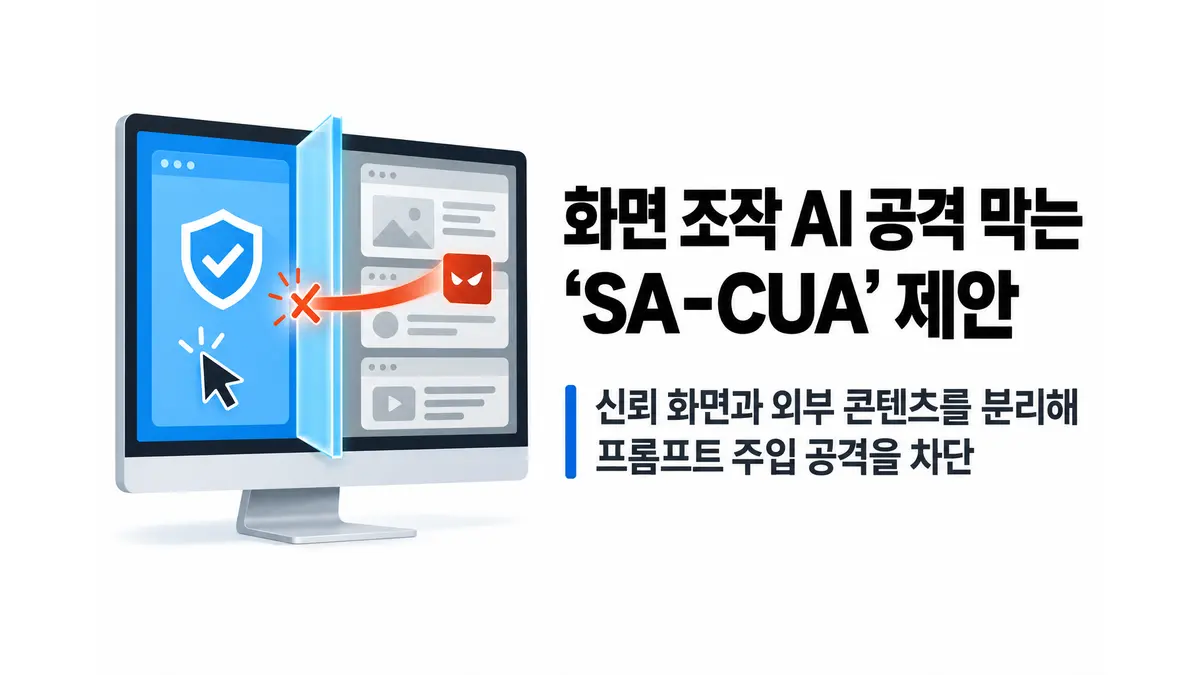
컴퓨터 화면을 보고 클릭과 입력을 수행하는 AI 에이전트의 위험 행동을 구조적으로 막는 기법이 제안됐다. 10월 13일 arXiv에 공개된 논문은 접근성 트리에서 신뢰할 수 있는 화면 영역을 판별하고, 신뢰 영역과 외부 콘텐츠를 서로 분리하는 이중 대규모 언어 모델(LLM) 구조 ‘SA-CUA’를 소개했다. 연구진은 이 방식이 비교 대상인 CaMeL-CUA보다 효용을 훨씬 높게 유지하면서도 공격 성공률을 0으로 억제했다고 보고했다.1
현재 LLM 기반 에이전트의 안전장치는 주로 정렬 학습과 안전 분류기에 기대지만, 논문은 정교한 간접 프롬프트 주입(Indirect Prompt Injection·IPI)이 이를 통과해 큰 피해를 일으킬 가능성을 배제할 수 없다고 지적한다. 구조화된 도구 인터페이스를 쓰는 에이전트라면 정보 흐름을 통제할 수 있지만, 컴퓨터 사용 에이전트(Computer Use Agent·CUA)는 화면 전체를 시각적으로 처리한다. 이 때문에 사용자가 신뢰한 앱의 메뉴와 공격자가 작성한 웹 콘텐츠 사이에 명확한 경계가 없다. 같은 클릭이라도 앱 도구 모음을 누를 수도, 공격자가 만든 버튼을 누를 수도 있다.
SA-CUA는 두 LLM의 역할을 나누고, 접근성 트리에서 보수적이고 결정적인 규칙을 생성해 이 문제를 다룬다. 특권 LLM이 보는 스크린샷에서는 이 규칙으로 확인된 신뢰 영역만 드러내고, 신뢰할 수 없는 콘텐츠와 분리한다. 외부 콘텐츠에서 얻은 값이 작업에 필요할 때는 ‘견고한 승인 채널’을 거친다. 신뢰할 수 있는 경로로 정보를 검증한 뒤에만 신뢰 영역으로 값을 넘기는 방식이다.1
이 설계는 민감한 결정을 할 때마다 사용자에게 승인을 요구하지 않는다. 연구진은 반복 확인이 경고 피로를 낳아 오히려 위험 행동을 놓칠 수 있다고 본다. 사용자는 작업 시작 시 목적을 제대로 지정하고, 이후에는 에이전트가 신뢰할 수 없는 정보를 포함한 작업도 자율적으로 처리한다.
다만 공개된 자료는 논문 초록이며, 공격 성공률 0이 어떤 과제·공격 유형·모델 구성에서 측정됐는지 구체적인 조건은 제시하지 않는다. SA-CUA의 효과를 일반적인 컴퓨터 사용 환경까지 확대해 해석하려면 본문에 담긴 실험 범위와 평가 기준을 함께 확인해야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Towards Safe Autonomy for Computer Use — arXiv (cs.CR)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.