BugGen 2.0, RTL 버그 합성 비용 절감
최근 30일 조회수 — 좋아요 —핵심 요약
LLM을 국소 코드 변이에 집중하고 구조 분석·검증을 알고리즘에 맡겨 토큰과 시뮬레이션 비용을 줄였다.
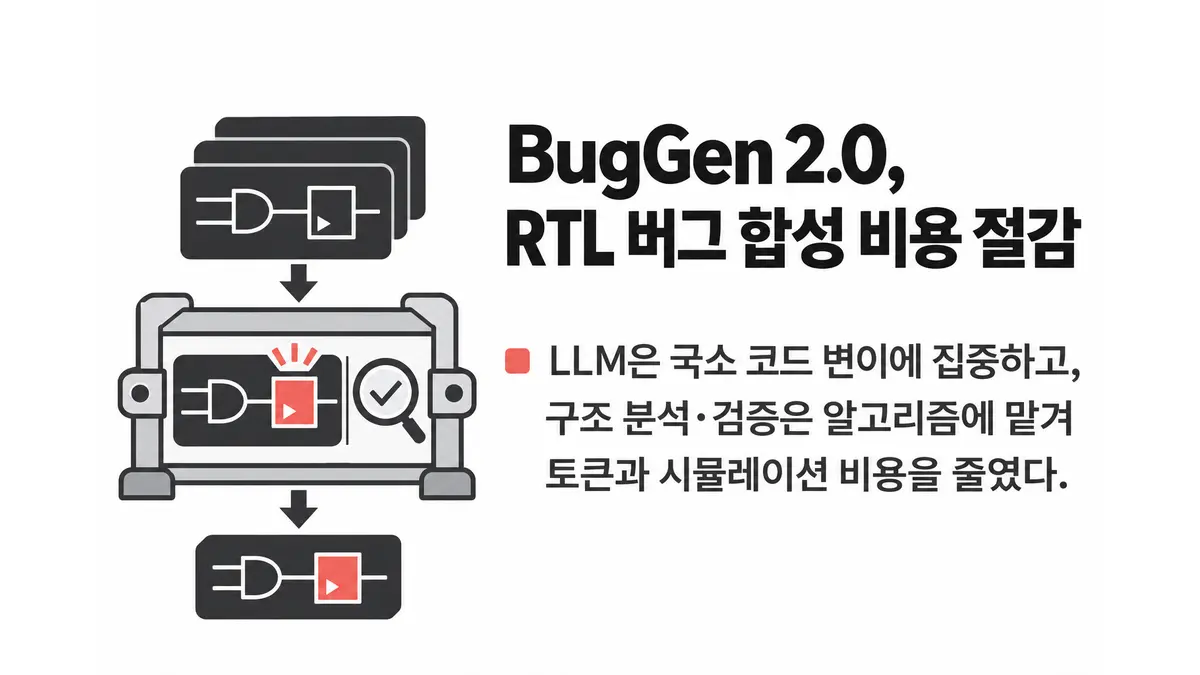
BugGen 2.0은 대규모 언어 모델(LLM)이 레지스터 전송 수준(RTL) 버그의 위치 선정부터 코드 수정까지 맡던 방식을 버리고, LLM의 역할을 국소적인 의미 재작성으로 좁혔다. 구조 분석과 변이 대상 선택, 검증은 결정론적 알고리즘이 담당한다. 연구진은 이 분업으로 추론 비용을 줄이면서도 설계와 모델이 달라질 때 일관된 버그 합성이 가능해졌다고 밝혔다.1
RTL 버그 데이터셋은 버그 위치가 알려져 있고 실제 테스트 실패로 이어져야 한다. AI 기반 오류 위치 추적·디버깅의 학습 및 평가뿐 아니라, 테스트벤치가 주입된 버그를 얼마나 잘 탐지하는지 측정할 때도 필요하다. 그러나 BugGen 1.0처럼 LLM에 변이 지점 선택과 편집 생성을 모두 맡기면 입력 문맥과 토큰 사용량이 늘고, 수정할 수 없는 지점을 고를 위험도 생긴다.
BugGen 2.0은 먼저 알고리즘으로 RTL 구조를 분석해 유효한 후보를 고른 뒤, LLM에는 해당 위치의 의미에 맞는 코드 변이만 요청한다. 이후 결과 검증도 알고리즘으로 처리한다. OpenTitan의 IP 블록 4개와 FabScalar를 세 가지 LLM으로 시험한 결과, 컴파일이 가능하면서 테스트를 두 개 이상 실패시키는 버그 시나리오를 요청 수량만큼 모두 만들었다. 전체 실험에서 설정된 변이 유형 16개 가운데 14~16개가 실제 결과에 포함됐다.1
같은 LLM을 사용해 비교를 완료한 실험에서는 토큰 사용량이 BugGen 1.0보다 6.815.4배 적었고, Firefly보다도 1.57.9배 적었다. 즉 LLM의 능력을 없앤 것이 아니라, 문맥을 이해해야 하는 좁은 편집 작업에 집중시켜 비용과 잘못된 선택을 함께 줄인 셈이다.
시뮬레이션 비용을 줄이는 방법도 더했다. 먼저 관측 가능한 실패를 일으킨 버그를 찾고, 같은 위치에 대안 변이를 추가한 다음 일부만 시뮬레이션해 나머지의 승인 가능성을 추정했다. 이 방식으로 AES 변이 시뮬레이션의 63.6%, FabScalar의 33.9%를 생략했다. 전체를 다시 시뮬레이션했을 때 승인 비율은 각각 77.7%와 95.2%였으며, 직접 비교 가능한 FabScalar 집합의 추정 오차는 1.09%였다.1
다만 이 수치는 OpenTitan 일부 블록과 FabScalar, 세 LLM에서 얻은 결과다. 다른 설계에서도 같은 절감 폭이 유지되는지는 논문 초록만으로 확인할 수 없다. 또한 시뮬레이션을 생략한 변이는 추정치이므로, 모든 개별 버그의 유효성을 직접 검증한 데이터와는 구분해야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.