FedGraph, 연합 LLM 백도어 공격 탐지
최근 30일 조회수 — 좋아요 —핵심 요약
클라이언트 업데이트 관계를 그래프로 분석해 공격 성공률을 10% 미만으로 낮추고 악성을 95.5% 탐지했다.
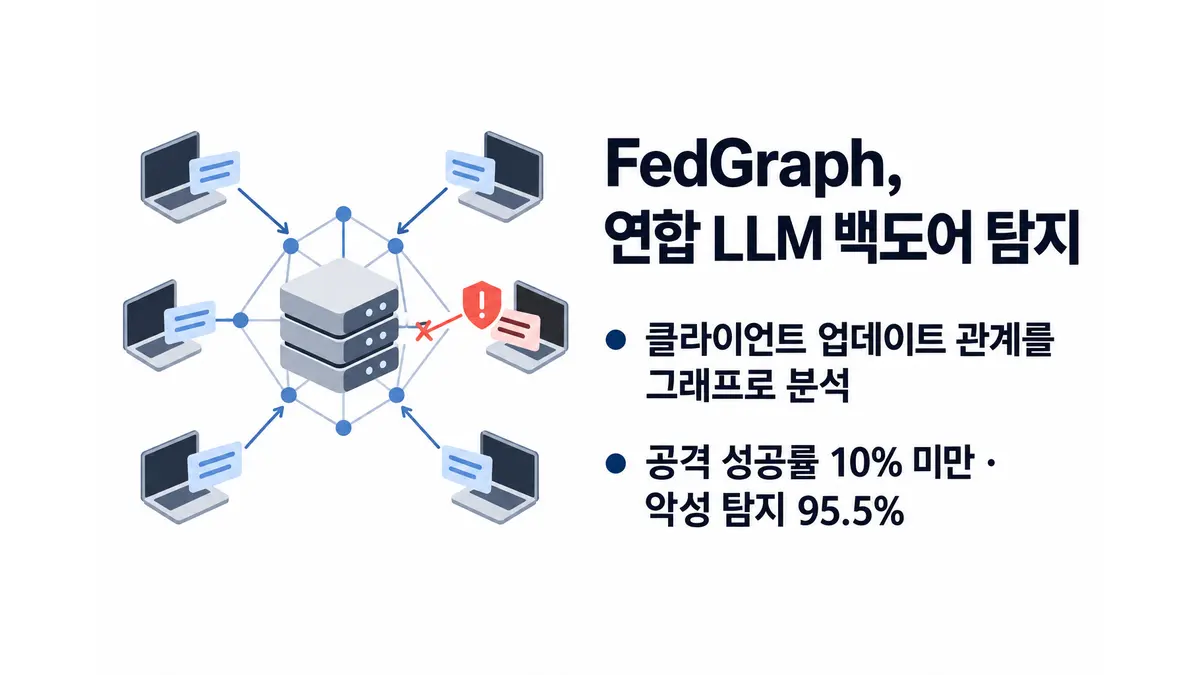
연합 대규모 언어 모델(LLM) 미세조정에서 클라이언트 업데이트의 관계를 그래프로 분석해 백도어 공격을 걸러내는 방어 기법이 제안됐다. 10월 13일 arXiv에 공개된 논문에서 연구진은 ‘FedGraph’가 실험 전반에서 공격 성공률을 10% 미만으로 낮추고, 악성 클라이언트를 평균 95.5% 정확도로 탐지했다고 밝혔다.1
연합 미세조정은 여러 클라이언트가 원본 데이터를 공유하지 않고 각자 계산한 업데이트를 모아 LLM을 조정하는 방식이다. 데이터가 한곳에 모이지 않는다는 장점이 있지만, 악성 클라이언트가 조작된 업데이트를 제출하면 문제가 생긴다. 공격자는 정상 입력에서 모델 성능을 유지하면서 특정 입력에만 의도한 행동을 일으키는 백도어를 심을 수 있다.
기존 방어법은 주로 고차원 매개변수 공간에서 개별 업데이트가 이상치인지 직접 판별한다. 논문은 LLM 업데이트에 여러 신호가 뒤엉켜 있어 이런 접근만으로는 악성과 정상을 구분하기 어렵다고 지적한다. 대신 연구진은 악성 클라이언트끼리 만든 업데이트는 강한 일관성을 보이지만, 정상 클라이언트의 업데이트는 더 다양하고 흩어진다는 구조적 차이에 주목했다.1
FedGraph는 각 클라이언트를 노드로 삼아 동적으로 그래프를 구성하고, 업데이트 사이의 상대적 위치와 상호작용을 나타내는 구조적 특징을 추출한다. 이어 이 특징을 압축된 클라이언트 표현으로 바꿔 악성 행동과 정상 행동을 분리하고, 집계 단계에서 악성으로 판단한 기여를 억제한다. 개별 업데이트 하나가 얼마나 튀는지만 보는 대신, 여러 업데이트가 서로 어떤 무리를 이루는지 판단 근거로 쓰는 셈이다.
논문이 보고한 평균 탐지 정확도는 95.5%, 정상 클라이언트를 악성으로 잘못 분류한 오탐률은 2.33%다. 연구진은 FedGraph가 기존 연합학습 방어법을 상당히 앞섰다고 설명한다.1 다만 제공된 초록에는 비교 대상별 수치와 실험에 사용한 모델·데이터셋·공격 유형이 제시되지 않았다. 또 이번 결과는 arXiv에 제출된 논문의 저자 보고치이므로, 구체적인 적용 범위와 재현성은 본문과 후속 검증을 통해 확인할 필요가 있다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- FedGraph: Defending Federated Large Language Model Fine-Tuning Against Backdoor Attacks via Graph-Based Aggregation — arXiv (cs.CR)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.