TAILROLL, LLM 강화학습 롤아웃 24~34% 단축
최근 30일 조회수 — 좋아요 —핵심 요약
꼬리 응답을 이전·조기 종료하는 스케줄링으로 LLM 강화학습의 롤아웃 지연과 연산 낭비를 줄였다.
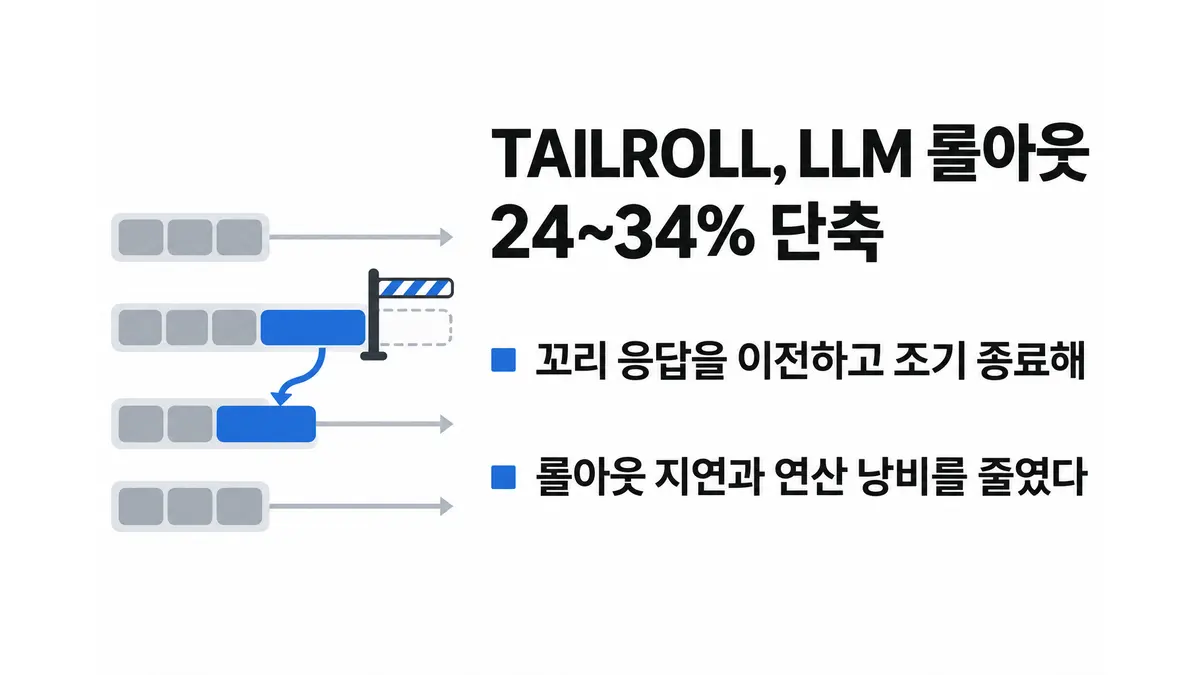
대규모언어모델(LLM)의 강화학습 후처리에서 가장 늦게 끝나는 응답 때문에 전체 연산이 멈추는 문제를 줄이는 스케줄링 기법이 나왔다. 11월 17일 arXiv에 공개된 논문은 온라인 스케줄러 TAILROLL(Tail-Aware Rollout Acceleration)이 긴 응답의 꼬리 구간을 관리해, 종단 간 강화학습의 롤아웃 시간을 24~34% 단축했다고 보고했다.1
롤아웃은 모델이 학습에 쓸 응답을 생성하는 단계다. 응답 길이가 한쪽으로 치우친 ‘긴 꼬리’ 분포를 보이면 먼저 작업을 마친 추론 엔진은 쉬게 되고, 학습 단계는 가장 긴 응답이 끝날 때까지 기다린다. 비동기 학습도 유휴 시간을 가릴 수는 있지만 없애지는 못한다. 연구진은 낭비를 요청 배치와 디코딩 경합에서 생기는 ‘불균형 낭비’, 최장 응답을 기다리며 생기는 ‘지연 요청 낭비’로 구분했다. 평균 부하보다 꼬리 응답의 길이가 한 단계의 소요 시간을 좌우한다는 설명이다.
TAILROLL은 실행 중 이전과 충분성 기준 종료를 결합한다. 이전 기능은 청크 경계에서 디코딩 요청을 여유 있는 다른 엔진으로 옮기고, 한 차례 다시 프리필한 뒤 생성을 이어 간다. 어느 요청을 옮길지는 엔진의 여유와 이전 비용을 함께 따지는 정책으로 결정한다. 종료 기능은 GRPO 그룹에서 어드밴티지 추정에 필요한 완료 샘플이 충분히 모이면 남은 응답 생성을 멈춘다. 중간까지만 생성된 출력은 학습 손실 계산에서 제외한다.
논문이 시험한 10개 구성에서 롤아웃 버블 비율은 2174%, 엔진 사이 KV 캐시 불균형은 4479% 줄었다. 긴 사고과정(CoT) 강화학습에서는 전체 학습 단계 시간이 2122% 단축됐고, 요청 지연시간의 95백분위수는 2837% 낮아졌다. 생성 처리량은 최대 33% 늘었으며 최종 보상은 기존 방식과 비슷하거나 더 높았다고 연구진은 밝혔다.1
다만 이 결과는 2026년 11월 제출된 논문의 저자 측 실험 보고다. 초록에는 비교 대상별 세부 조건과 각 기법의 개별 기여도가 제시되지 않아, 다른 모델·하드웨어·학습 설정에서도 같은 폭의 개선이 재현되는지는 본문과 후속 검증을 통해 확인해야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.