LLM 에이전트 보안 체계 ‘Kairos’ 제안
최근 30일 조회수 — 좋아요 —핵심 요약
Kairos는 외부 작업을 보류·추적한 뒤 흐름 단위로 승인해 프롬프트 인젝션 피해를 줄인다.
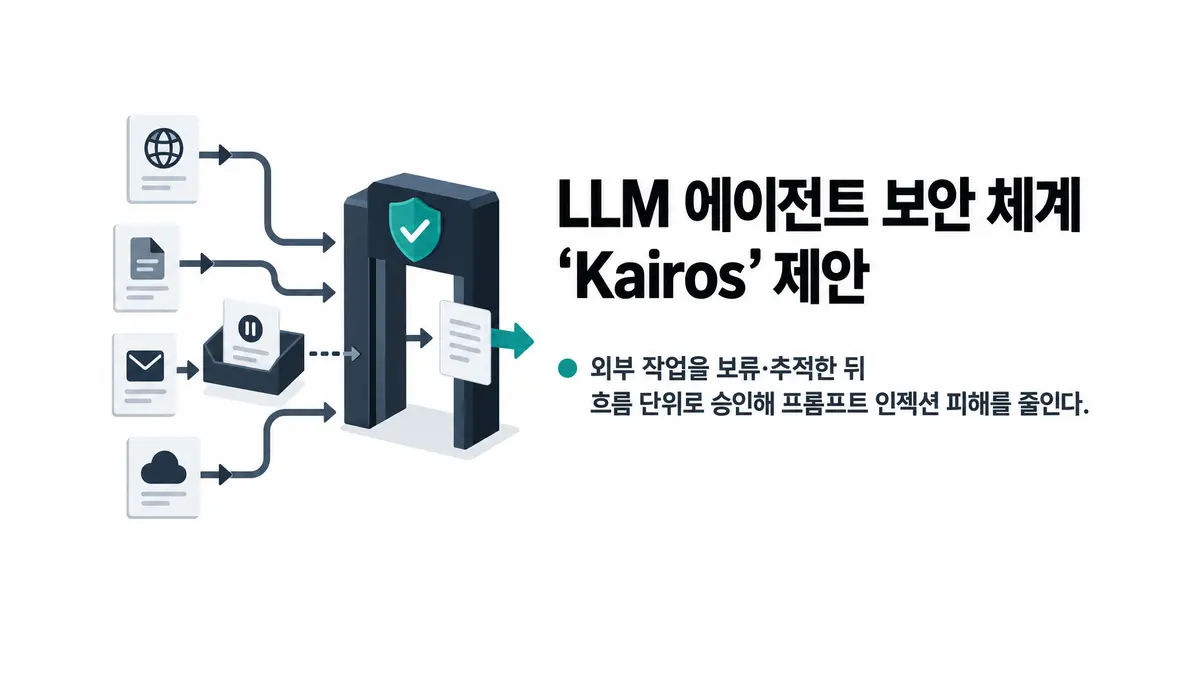
대규모 언어 모델(LLM) 에이전트가 외부 시스템에서 일으키는 작업을 개별 명령이 아닌 트랜잭션 단위로 통제하는 보안 체계 ‘Kairos’가 제안됐다. 10월 13일 공개된 논문에서 연구진은 에이전트를 수정하지 않고도 파일·네트워크 작업을 시스템 경계에서 가로채고, 판단하기 어려운 작업은 보류한 채 이후 행동까지 살펴 승인하거나 거부하는 방식을 제시했다.1
LLM 에이전트는 사용자의 권한으로 파일을 읽고 명령을 실행하며 네트워크 자원에 접근한다. 문제는 에이전트가 읽는 웹페이지나 문서 등에 공격자의 지시가 숨을 수 있다는 점이다. 모델은 데이터와 명령을 안정적으로 구별하지 못하기 때문에 간접 프롬프트 인젝션이 실제 외부 작업으로 이어질 수 있다. 접근 범위가 넓을수록 활용도는 높아지지만, 공격자가 에이전트를 유도했을 때 악용할 수 있는 범위도 함께 커진다.
기존 허용·차단 방식에는 구조적인 한계가 있다. 정상 작업과 공격의 첫 단계가 개별적으로는 비슷해 보이고, 여러 작업이 이어진 뒤에야 의도가 드러날 수 있어서다. 그러나 일반적인 감시 체계는 증거가 쌓이기 전에 각 작업을 즉시 허용하거나 거부해야 한다.
Kairos는 이 문제를 ‘보류’로 풀었다. 수정하지 않은 불투명한 에이전트를 격리 환경에 두고, 도구 호출과 셸 명령, 에이전트가 작성한 스크립트를 모두 동일한 파일·네트워크 작업으로 변환해 경계에서 감시한다. 먼저 신뢰할 수 있는 출처를 선언형 정책에 적어 대부분의 작업을 결정론적으로 처리한다. 정책만으로 판단하기 어려운 작업은 즉시 실행하지 않고 보류하며, 에이전트는 추측 실행을 계속한다. 이후 제한된 권한을 지닌 언어 모델이나 사람이 누적된 작업 흐름을 보고 보류된 효과를 승인하거나 거부한다.
논문은 세 가지 벤치마크와 세 종류의 에이전트 모델에서 Kairos가 기존 방어책보다 공격 성공률과 정상 작업 효용 사이의 균형이 나았다고 보고했다. AgentDojo에서는 공격 성공률이 방어하지 않았을 때의 47.0%에서 2.7%로 낮아졌고, 정상 작업 효용은 무방비 에이전트와 같은 수준을 유지했다. 다만 공개된 초록만으로는 다른 벤치마크의 수치, 지연 비용, 오라클의 오판 가능성까지 판단하기 어렵다. 또한 이 결과는 2026년 10월 공개된 arXiv 초고에 담긴 연구진의 평가다.
Footnotes
-
arXiv, “Kairos: Transactional Security Enforcement at the System Boundary for LLM Agents” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.