토스, LLM 비용 절감 기법 SNAP 공개
최근 30일 조회수 — 좋아요 —핵심 요약
토스는 쉬운 요청만 소형 모델로 처리해 품질을 유지하며 LLM 호출의 약 3분의 1을 줄였다.
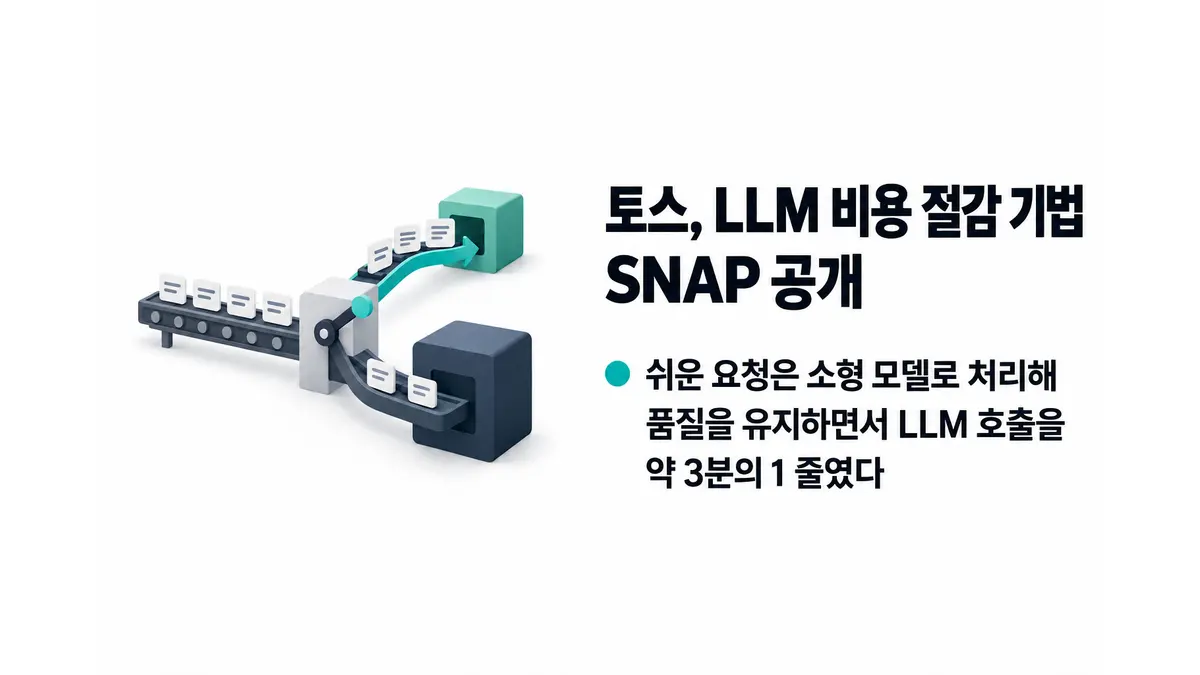
토스가 생성형 AI 서비스의 대규모언어모델(LLM) 호출 비용을 줄이는 선택적 내재화 기법 SNAP(Selective Native AI Processing)을 공개했다. 모든 요청을 상용 LLM에서 자체 모델로 한꺼번에 옮기는 대신, 소형 모델이 높은 신뢰도로 판단할 수 있는 요청만 먼저 처리하고 나머지는 기존 LLM에 넘기는 방식이다. 토스는 첫 적용 사례에서 전체 요청의 약 3분의 1을 소형 모델로 전환했다.1
토스가 이런 구조를 택한 이유는 LLM이 처리하는 작업의 난도가 제각각이기 때문이다. 복잡한 문맥 이해와 긴 답변 생성에는 범용 LLM이 필요할 수 있지만, 두 상품이 같은지 판단하거나 정해진 분류값 하나를 고르는 작업까지 같은 모델을 쓸 필요는 없다. 자체 모델을 미세조정하는 방법도 비용을 줄일 수 있지만, SNAP은 모든 트래픽을 대체할 만큼 성능을 끌어올리기보다 쉬운 요청부터 걷어내는 데 초점을 맞췄다.
후보 선정과 학습 과정도 자동화했다. SNAP은 시스템 프롬프트 앞부분을 해시한 ‘태스크 지문(Task Fingerprint)’으로 서로 다른 LLM 호출 로그를 작업별로 묶는다. 이후 매일 호출량과 입출력 토큰 수, 사용 모델, 추정 비용을 집계해 비용이 큰 작업을 골라낸다. 응답에서 학습용 레이블을 안정적으로 추출할 수 있고 데이터도 충분한 작업만 학습으로 넘긴다. 이 흐름은 에어플로(Airflow) 일일 배치로 연결돼 후보 발굴부터 데이터셋 구성, 모델 학습까지 하루 안에 진행된다.
첫 적용 대상은 상품명과 옵션을 비교해 같은 판매 단위인지 판별하는 작업이었다. 검증 요청 10만648건을 대상으로 기존 LLM 판단과 99.9% 이상 일치한다는 조건을 걸자, 소형 모델은 3만4963건을 맡아 34.74%의 커버리지를 기록했다. 채택 결과 가운데 LLM과 다른 판단은 34건으로, 실제 일치율은 99.9028%였다. 목표 일치율을 99%로 낮추면 커버리지는 51.59%, 95%에서는 72.35%까지 올라갔다.
운영에서는 생성형 AI 게이트웨이가 소형 모델을 먼저 호출한다. 신뢰도 점수가 작업별 임계값 이상이면 그 결과를 쓰고, 미달하면 기존 LLM을 다시 부른다. 배포 뒤 약 6일간 소형 모델이 처리한 비율은 하루 33~37%로 오프라인 평가와 비슷했다. 다만 신뢰도 0.95가 곧 정확도 95%를 뜻하는 것은 아니다. 토스가 별도 검증 데이터로 품질 목표와 임계값을 함께 정한 이유다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- 손가락을 튕기기로 LLM 비용 줄이기 — Toss Tech
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.