가중치 수정 없이 추론 높이는 DMS 공개
최근 30일 조회수 — 좋아요 —핵심 요약
DMS는 추론 경로의 다양성을 유지하면서 답 분포를 강하게 선별해 주요 벤치마크에서 최고 평균 성능을 기록했다.
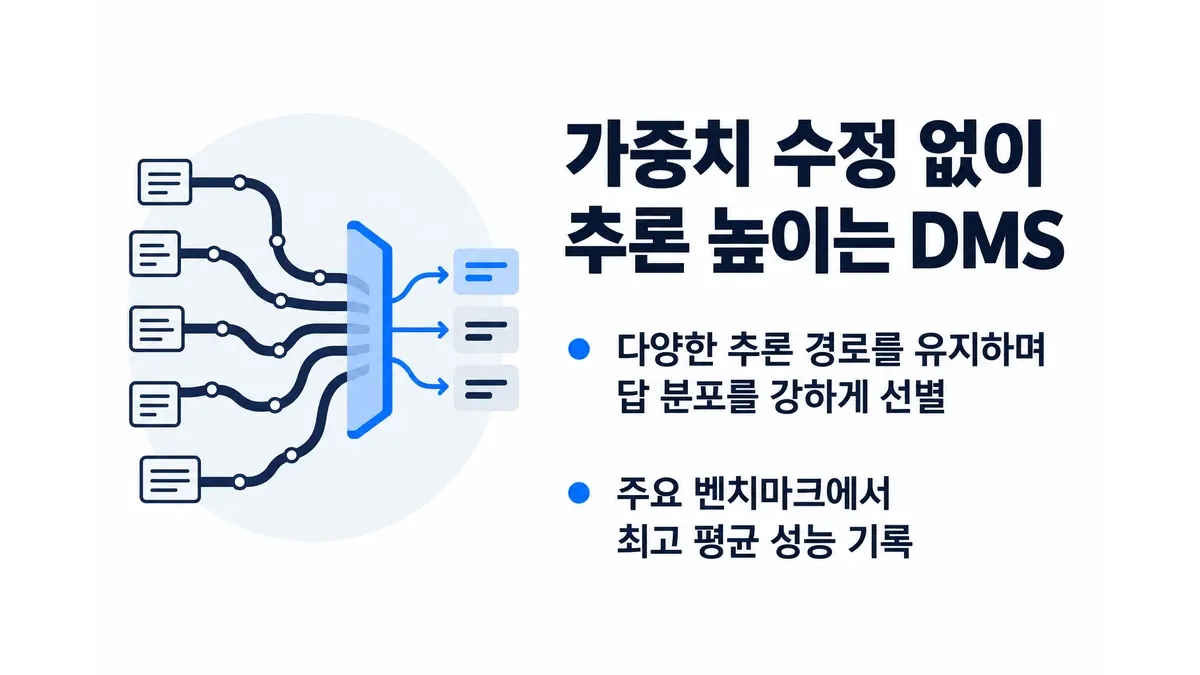
대규모 언어 모델(LLM)의 가중치를 수정하거나 외부 보상 모델을 쓰지 않고 추론 성능을 높이는 기법 DMS(Decoupled Marginal Sharpening·분리형 주변분포 샤프닝)가 공개됐다. 10월 14일 arXiv에 제출된 논문에 따르면, DMS는 추론 경로와 최종 답을 서로 다른 강도로 선별한다. 연구진은 MATH500, GPQA-Diamond, HumanEval, AIME24/25 실험에서 DMS가 비교 대상 가운데 모든 과제에서 가장 높은 평균 pass@1을 기록했다고 밝혔다.1
DMS가 겨냥한 것은 ‘보상 없는 파워 샘플링’의 두 가지 문제다. 기존 방식은 기본 모델에서 원래 나올 가능성이 큰 완성문에 더 높은 확률을 주도록 전체 시퀀스의 분포를 다음처럼 조정한다.
π_α(y|x) ∝ p₀(y|x)^α, α > 1지수 α가 클수록 모델이 이미 선호하는 출력에 확률이 더 집중된다. 그러나 전체 추론과 답을 하나의 시퀀스로 묶어 강하게 샤프닝하면, 같은 정답을 뒷받침하는 여러 추론 경로 가운데 일부만 살아남을 수 있다. 답은 같아도 표현이나 풀이 과정이 다른 경로의 지지가 사라지는 셈이다.1
DMS는 이 결합을 풀었다. 먼저 비교적 약하게 샤프닝한 추론 분포에서 여러 경로를 뽑아 탐색의 다양성을 유지한다. 이어 각 경로에 따른 답의 확률을 가중 집계해 답의 주변분포를 만들고, 이 분포에는 더 강한 샤프닝을 적용한다. 특정 풀이 하나가 아니라 여러 풀이에서 누적된 지지가 큰 답에 확률을 집중하려는 설계다. 추론과 답에 별도 지수를 적용하므로 두 단계의 집중도를 따로 조절할 수 있다.1
연구진은 샘플링 과정의 경로 붕괴도 함께 다뤘다. 유한한 수의 입자를 쓰는 순차 몬테카를로(SMC)는 재표본화가 반복될 때 높은 가중치를 받은 소수의 앞부분이 복제돼 다양성이 급감할 수 있다. 이를 완화하기 위해 DMS에는 파워 타깃을 단계적으로 강화하는 ‘완전 적응형 어닐링 SMC’가 쓰였다. 이 방식은 국소 완전 적응 제안분포와 예측형 조상 재표본화를 결합한다.1
다만 공개된 초록에는 모델별 점수, 연산량, 비교 기법과의 격차가 제시되지 않았다. 또 이번 결과는 세 가지 기본 모델과 네 가지 벤치마크에서 얻은 arXiv 초판 결과다. 따라서 최고 평균 pass@1이라는 결론의 크기와 비용 대비 효과는 논문 본문의 세부 실험을 함께 살펴야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Decoupled Marginal Sharpening for Training-Free Inference-Time Scaling — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.