스마트 라우팅, LLM 추론비 10분의 1로
최근 30일 조회수 — 좋아요 —핵심 요약
요청 난도에 맞춰 LLM을 배정하면 품질을 유지하며 평균 추론 비용을 약 10분의 1로 줄일 수 있다는 연구가 나왔다.
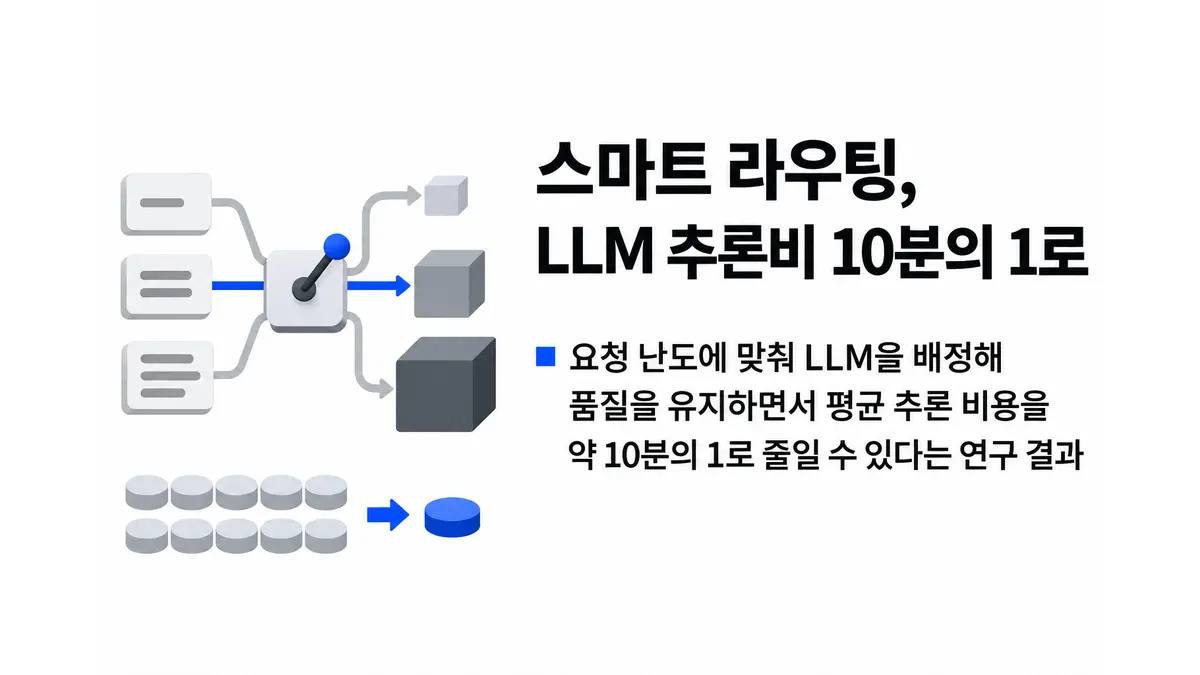
요청 난도에 따라 가장 저렴하면서도 충분한 성능을 내는 대규모언어모델(LLM)을 골라 보내면, 모든 요청을 최상위 모델로 처리할 때보다 평균 추론 비용을 약 10분의 1로 낮출 수 있다는 연구가 공개됐다. 11월 11일 arXiv에 제출된 논문은 이른바 스마트 모델 라우팅을 비용과 품질 사이의 최적화 문제로 정식화하고, 라우터 자체의 운영비까지 포함해 절감 효과를 계산했다.1
스마트 모델 라우팅은 간단한 요청은 작고 저렴한 모델에, 어려운 요청은 성능이 높고 비싼 프런티어 모델에 배정하는 방식이다. 논문에 따르면 프런티어 모델의 토큰당 가격은 특정 작업에 충분한 소형 모델보다 10배 넘게 비싼 경우가 많다. 따라서 모든 요청을 프런티어 모델로 보내는 대신, 각 요청에 적절히 답할 것으로 예상되는 모델 가운데 가장 저렴한 모델을 선택하면 전체 비용을 줄일 수 있다.
연구진은 이를 위해 모델을 전환하는 최적 임계값 정책의 구조를 도출했다. 또 라우터가 예측한 성공 확률이 실제 결과와 맞는 ‘보정’과, 쉬운 요청과 어려운 요청을 가려내는 ‘판별’을 구분했다. 예측 확률이 잘 보정돼 있더라도 요청 간 난도를 제대로 구별하지 못하면 비용 절감으로 이어지지 않을 수 있다는 뜻이다. 저가 모델에 먼저 요청한 뒤 필요할 때 상위 모델로 넘기는 캐스케이드 방식이 어느 조건에서 이득인지도 손익분기식으로 제시했으며, 모델 간 가격 차이와 트래픽 구성 변화에 따른 민감도도 분석했다.
수치 예시에서는 명시한 가격과 트래픽 가정 아래, 보정된 라우터가 혼합 추론 비용을 약 한 자릿수 배율 이상, 즉 대략 10배 줄였다. 논문은 라우팅 정책만 적용한 총절감액과 라우터 비용을 뺀 순절감액을 따로 보고했다. 기존 라우팅 시스템의 공개 결과는 비용을 약 2분의 1로 줄인 사례부터, 프런티어 모델 수준의 정확도를 비용 5분의 1로 달성한 사례까지 분포한다.
다만 이번 연구는 분석적 검토가 중심이며, 실험은 수학 문제 데이터셋 GSM8K에서 캐스케이드 구조를 검증한 수준이다. 다른 작업과 모델군으로의 확대는 후속 과제로 남았다. 요청을 필요 이상으로 낮거나 높은 등급에 보내는 오류, 전체 평균 품질이 특정 이용자 집단의 성능 저하를 가리는 문제, 보정값 변화, 라우팅 신호를 겨냥한 프롬프트 인젝션, 모델 장애와 공급자별 가격 차이도 실제 절감폭을 좌우하는 위험으로 제시됐다.
Footnotes
-
arXiv, 「Smart Model Routing for Order-of-Magnitude LLM Cost Reduction」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Smart Model Routing for Order-of-Magnitude LLM Cost Reduction — arXiv (cs.DC)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.