첫 토큰 확률로 유해 요청 탐지
최근 30일 조회수 — 좋아요 —핵심 요약
LADE는 LLM의 첫 토큰 확률 분포에 숨은 안전 신호를 활용해 탈옥 공격과 과잉 거부를 줄인다.
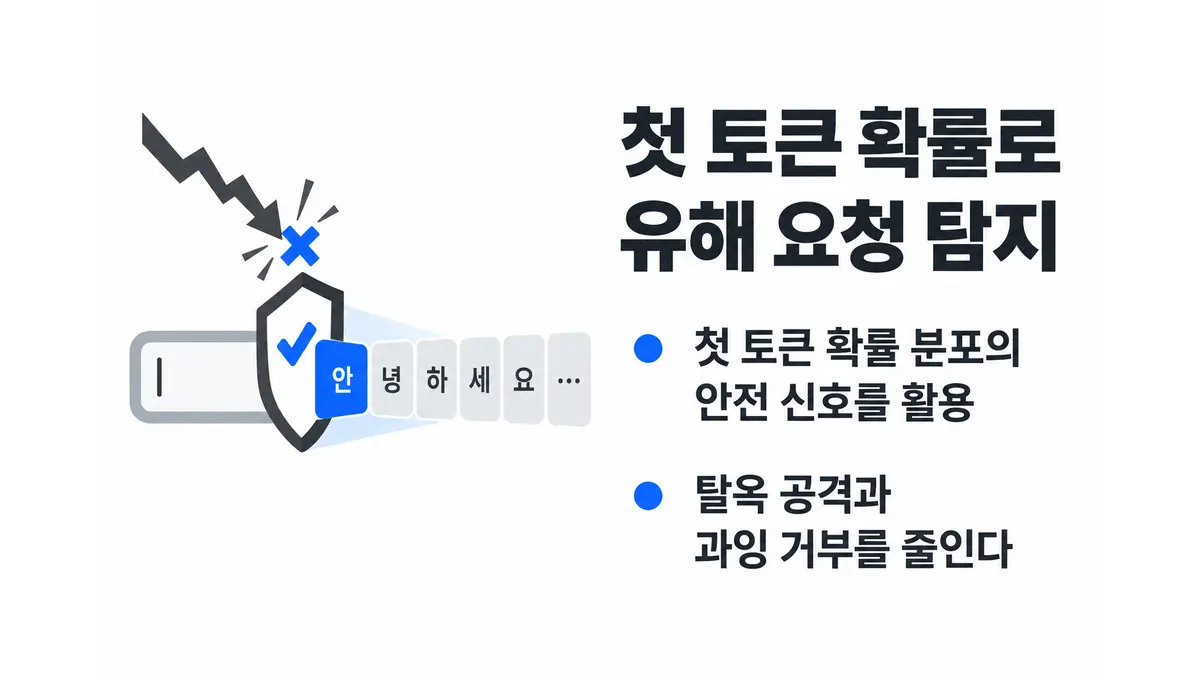
대규모언어모델(LLM)이 답변을 시작하기 전 내놓는 첫 토큰의 확률 분포에서 유해 요청을 가려내는 기법이 제안됐다. 10월 5일 아카이브(arXiv)에 공개된 논문은 출력 확률에 숨어 있는 ‘다크 놀리지(dark knowledge)’에서 모델마다 공통으로 나타나는 잠재 안전 신호를 추출해 방어에 활용하는 LADE(Latent Safety Signals for Defense)를 소개했다.1
다크 놀리지는 확률이 가장 높은 토큰 하나, 즉 최종 선택된 출력만으로는 드러나지 않는 나머지 확률 분포의 정보를 뜻한다. 연구진은 유해한 질문과 정상적인 질문을 각각 입력한 뒤 첫 토큰의 확률을 대조했다. 두 부류 사이에서 확률 차이가 뚜렷한 토큰을 잠재 안전 신호로 정의했다. 표면에 실제로 출력되는 거절 표현만 보는 대신, 모델이 답변 후보들에 부여한 미세한 확률 차이까지 안전 판단에 쓰는 접근이다.
LADE는 세 단계로 구성된다. 먼저 첫 토큰 확률 분포에서 유해·정상 요청을 잘 구분하는 상위 k개 토큰을 고른다. 이어 모델마다 다른 토크나이저의 어휘를 서로 대응시키고, 매핑된 토큰을 바탕으로 k-최근접 이웃(k-Nearest Neighbors, kNN) 검색을 수행해 입력을 분류한다. 연구진은 이런 안전 신호가 여러 LLM에서 일관된 방향으로 정렬되며, 특정 모델 구조에 묶이지 않는 특성이 안전 정렬 과정에서 나타난다고 설명했다.
기존 디코딩 단계 방어는 내부 은닉 상태를 이용하는 경우가 많아 특정 아키텍처에 종속되고, 계산 부담과 모델 간 일반화 문제가 뒤따랐다. 방어 강도를 높이면 정상 요청까지 거부하는 ‘과잉 거부’가 늘어 유용성이 떨어지는 문제도 있었다. LADE는 은닉 상태 대신 출력 확률 분포와 토큰 매핑을 활용해 이 제약을 줄이려 한다.
논문 초록에 따르면 LADE는 여러 LLM과 벤치마크에서 다양한 탈옥 공격의 성공률을 낮추면서 안전성과 유용성 사이에서 경쟁력 있는 균형을 보였다. 다만 공개된 자료에는 모델별 공격 성공률, 과잉 거부율, 계산 비용 같은 구체적 수치가 없어 개선 폭과 실제 운영 환경의 부담은 확인하기 어렵다. 또한 이 결과는 2026년 10월 5일 제출된 초판 논문의 연구진 보고에 근거한다.
Footnotes
-
arXiv, “Safeguarding LLMs via Model-Agnostic Latent Safety Signals from Dark Knowledge” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.