요청별 실행 경로 조정하는 LLM 서빙 모프
최근 30일 조회수 — 좋아요 —핵심 요약
모프는 요청 특성에 따라 하이브리드 LLM 실행 경로를 선택해 처리량을 최대 3.87배 높였다.
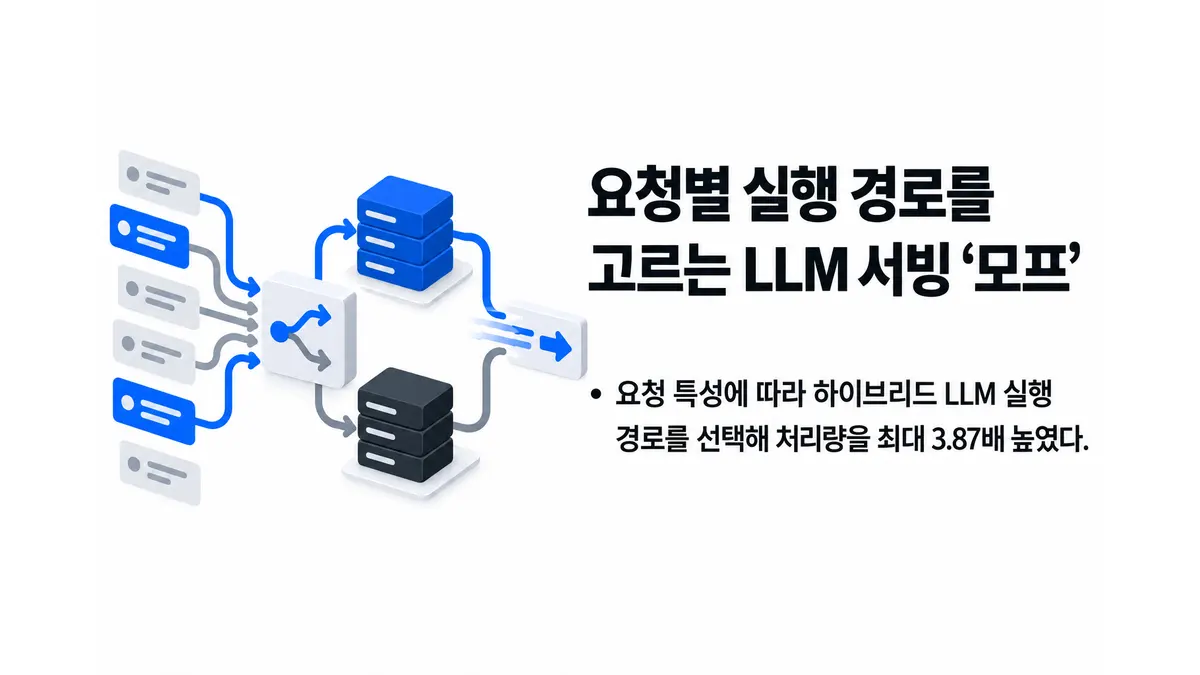
요청마다 문맥을 활용하는 방식이 다르다는 점을 반영해 하이브리드 대규모언어모델(LLM)의 실행 경로를 조정하는 서빙 시스템 모프(Morph)가 공개됐다. 연구진은 모델 구조와 실행 환경을 함께 설계한 모프가 기존의 정적 하이브리드 방식보다 품질과 효율의 균형을 개선했으며, 시스템 평가에서는 기준 방식보다 처리량을 최대 3.87배 높이고 추론 지연도 크게 줄였다고 밝혔다.1
하이브리드 LLM은 문맥을 처리하는 어텐션(Attention)의 모델링 능력과 상태공간모델(State Space Model·SSM)의 효율을 결합한다. 그러나 기존 모델은 어텐션 계층과 SSM 계층의 배치를 한 번 정하면 모든 요청을 같은 순서로 처리한다. 실제 서빙 환경에서는 요청마다 필요한 문맥 정보와 그 활용 방식이 다른데도 하나의 고정된 계층 구성을 적용하는 셈이다. 연구진은 이 ‘한 가지 배치로 모든 요청을 처리하는’ 구조를 비효율의 원인으로 지목했다.1
모프는 각 블록 안에 어텐션 계층과 SSM 계층을 짝지어 배치한 뒤, 프리필(prefill) 단계에 맞춘 게이팅으로 요청별 실행 구성을 고른다. 프리필은 입력 문맥을 먼저 처리하는 구간이다. 여기서 선택한 구성은 토큰을 하나씩 생성하는 디코딩이 끝날 때까지 유지된다.1
요청별로 선택한 계층이 달라지면 여러 요청을 묶어 처리하는 배칭의 효율이 떨어질 수 있다. 모프의 런타임은 선택적 배칭으로 서로 다른 계층 선택을 수용한다. 또 하이브리드 구성을 인식하는 문맥 캐시를 사용해, 앞부분이 같은 요청에서 기존 계산 결과를 올바르게 재사용하도록 했다. 요청 적응형 모델 구조만 제안한 것이 아니라 실제 서빙에서 필요한 배칭과 접두부 재사용까지 함께 다룬 점이 핵심이다.1
논문은 6개 데이터셋에서 정적 하이브리드 기준 모델보다 나은 품질·효율 절충점을 얻었다고 보고한다. 다만 공개된 초록에는 데이터셋과 기준 모델의 명칭, 절대 처리량, 지연시간 감소 폭, 최대 3.87배 향상이 나온 조건이 제시되지 않았다. 또한 2026년 10월 27일 제출된 arXiv 초판이므로, 수치의 적용 범위를 판단하려면 본문 실험 설정을 함께 확인해야 한다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Request-Adaptive Execution for Efficient Hybrid LLM Inference — arXiv (cs.DC)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.