TokenRouter, LLM 디코딩 처리량 최대 64배 향상
최근 30일 조회수 — 좋아요 —핵심 요약
토큰 단위로 LLM을 전환하는 TokenRouter가 지연 배칭으로 기존 대비 2.01~64.15배 처리량을 기록했다.
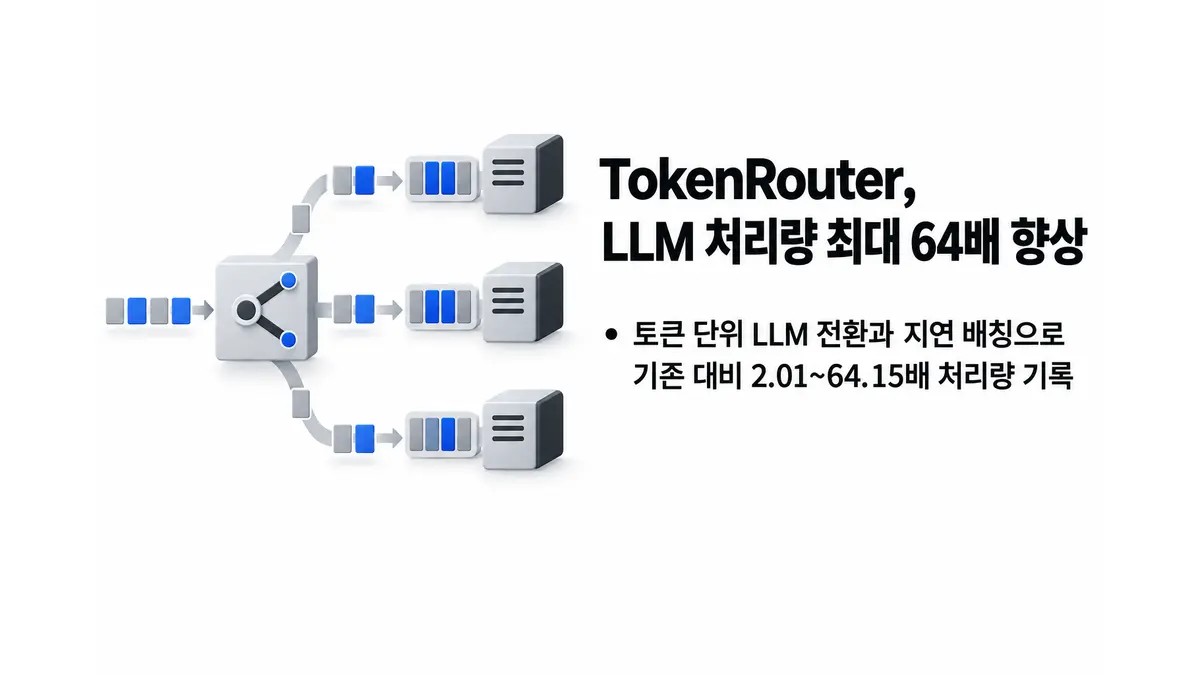
토큰라우터(TokenRouter) 연구진이 대규모 언어 모델(LLM)을 토큰 단위로 전환하며 추론하는 서빙 시스템을 제안했다. 2026년 10월 8일 arXiv에 공개된 논문에 따르면, TokenRouter는 여러 라우팅 알고리즘과 작업 부하, 모델 조합에서 기존 시스템보다 디코딩 처리량을 2.01배에서 64.15배 높였다. 비용과 답변 품질 사이의 균형을 개선할 가능성이 알려졌지만 실제 서빙이 어려웠던 토큰 단위 라우팅을 시스템 설계로 뒷받침했다는 것이 논문의 핵심이다.1
기존 LLM 라우팅은 대체로 세션이나 질의 전체를 어느 한 모델에 맡긴다. 반면 토큰 단위 라우팅은 답변을 생성하는 도중에도 토큰마다 사용할 모델을 달리할 수 있다. 최근 알고리즘 연구에서는 이 방식이 효율과 품질을 크게 높일 수 있다고 보고했지만, 현재 서빙 시스템은 하나의 LLM이 요청을 끝까지 처리한다는 가정 아래 만들어졌다. 그 결과 여러 모델을 오가는 요청에서는 생성 단계의 진행 시점이 심하게 어긋나고, 새 요청을 배치에 넣는 작업도 자주 지연된다고 연구진은 설명한다.1
TokenRouter는 이를 ‘요청 중심 프로그래밍, 모델 중심 실행’이라는 원칙으로 풀었다. 개발자는 단일 요청의 관점에서 모델 전환 규칙을 작성하고, 런타임은 LLM마다 별도의 서브서버를 띄운 뒤 요청을 비동기로 보낸다. 각 서브서버에는 요청을 즉시 묶지 않고 잠시 기다렸다가 배치를 구성하는 지연 배칭(delayed batching) 스케줄러가 들어간다. 연구진은 시스템 처리량을 나타내는 수학적 모델을 세우고, 이를 바탕으로 스케줄러의 최적 하이퍼파라미터를 도출했다. 개발자가 여러 모델의 실행과 동기화를 직접 구현해야 하는 부담도 줄이는 설계다.1
다만 공개된 초록만으로는 비교 대상 시스템, 사용한 하드웨어와 모델 이름, 절대 처리량을 확인할 수 없다. 2.01~64.15배라는 개선 폭이 큰 만큼 어떤 조건에서 최솟값과 최댓값이 나왔는지 살펴봐야 한다. 또 이 결과는 arXiv에 제출된 초판 논문의 연구진 보고이며, 운영 환경에서 같은 성능이 재현됐다는 뜻은 아니다. 연구진은 코드를 공개했다고 밝혔지만, 출처 자료에는 저장소 주소가 구체적으로 제시되지 않았다.1
Footnotes
-
arXiv, 「TokenRouter: Efficient Serving System for Token-Level LLM Routing」, 2026년 10월 8일, http://arxiv.org/abs/2610.12242v1 ↩ ↩2 ↩3 ↩4
읽기 목록은 이 브라우저에 저장됩니다.
출처
- TokenRouter: Efficient Serving System for Token-Level LLM Routing — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.