HAWK, GPU·NPU 간 KV 캐시 전송 최적화
최근 30일 조회수 — 좋아요 —핵심 요약
HAWK는 KV 캐시를 직접 전송해 LLM 이기종 추론의 전력·비용 효율을 각각 최대 1.26배·1.72배 높였다.
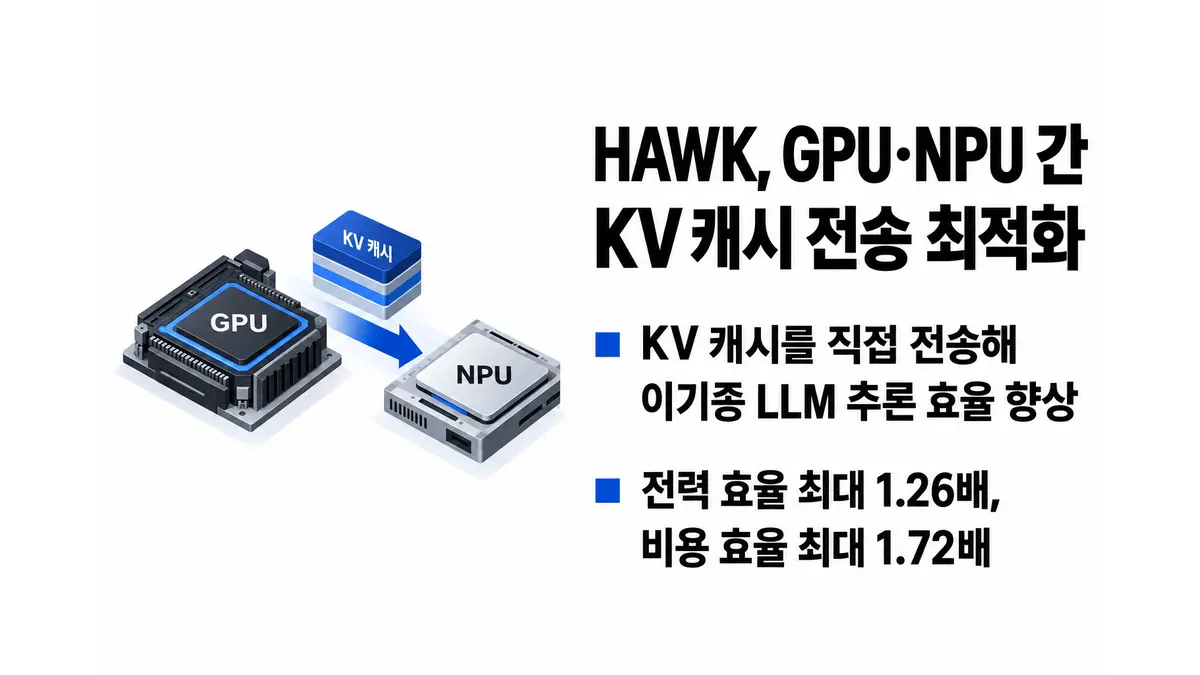
HAWK는 대규모언어모델(LLM)의 입력 처리와 토큰 생성을 GPU와 NPU에 나눠 맡길 때 필요한 KV 캐시 전송을 빠르게 하는 기법이다. 연구진은 GPU가 연산 집약적인 프리필(prefill)을, NPU가 메모리 대역폭의 영향을 크게 받는 디코드(decode)를 처리하도록 구성하고, 두 장치 사이에서 KV 캐시를 곧바로 옮기는 전송 경로를 설계했다.1
프리필은 사용자의 전체 입력을 한꺼번에 처리하는 단계라 GPU의 연산 성능을 활용하기 좋다. 반면 토큰을 하나씩 생성하는 디코드에서는 GPU의 연산 자원이 충분히 활용되지 않을 수 있다. 연구진은 NPU가 이 단계에서 연산 자원을 더 효율적으로 쓸 수 있다고 보고, 각 장치가 잘하는 작업을 맡기는 분리형 추론 구조를 택했다.
문제는 프리필 결과인 KV 캐시를 GPU에서 NPU로 넘겨야 한다는 점이다. 두 장치는 통신 방식뿐 아니라 KV 캐시의 텐서 레이아웃도 다를 수 있다. 전송을 마친 뒤 NPU 형식에 맞춰 데이터를 다시 배열하면 추가 복사와 처리 시간이 생겨, 장치를 분리해 얻은 이점이 줄어든다.
HAWK는 RDMA(Remote Direct Memory Access·원격 직접 메모리 접근) 경로를 만들어 장치 간 직접 전송을 수행한다. 동시에 NPU 쪽에는 목표 텐서 배치에 맞춘 RDMA 버퍼를 할당한다. 이어 연속적으로 배치된 일반 GPU RDMA 버퍼의 데이터를 대응하는 NPU 버퍼로 나눠 전송한다. 이 방식에서는 전송 과정 자체가 배치 차이를 흡수하므로, NPU가 별도의 데이터 재배열 없이 받은 텐서를 바로 사용할 수 있다.1
연구진이 상용 GPU와 NPU로 구성한 시스템에서 HAWK를 평가한 결과, 같은 서비스 수준 목표(SLO)를 적용했을 때 성능은 GPU 전용 시스템의 7.88% 이내 범위에 머물렀다. 대신 전력 효율은 최대 1.26배, 비용 효율은 최대 1.72배 높았다.1 이는 HAWK가 서로 다른 텐서 레이아웃을 전송 과정에서 처리하면서 전송 효율을 유지할 수 있음을 보여준다.
다만 이 수치는 연구진이 구축한 특정 상용 GPU·NPU 시스템의 실험 결과다. 논문 초록만으로는 사용한 모델과 하드웨어 구성, 부하 조건에 따른 성능 변화까지 확인할 수 없으며, 2026년 10월 21일 제출된 arXiv 초판이라 동료평가를 거친 결과도 아니다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- HAWK: Heterogeneity-Aware KV Cache Transfer for Efficient GPU-NPU Phase-Disaggregated LLM Inference — arXiv (cs.DC)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.