엔비디아 다이나모, 세션 인식 추론 공개
최근 30일 조회수 — 좋아요 —핵심 요약
다이나모가 에이전트의 연속된 LLM 요청을 세션으로 묶어 KV 캐시 재사용과 추론 효율을 높인다.
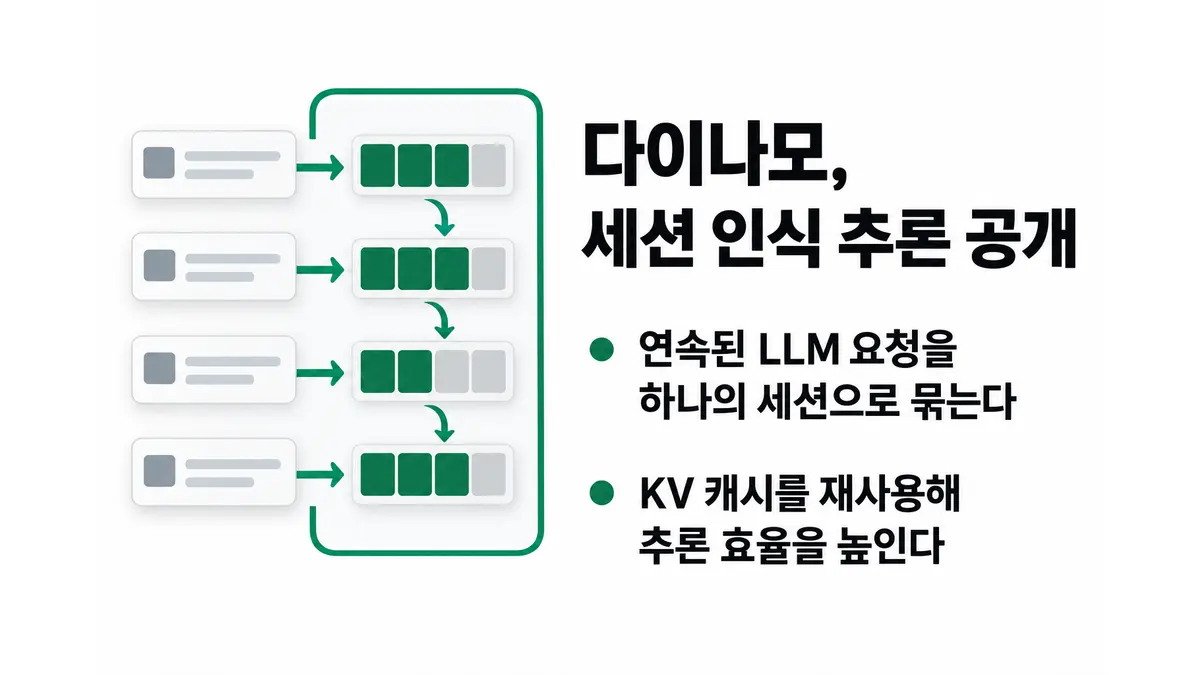
엔비디아 다이나모(NVIDIA Dynamo)가 에이전트의 도구 실행 사이에도 키·값 캐시(KV cache)를 유지하고 재사용할 수 있도록 세션 인식 추론 기능을 공개했다. 핵심은 같은 작업에서 발생한 여러 대규모언어모델(LLM) 요청을 하나로 묶는 안정적인 session_id다. 요청을 낱개로 처리하던 추론 인프라가 에이전트의 작업 흐름과 하위 에이전트까지 인식하게 만드는 장치다.1
일반 챗봇은 사용자와 모델이 차례로 대화하지만, 에이전트는 한 번의 요청을 처리하면서 모델을 거듭 호출하고 중간에 도구를 실행한다. 코딩 에이전트의 첫 입력에는 시스템 프롬프트, 도구 정의, 사용자 지침 등 수만 개 토큰이 들어갈 수 있으며, 이후 호출은 늘어난 문맥 전체를 다시 보낸다. 하나의 작업이 수십 차례 호출로 갈라지고 수명이 서로 다른 하위 에이전트가 병렬로 움직이기도 한다. 생성보다 도구 실행을 기다리는 시간이 길어도 문맥은 KV 캐시에 남아 있어야 하므로, 캐시를 얼마나 오래 보존하고 동시에 몇 개 세션을 수용하느냐가 지연시간을 좌우한다.1
다이나모는 한 추론 경로에 속한 모든 LLM 요청에 같은 session_id를 붙인다. 하위 작업에는 보통 parent_session_id도 지정해 상위 에이전트와의 관계를 추적한다. 기존 에이전트 실행 프레임워크의 헤더에서 식별자를 읽을 수 있고, 자체 프레임워크도 같은 정보를 전달할 수 있다. 이를 바탕으로 라우터는 이전 문맥이 남은 위치를 고려해 요청을 배치하고, 세션별 작업 집합을 반영해 입장 제어와 역압을 적용한다. 도구 호출 경계에서 요청 유입을 조절해 캐시가 반복해서 밀려나는 현상도 줄이는 방식이다.1
세션 정보는 관측과 재현에도 쓰인다. 연결된 추적 기록으로 에이전트 실행과 추론 성능을 함께 살피고, 오프라인 시뮬레이션이나 실제 환경 벤치마크에 재생할 수 있다. 다이나모는 vLLM과 SGLang에 걸쳐 KV 캐시 색인을 공유하고, 메모리 계층 사이에서 캐시를 옮기는 정책 의도를 전달한다. 실제 이동은 추론 엔진이 맡는다.1
다만 공개된 구성 전체가 완성 기능인 것은 아니다. 외부 저장소의 재사용 가능 KV를 라우팅에 반영하는 공유 풀 인덱서는 실험 단계이며, 캐시 제어용 KvHint 인터페이스도 제안 상태다. 또 세션 기반 최적화는 모두 선택 사항이어서, 호출 측이 일관된 세션 식별자를 제공하고 각 기능을 켜야 효과를 얻을 수 있다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Session-Aware Agentic Inference with NVIDIA Dynamo - PyTorch — PyTorch Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.