업무 그래프로 LLM 에이전트 API 수행 개선
최근 30일 조회수 — 좋아요 —핵심 요약
OData와 BPMN을 통합한 지식 그래프가 LLM 에이전트의 다단계 업무 완료율을 10.3%에서 38.7%로 높였다.
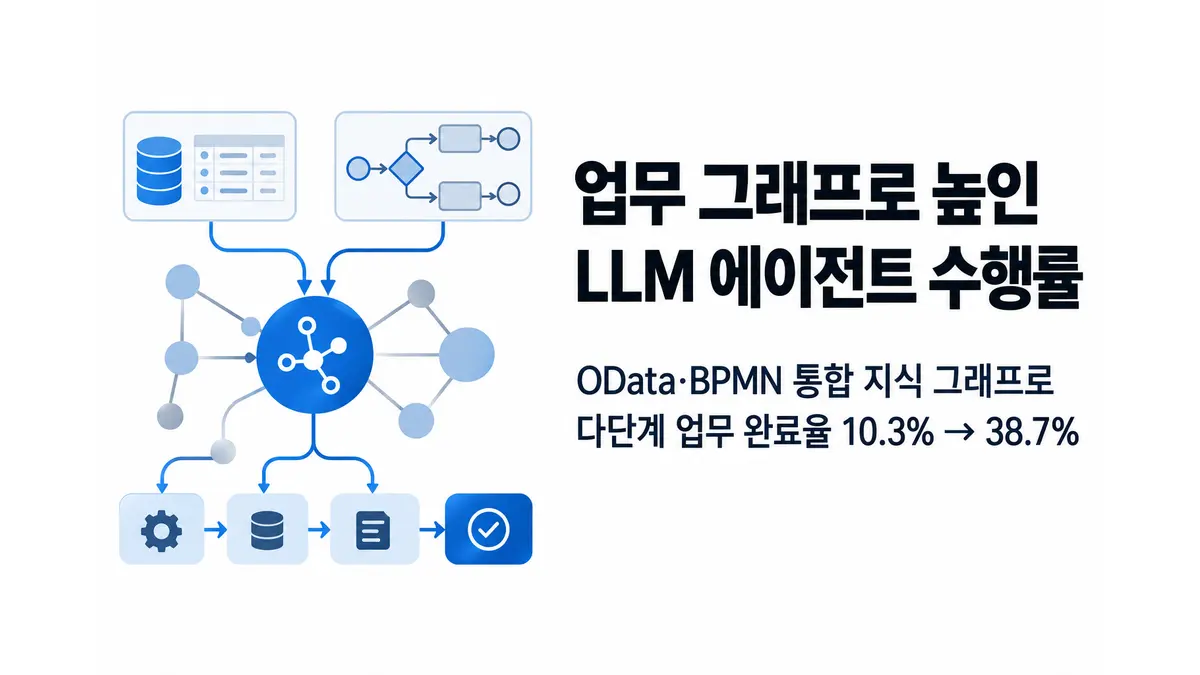
기업용 API를 호출하는 대규모 언어 모델(LLM) 에이전트가 업무 순서와 입력 스키마를 함께 참조하도록 만드는 기법이 제안됐다. 10월 27일 arXiv에 공개된 논문은 OData(Open Data Protocol) 메타데이터와 BPMN(Business Process Model and Notation) 참조 프로세스를 ‘타입이 지정된 속성 그래프’로 통합했다. 실험에서 이 구조를 활용한 에이전트의 다단계 업무 완료율은 38.7%로, 문서 조각을 검색하는 기준 방식의 10.3%보다 28.4%포인트 높았다.1
기존 검색 증강형 서비스 탐색은 API 엔드포인트를 각각 독립된 검색 대상으로 취급한다. 이 방식은 사용자의 표현과 API 설명이 비슷하면 후보를 찾을 수 있지만, 어떤 엔드포인트를 먼저 호출해야 하는지, 다음 단계가 무엇인지, 요청 본문에 어떤 키와 코드값을 써야 하는지는 놓치기 쉽다. 기업 API에서는 올바른 기능을 찾는 것만큼 호출 순서와 유효한 입력을 지키는 일이 중요하다는 게 논문의 문제의식이다.
연구진은 API의 필드와 허용값을 담은 OData 메타데이터에 BPMN 업무 흐름을 결합했다. 하이브리드 검색기는 밀집 임베딩으로 첫 엔드포인트 후보를 찾은 뒤, 그래프의 프로세스 간선을 따라 후속 엔드포인트를 가져온다. 즉 검색 결과를 의미상 가까운 API 목록에 그치지 않고, 실제 업무 절차에 맞는 호출 사슬로 확장한다.
42개 기업 서비스를 대상으로 한 검색 실험에서, 질의와 후속 엔티티 사이의 단어 중복이 적은 74개 질의는 Recall@3가 5.7포인트 올랐다. 향상 폭은 임베딩 모델과 검색 개수 기준을 바꿔도 일관됐다. 반면 나머지 질의에서는 밀집 검색과 비슷했고, 프로세스 계층이 없는 OpenAPI 서비스에서는 개선되지 않았다. 연구진은 이를 성능 향상이 단순한 메타데이터 추가가 아니라 업무 프로세스 구조에서 비롯됐다는 근거로 해석했다.
입력 오류 실험도 구조화된 문맥의 역할을 보여준다. 유효한 코드 목록만 제공하면 존재하지 않는 코드를 만드는 문제는 사라졌지만, 쓰기 작업의 46%에서 잘못된 키가 남았다. 타입·스키마·프로세스를 포함한 전체 문맥을 제공하자 잘못된 호출은 101회 중 3회, 약 3%로 줄었고 임의로 만든 코드도 없었다. 다만 다단계 질의 81개에서 최종 완료율은 38.7%에 머물렀다. 기준 방식보다 크게 나아졌지만, 업무 지식 그래프만으로 기업 API 자동화를 안정적으로 완성했다고 보기는 어렵다.
Footnotes
-
arXiv, “Grounding LLM Agents in Business Processes: Process-Aware Knowledge Graphs for Reliable Multi-Step Service Invocation” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Grounding LLM Agents in Business Processes: Process-Aware Knowledge Graphs for Reliable Multi-Step Service Invocation — arXiv (cs.SE)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.