LLM 아키텍처 연구 플랫폼 ArchSpace 공개
최근 30일 조회수 — 좋아요 —핵심 요약
ArchSpace는 소규모 실험과 스케일링 법칙으로 LLM 아키텍처를 사전 평가하고 연구 과정을 공유한다.
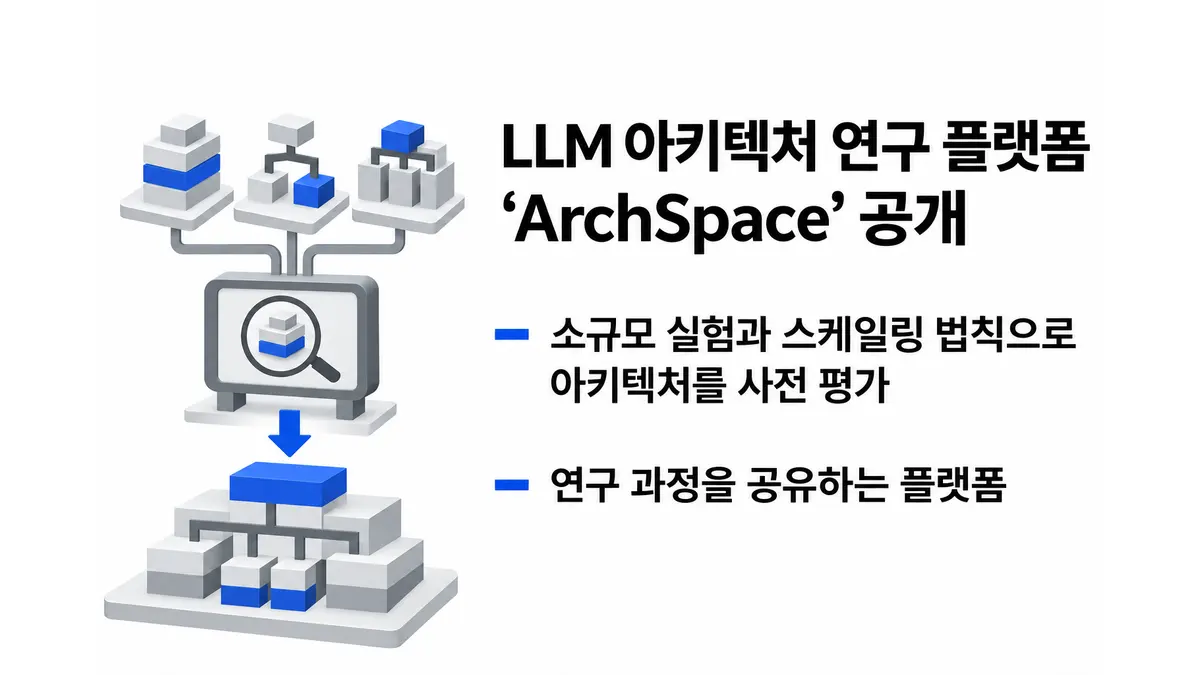
대규모언어모델(LLM) 아키텍처 연구의 실험과 판단 근거를 기록하고, 공동체가 검토하며, 후속 연구가 인용할 수 있게 만든 공개 플랫폼 ‘ArchSpace’가 공개됐다. 11월 12일 arXiv에 제출된 논문에 따르면, ArchSpace는 소규모 실험에서 얻은 결과와 스케일링 법칙을 이용해 더 큰 모델의 손실을 예측함으로써 대규모 학습 전에 아키텍처 아이디어를 평가하도록 설계됐다.1
ArchSpace가 겨냥한 문제는 산업계와 학계에서 서로 다른 형태로 나타난다. 논문 저자들은 DeepSeek, Qwen, Kimi 같은 개발팀이 아키텍처를 꾸준히 개선하지만, 공개 보고서에는 어떤 아이디어가 성공했고 무엇을 폐기했는지, 그 판단 이유가 무엇인지 충분히 남지 않는다고 지적한다. 반면 학계는 제한된 연산 자원과 일관되지 않은 기준 모델 탓에 작은 규모에서 한 차례 비교하는 데 그치는 경우가 많다. 이 결과가 모델 규모를 키웠을 때도 유지되는지, 더 넓은 연구에 영향을 줄 수 있는지 판단하기 어렵다는 설명이다.1
플랫폼의 작업 흐름은 ‘기록·검토·인용’ 세 단계로 요약된다. 연구자는 제안한 아키텍처와 함께 실험 결과, 판단 근거를 기록하고, 공동체는 이를 검토한다. 검증을 통과한 아이디어는 후속 연구가 참조하며 새로운 기준 모델로도 쓰일 수 있다. 단순히 최종 성능 수치만 모으는 대신 실패하거나 중단된 접근과 그 이유까지 연구 맥락에 포함하려는 구상이다.1
초기 비교 기반도 함께 제시됐다. 저자들은 Qwen3.5와 OLMo3 기준 모델, 데이터에 맞춰 추정한 스케일링 법칙, 재사용할 수 있는 학습 레시피를 제공한다고 밝혔다. 핵심은 산업계에서 널리 쓰인다는 소규모 실험 기반 예측을 공개 연구 절차로 옮겨, 값비싼 대규모 학습에 들어가기 전에 후보를 걸러내는 것이다.1
다만 현재 공개된 논문은 arXiv에 제출된 1차 버전이다. 플랫폼의 공동체 검토가 실제로 어떤 기준과 절차로 운영되는지, 소규모 결과에서 추정한 손실이 여러 아키텍처와 규모에서 얼마나 정확한지는 제공된 자료만으로 확인하기 어렵다. ArchSpace의 의미는 특정 아키텍처의 우위를 입증했다기보다, 흩어져 있던 실험과 판단 과정을 누적 가능한 연구 기록으로 만들겠다는 데 있다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- ArchSpace: Recording, Reviewing, and Referencing LLM Architecture Research — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.