AWS 세이지메이커, KV 캐시 인식 라우팅 추가
최근 30일 조회수 — 좋아요 —핵심 요약
프롬프트 캐시 상태와 인스턴스 부하를 함께 고려해 LLM의 중복 연산을 줄이는 라우팅 기능이다.
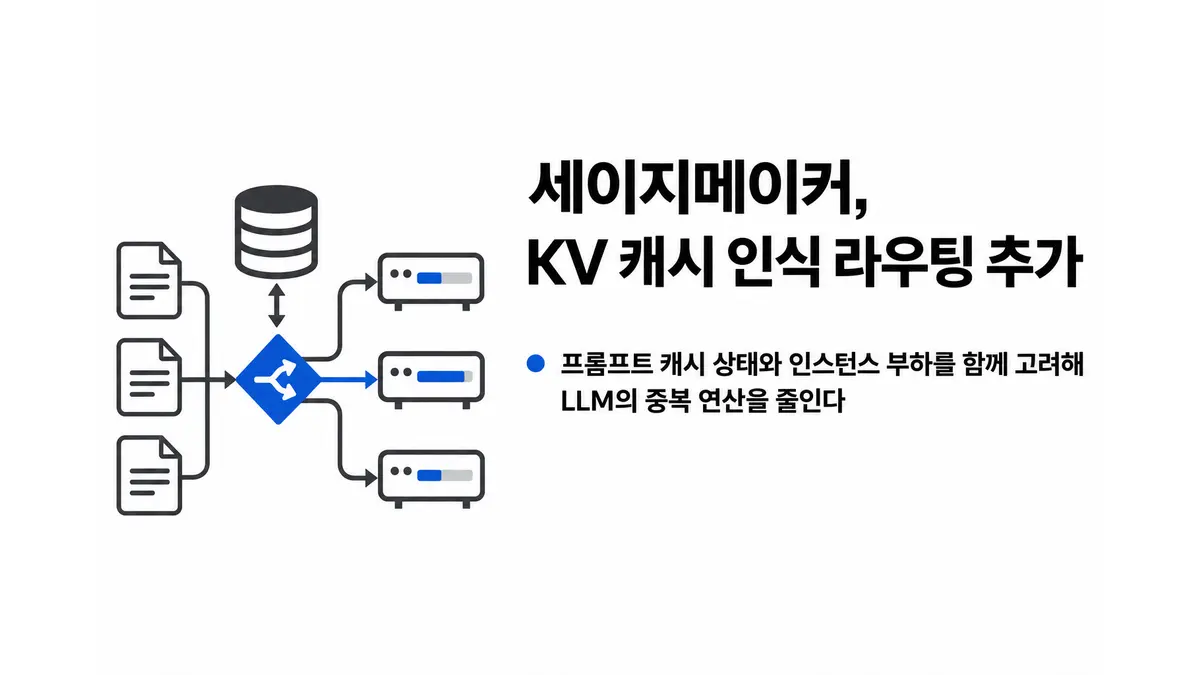
AWS가 17일 아마존 세이지메이커 AI(Amazon SageMaker AI) 실시간 엔드포인트에 ‘KV 캐시 인식 라우팅(KV-aware routing)’을 추가했다. 대규모 언어 모델(LLM)의 요청을 처리할 때 프롬프트와 가장 길게 일치하는 캐시를 보유하면서도 과부하가 덜한 인스턴스로 보내는 방식이다. 다중 턴 대화나 긴 공통 프롬프트가 반복되는 검색 증강 생성(RAG), 에이전트 서비스의 중복 연산을 줄이는 것이 목적이다.1
LLM은 프롬프트를 처리하며 만든 키-값(KV) 캐시를 GPU 메모리에 저장한다. 이후 같은 시작 부분을 포함한 요청이 동일한 인스턴스에 도착하면 이미 끝낸 계산을 건너뛸 수 있다. 문제는 여러 인스턴스로 요청을 분산할 때 어느 인스턴스에 필요한 캐시가 남아 있는지 알아야 이 이점을 살릴 수 있다는 점이다.
AWS가 앞서 선보인 접두사 인식 라우팅은 요청의 시작 부분을 해시해 같은 접두사를 지닌 요청을 같은 인스턴스로 보냈다. 해시 범위는 설정한 PrefixLength까지이며, InvokeEndpoint 페이로드에서는 바이트, 오픈AI 호환 Chat Completions API에서는 메시지 문자 기준이다. 그러나 실제 캐시 상태는 확인하지 않는다. GPU 메모리가 차서 캐시가 퇴출돼도 해당 인스턴스로 요청을 계속 보낼 수 있다. 대화 기록이 PrefixLength보다 짧은 초기에는 턴마다 해시 대상이 달라져, 앞선 대화를 캐시한 인스턴스와 다음 요청을 처리할 인스턴스가 갈릴 수도 있다.1
KV 캐시 인식 라우팅은 모델 컨테이너의 캐시 보고, 세이지메이커가 관리하는 캐시 인덱스, 이를 활용한 요청 배치로 구성된다. SM_VLLM_KV_EVENTS_CONFIG를 켜면 컨테이너가 캐시 항목을 저장하거나 퇴출할 때마다 이벤트를 보낸다. 인덱스에는 프롬프트 원문이나 토큰 ID, 요청 페이로드, KV 텐서가 아니라 캐시 내용에서 만든 단방향 축약 해시와 이를 보유한 인스턴스 또는 추론 컴포넌트 복제본의 위치만 저장된다.1
요청이 들어오면 엔드포인트는 프롬프트를 토큰화해 인덱스와 대조한다. 고정된 바이트 길이가 아니라 토큰 단위로 비교하므로 대화 기록이 길어져도 전체 이력을 따라갈 수 있고, 일부만 겹치면 가장 긴 구간을 캐시한 후보를 찾는다. 이후 캐시 일치 길이와 각 후보의 처리 부하를 함께 따져 목적지를 정한다.
도입에는 모델 환경 변수 설정과 엔드포인트 구성의 RoutingStrategy 값을 KV_AWARE로 지정하는 작업이 필요하다. 클라이언트가 호출하는 API는 바뀌지 않는다. 다만 효과는 여러 요청이 긴 시작 문맥을 공유하거나 대화 이력을 반복 전송하는 환경에서 크다. AWS가 이번 발표에서 제시한 것은 라우팅 방식과 동작 구조이며, 구체적인 지연시간이나 처리량 개선 수치는 공개된 자료에 포함되지 않았다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Amazon SageMaker AI real-time endpoints now support KV cache aware routing | Amazon Web Services — AWS Machine Learning Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.