DEF CON CTF 2026, AI보다 검증·운영이 승부 갈랐다
최근 30일 조회수 — 좋아요 —핵심 요약
LLM이 허용된 DEF CON CTF에서 AI 결과를 검증해 공격·방어 체계에 연결하는 역량이 핵심으로 떠올랐다.
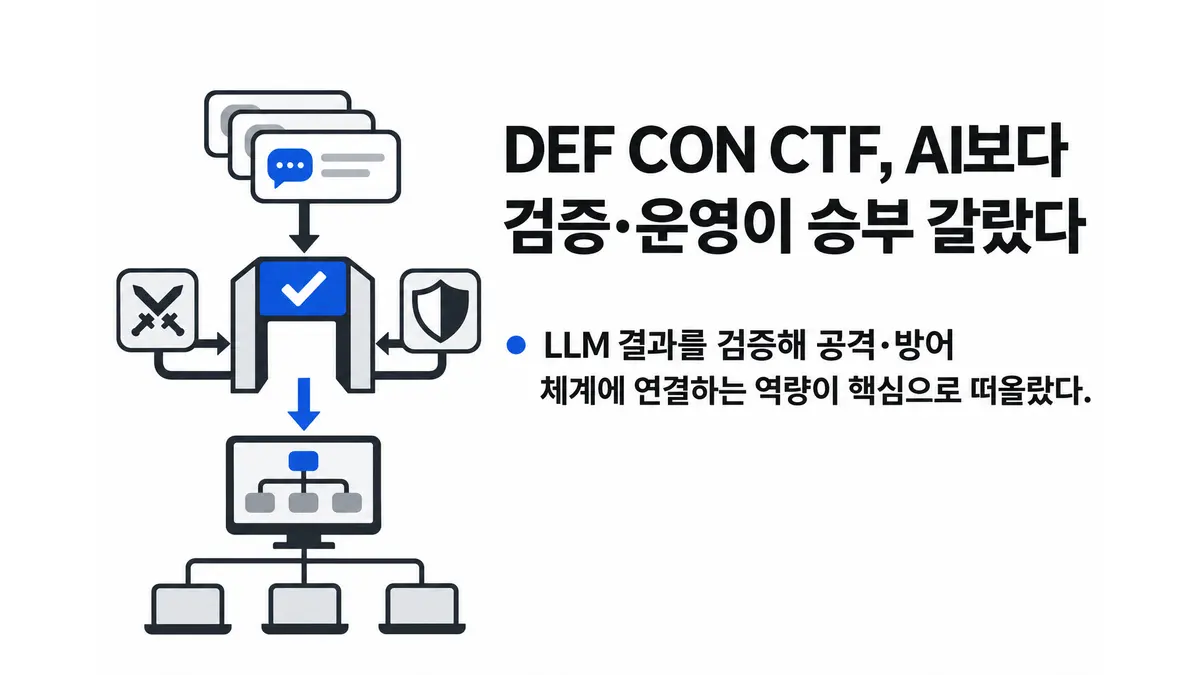
DEF CON CTF 2026은 대규모 언어 모델(LLM)과 AI 에이전트 사용을 공식 규정으로 허용했다. 그러나 승부를 가른 것은 AI가 내놓은 답 자체가 아니었다. 연합팀 ‘SuperDiceCodeLovers’로 본선 3위에 오른 LY Corporation 참가자들에 따르면, AI가 만든 취약점 후보를 검증해 실제 공격 코드와 패치로 바꾸고 팀의 반복 작업에 연결하는 역량이 핵심 경쟁 요소가 됐다.1
온라인 예선은 독립된 문제를 풀어 플래그(flag, 문제에 숨겨진 문자열)를 제출하는 Jeopardy 방식이었지만, 오프라인 본선은 공격·방어와 King of the Hill(KOTH)을 함께 치렀다. 공격·방어에서는 모든 팀이 같은 취약 서비스를 운영하면서 다른 팀의 플래그를 빼내고 자기 서비스는 정상 상태로 유지해야 했다. KOTH에서는 공동 과제에 프로그램이나 전략을 제출한 뒤, 매 경기 진행 단위인 틱(tick)의 순위에 따라 점수를 받았다. 총점에 공격, 방어, KOTH 성적이 모두 반영됐기 때문에 한 영역만 잘해서는 상위권에 오르기 어려웠다.1
시간 압박은 AI 활용 방식에도 영향을 미쳤다. 첫째 날과 둘째 날에는 틱이 5분, 마지막 날에는 3분이었고, 플래그는 생성 시점을 포함해 3개 틱 동안만 유효했다. 그 사이 취약점을 분석하고 익스플로잇(exploit, 취약점 공격 코드)을 반복 실행 가능한 형태로 만들며, 상대 패치에 맞춰 공격을 갱신해야 했다. 동시에 자기 패치를 배포하고 서비스 정상 동작 여부도 계속 확인해야 했다.1
이 환경에서 AI는 분석 속도를 높이는 도구였지만, 산출물을 곧바로 신뢰할 수 있는 정답으로 취급할 수는 없었다. SuperDiceCodeLovers는 AI 기반 취약점 분석과 익스플로잇 갱신뿐 아니라 경쟁 팀 패치 관측, 서비스 기능 검사, 배포 상태 추적까지 하나의 반복 가능한 흐름으로 묶었다. 분석 담당자와 공격 코드·패치·KOTH 담당자가 같은 틱과 점수 상태를 공유하는 협업 구조도 필요했다.1
검증이 중요한 이유는 경기 규칙에서도 드러났다. 서비스 정상 동작을 검사하는 SLA는 경기 도중 바뀔 수 있었고, 패치가 새 검사 버전을 통과하지 못하면 해당 틱에는 초기 이미지로 되돌아갔다. 경쟁 팀의 공개 패치를 분석해 공격과 방어에 활용할 수도 있었지만, 자기 패치 역시 노출될 수 있었다. 결국 AI 허용은 사람을 경쟁에서 빼낸 것이 아니라, 빠르게 생성된 후보 가운데 쓸 만한 결과를 골라 검증하고 운영 체계에 안전하게 편입하는 능력을 더 선명하게 평가했다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- DEF CON CTF 2026 본선 참가기 — LY Corporation Tech Blog Korea
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.