애플, 맥 스튜디오 4대로 8160억 LLM 추론
최근 30일 조회수 — 좋아요 —핵심 요약
애플이 MLX와 썬더볼트 RDMA로 맥 스튜디오 4대를 연결해 8160억 매개변수 LLM을 초당 36토큰 이상으로 구동했다.
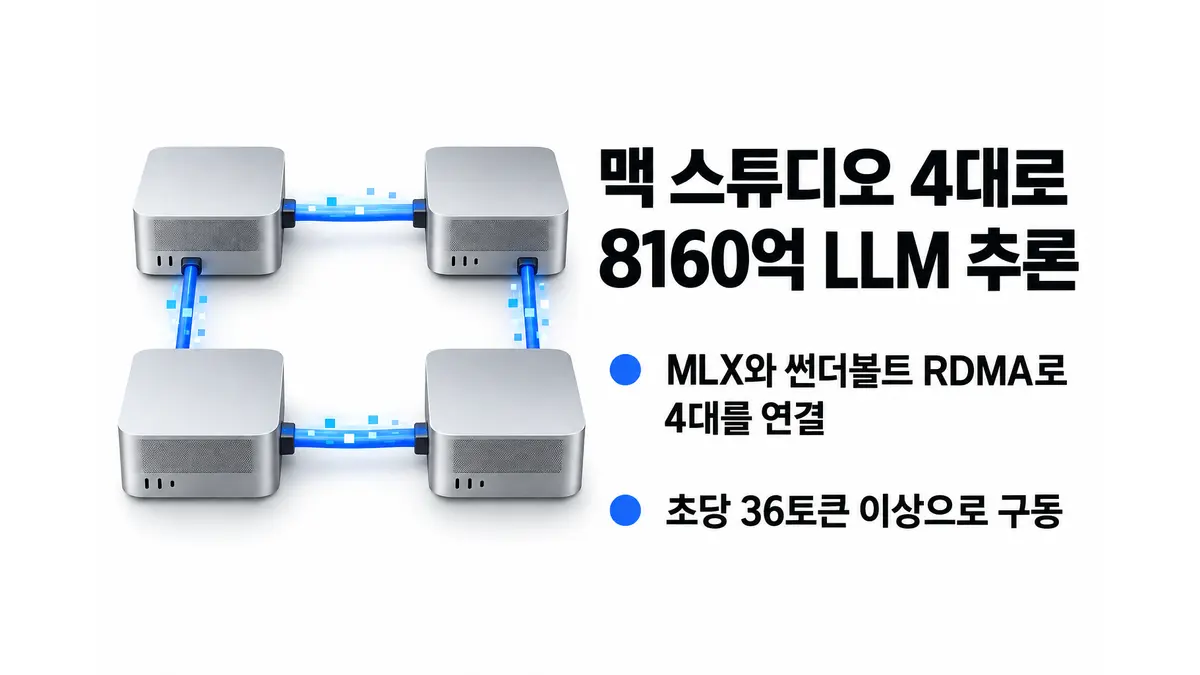
애플이 오픈소스 배열 프레임워크 MLX와 썬더볼트 기반 원격 직접 메모리 접근(RDMA)을 결합해 여러 대의 맥 스튜디오에서 대형언어모델(LLM)을 분산 추론하는 방식을 공개했다. 애플은 맥 스튜디오 4대로 구성한 클러스터에서 매개변수 8160억 개짜리 Muse Spark Open을 실행해 초당 36토큰이 넘는 생성 속도를 기록했다고 밝혔다.1
핵심은 RDMA over Thunderbolt 드라이버를 이용해 단일 맥에서 여러 맥으로 실행을 확장하는 데 있다. 단일 맥 스튜디오는 최대 512GB 통합 메모리를 제공한다. MLX는 이 구조를 활용해 로컬에서 추론과 미세조정 방법을 시험할 수 있도록 설계됐으며, 애플은 이번 발표와 함께 최신 버전을 내놨다.
애플은 M5 Ultra와 이전 세대 M3 Ultra 맥 스튜디오에서 공개 가중치 모델 세 가지를 비교했다. 모델마다 구조와 연산 정밀도가 달라 매개변수 수만으로 성능을 단순 비교하기는 어렵다.
| 모델 | 전체 매개변수 | 활성 매개변수 | 평가 정밀도 |
|---|---|---|---|
| Muse Spark Open | 8160억 | 420억 | NVFP4 |
| Mistral Medium 3.5 | 1280억 | 1280억 | FP8 |
| Qwen 3.8 | 270억 | 270억 | BF16 |
Muse Spark Open은 전문가 혼합(MoE) 구조라 추론할 때 일부 전문가와 매개변수만 활성화한다. 반면 Mistral Medium 3.5와 Qwen 3.8은 모든 매개변수를 쓰는 밀집형 모델이다. 애플은 첫 토큰이 나오기까지 걸리는 시간(TTFT), 초당 생성 토큰 수, 최대 소비전력을 측정했으며, 에이전트형 코딩처럼 긴 입력을 쓰는 작업을 고려해 문맥 길이 8,192와 65,536에서 시험했다.
단일 512GB 맥 스튜디오에서도 긴 문맥 기준 Qwen 3.8은 최대 68GB, Mistral Medium 3.5는 최대 158GB 메모리를 사용해 실행됐다. 특히 TTFT는 연산 성능의 영향을 크게 받았고, 행렬 곱셈을 전담하는 M5 Ultra GPU의 뉴럴 액셀러레이터 덕분에 M3 Ultra보다 최대 4.6배 빨랐다는 게 애플의 설명이다. 다만 이 수치는 애플이 mlx_lm.benchmark로 측정해 공개한 결과이며, 자료에는 다른 하드웨어나 네트워크 방식과의 비교는 제시되지 않았다.
Footnotes
-
Apple Machine Learning Research, 「Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio — Apple Machine Learning Research
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.