허깅페이스, 공공 연구 AI 활용 지원
최근 30일 조회수 — 좋아요 —핵심 요약
프로젝트 프로토스타는 공공 연구의 데이터·모델·코드를 AI가 검색하고 재사용하기 쉽게 표준화한다.
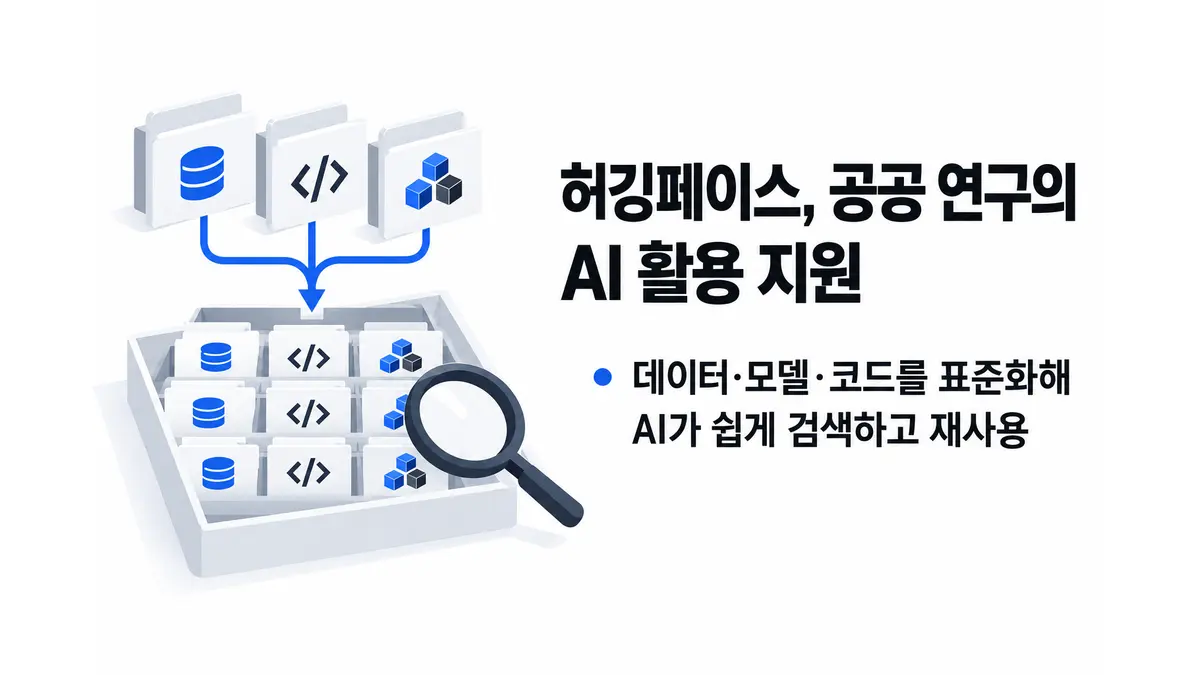
허깅페이스(Hugging Face)가 공공 재원으로 만든 논문 밖 연구 성과를 인공지능이 찾고 재사용하기 쉽게 정비하는 ‘프로젝트 프로토스타(Project ProtoStar)’를 출범했다. 대학과 연구기관이 데이터셋·모델·코드를 기계가 처리할 수 있는 형식으로 공개하도록 돕고, 공개 도전 과제로 실제 활용 가치를 검증하는 구상이다. 첫 과제인 ‘기후 위험 인텔리전스’는 카네기멜런대학교가 주관하며 11월 2일 시작한다.1
프로토스타가 겨냥한 문제는 ‘공개’와 ‘사용 가능’ 사이의 간극이다. 허깅페이스에 따르면 미국 연방정부는 연구개발에 매년 약 1,900억 달러를 투자하고 있으며, 미국 국립보건원(NIH)과 국립과학재단(NSF)은 지원 연구 출판물의 공개 요건을 강화하고 연구자에게 기초 데이터 공유 계획을 세우도록 요구하고 있다. 그러나 데이터와 코드는 서로 호환되지 않는 시스템에 흩어져 있거나 오래된 정적 형식으로 저장되는 경우가 많다. 문서, 메타데이터, 출처 이력도 부족해 다른 연구자가 연구 성과를 이해하고 재사용하기 어렵고, AI가 여러 분야의 자료를 검색·해석·결합하기는 더 어렵다는 게 허깅페이스의 설명이다.
참여 기관은 양해각서를 맺고 공개하기에 적합한 연구 데이터셋과 모델, 코드를 개방형 인프라에 AI가 처리하기 쉬운 형식으로 올린다. 창립 파트너에는 카네기멜런대·퍼듀대·조지아공대·애리조나주립대·조지워싱턴대가 참여한 오픈 포럼 포 AI(Open Forum for AI), 아스테라 인스티튜트(Astera Institute), 커뮤니티 파트너 ORCA(Open Research Community Accelerator)가 포함됐다. 허깅페이스는 인프라를 맡는다.
이미 공개 자원의 양과 증가세는 확인된다. 허깅페이스에는 유전체학, 단백질 설계, 화학, 기후, 지구 관측, 천문학 등 핵심 과학 분야의 공개 데이터셋이 1만7,000개 넘게 올라와 있다. 의학과 수학까지 합치면 약 2만9,000개이며, 과학 모델 수도 비슷한 수준이다. 2026년 1~9월 새로 공유된 과학 데이터셋은 2025년 같은 기간의 3배를 넘었다.1
다만 이는 자료를 한곳에 모으는 사업에 그치지 않는다. 형식과 문서화, 메타데이터, 출처 이력은 공개된 연구 성과를 이해하고 재사용하는 데 필요한 요소다. 허깅페이스가 공개한 현황은 공유 수요를 보여주지만, 첫 도전 과제가 실제로 연구 재사용성과 AI 검색 성능을 얼마나 높이는지는 아직 검증 전이다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Announcing Project ProtoStar: Making Publicly Funded Science AI-Ready — Hugging Face Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.