문맥 압축으로 장기 작업 비용 낮춘다
최근 30일 조회수 — 좋아요 —핵심 요약
작업 상태를 자주 압축하면 긴 문맥 없이도 정확도를 유지하며 장기 추론 비용을 줄일 수 있다는 연구가 나왔다.
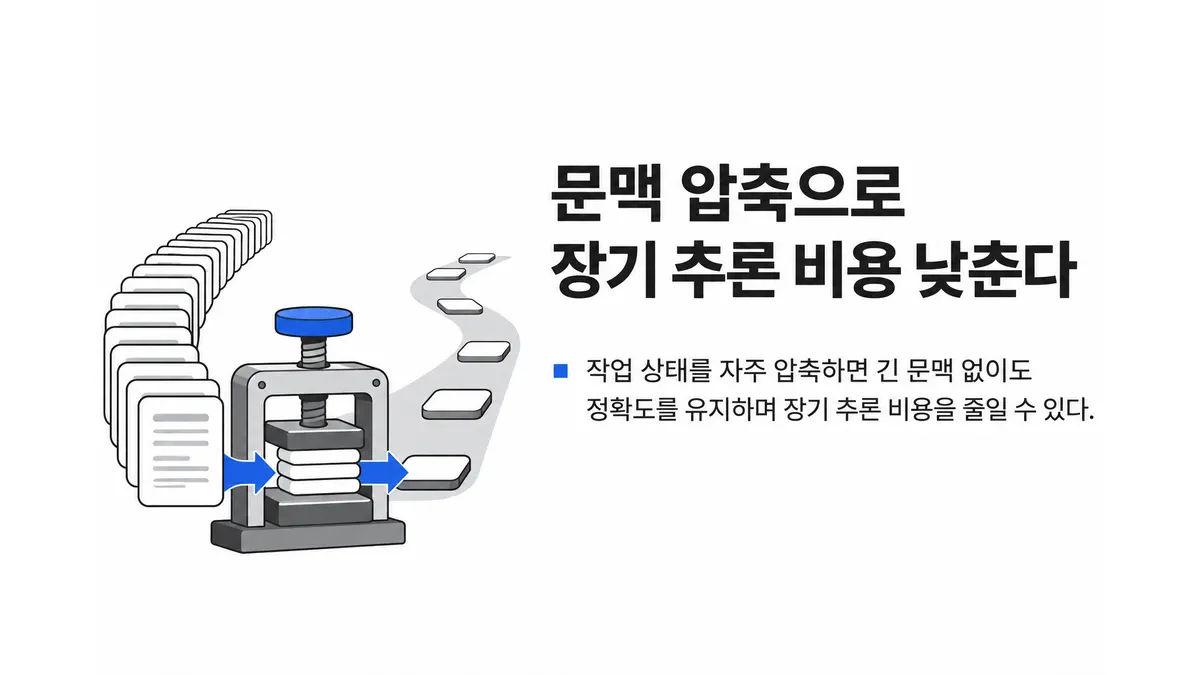
긴 문맥을 계속 유지하는 대신 작업 상태를 자주 압축하면 장기 작업의 추론 비용을 낮추면서도 정확도를 거의 그대로 지킬 수 있다는 연구가 공개됐다. 11월 3일 arXiv에 제출된 논문 「You don’t need long context」는 긴 문맥을 언어 모델의 필수 조건으로 보는 통념에 의문을 제기한다.1
논문은 토큰의 위치에 따라 생성 비용이 달라진다고 설명한다. 문맥이 누적된 뒤 생성하는 후반부 토큰은 초반부 토큰보다 비싸며, 최첨단 오픈 웨이트 모델에서는 그 격차가 최대 7배까지 벌어질 수 있다고 논문은 설명한다. 긴 작업 기록을 매번 통째로 읽게 하면 작업이 진행될수록 추론 비용이 커지는 셈이다.
연구진은 이를 줄이기 위해 문맥을 짧게 유지하면서 진행 상황을 빈번하게 압축하는 방식을 여러 장기·장문 입력 과제에 적용했다. 그 결과 최첨단 언어 모델의 과제 정확도는 거의 떨어지지 않거나 아예 차이가 없었다.
장기 소프트웨어 엔지니어링 과제에서는 더 극단적인 조건도 시험했다. 모델이 한 문맥에서 최대 한 번만 행동하도록 제한했는데도 성능이 무너지지 않았다. 연구진은 이 결과를 토대로 ‘의미 상태 공간 모델(semantic state space models, SSSMs)’이라는 개념을 제시했다. 이 접근이 성립한다면 장기 작업 능력을 확보하기 위해 문맥 창 자체를 계속 늘리는 것만이 유일한 해법은 아니다.
최대 7배라는 수치도 모든 모델과 작업에 공통으로 적용된다고 볼 근거는 제시되지 않았다. 현재 결과는 2026년 11월 제출된 arXiv 초고의 연구진 보고이며, 자료에는 동료평가 여부가 명시돼 있지 않다.
Footnotes
-
arXiv, 「You don’t need long context」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- You don't need long context — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.