음성 딥페이크 출처까지 찾는 VeriSpoof
최근 30일 조회수 — 좋아요 —핵심 요약
VeriSpoof는 한 모델로 음성 딥페이크 탐지부터 생성 도구·합성 구간·공통 출처 분석까지 수행한다.
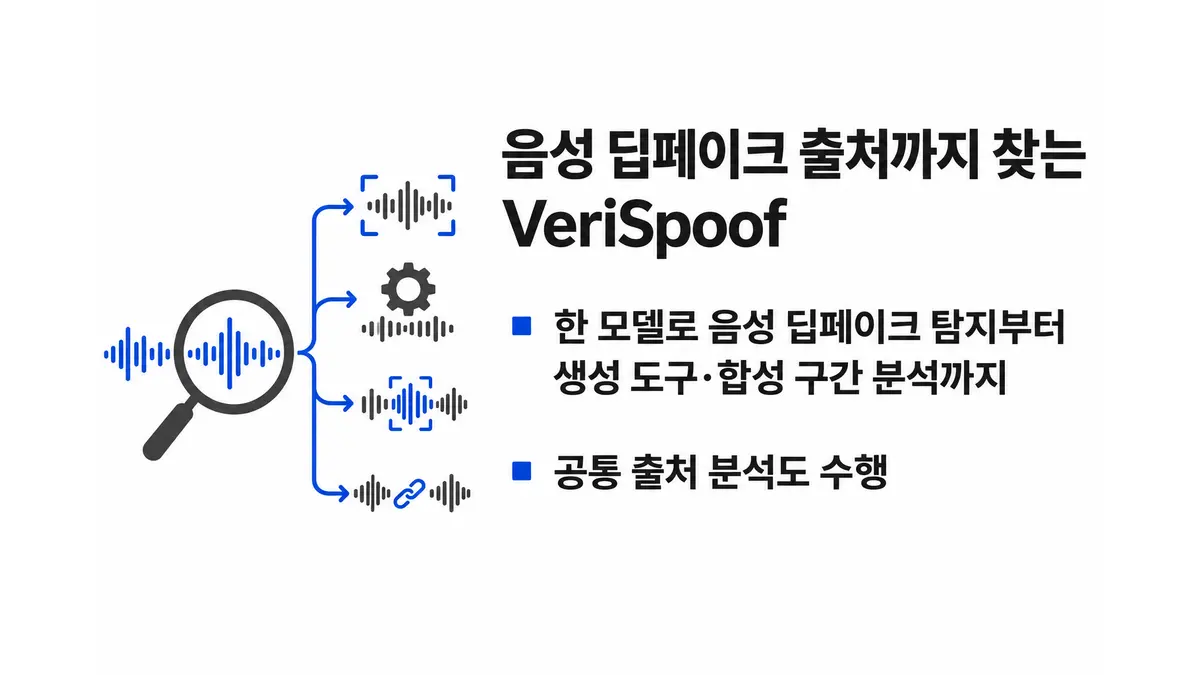
VeriSpoof 연구진이 음성 딥페이크의 진위만 가리는 데서 나아가 제작 도구와 합성 구간, 녹음 조건, 공통 출처까지 분석하는 오디오 언어 모델을 제안했다. 11월 3일 공개된 논문에 따르면 VeriSpoof는 하나의 가중치로 다섯 가지 포렌식 작업을 수행하며, 판단마다 파형이나 생성기 메타데이터로 따로 검증할 수 있는 근거 문장을 제시한다.1
기존 탐지기가 “진짜인가, 합성인가”에 답한다면, VeriSpoof는 어떤 생성기·음향 모델·보코더가 음성을 만들었는지 추적한다. 합성된 구간의 위치와 녹음 조건을 분석하고, 두 녹음이 같은 생성 시스템에서 나왔는지도 확인한다. 별도의 판별 헤드 대신 답변 문장의 생성 확률을 점수로 사용해 딥페이크 탐지와 출처 검증의 임계값을 정한다. 또 반사실적 사례를 학습에 넣어, 결론이 모델의 막연한 추측이 아니라 제시된 증거를 따르도록 설계했다.
성능은 다음과 같다.
| 모델·평가 | 결과 |
|---|---|
| VeriSpoof-Plus, Speech-DF-Arena 14개 시험 세트 통합 | EER 2.14% |
| VeriSpoof-Base, 공식 학습 분할만 사용 | EER 4.43% |
| 미학습 생성기의 공통 출처 검증 | EER 6.2% |
| PartialEdit 부분 합성 탐지: 검증 가능한 근거 사용 | 99.6% |
| PartialEdit 부분 합성 탐지: 단일 단계 답변 | 78.4% |
EER은 동일 오류율로, 낮을수록 탐지 성능이 좋다. VeriSpoof-Plus는 Speech-DF-Arena의 28개 시스템 가운데 3위였고, 가중치가 공개된 시스템 중에서는 1위였다. VeriSpoof-Base의 4.43% EER도 다음 공개 가중치 탐지기의 절반에 못 미쳤다. 특히 검증 가능한 근거를 사용하자 PartialEdit에서 단일 단계 답변이 놓친 부분 합성을 잡았고, 학습에서 보지 못한 편집에서도 근거 문장이 99.5%의 비율로 결정을 좌우했다.
통제 실험에서는 역할 분담도 드러났다. 오디오 표현은 진위 탐지를, 대규모 언어 모델(LLM)은 녹음 간 비교를 주로 담당했다. 신경 코덱으로 만든 가짜 음성을 다루려면 출처 감독 학습이 필요했다. 전체 28억5천만 개 매개변수 중 갱신한 것은 2천970만 개이며, 그래디언트 체크포인팅을 쓰면 24GB GPU 한 대에서 학습할 수 있다.
다만 이 결과는 2026년 11월 제출된 arXiv 사전 논문에 담긴 연구진의 보고다. 연구진은 두 모델과 추론 코드, 데모, 평가 도구인 VeriSpoof-Bench를 공개했지만, 본 자료에는 외부 재현 결과나 실제 수사 환경에서의 검증 내용은 제시되지 않았다.
Footnotes
-
arXiv, 「VeriSpoof: Beyond Real or Fake with One Audio LLM」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- VeriSpoof: Beyond Real or Fake with One Audio LLM — arXiv (cs.CR)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.