엔비디아, DGX 두 대로 GLM-5.3 분산 서빙
최근 30일 조회수 — 좋아요 —핵심 요약
엔비디아가 464GB 규모 GLM-5.3을 두 DGX Station에 분산해 단일 API로 서빙하는 구성을 공개했다.
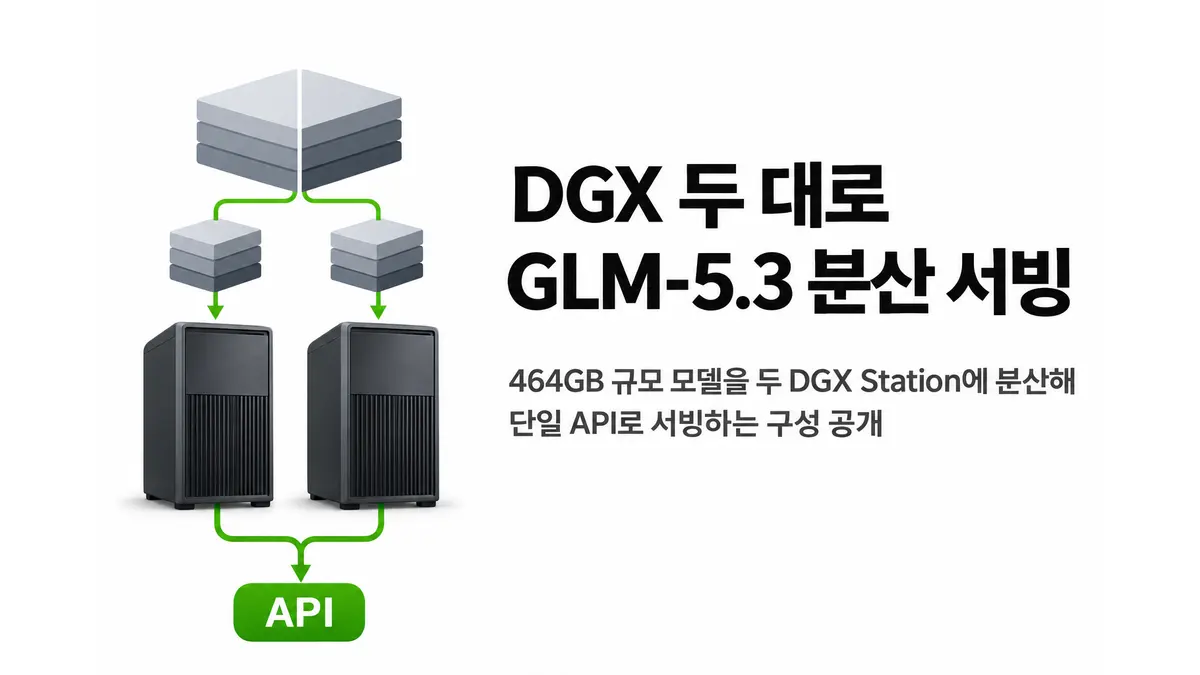
엔비디아가 단일 GPU 메모리에 담기지 않는 GLM-5.3을 두 대의 DGX Station에 나눠 로컬에서 서빙하는 구성을 공개했다. 두 장비의 GB300 GPU를 ConnectX-8 원격 직접 메모리 접근(RDMA)으로 연결하고, vLLM의 텐서 병렬화(TP=2)로 모델 가중치와 연산을 분산한다. 이용자는 두 장비가 아니라 하나의 OpenAI 호환 API 엔드포인트에 요청을 보낸다.1
이 구성이 필요한 이유는 모델의 크기다. 엔비디아 GLM-5.3 NVFP4는 Z.ai의 전문가 혼합(MoE) 모델을 양자화한 버전으로, 전체 매개변수는 7530억 개이며 토큰마다 400억 개를 활성화한다. 희소 활성화 덕분에 매번 수행하는 연산은 줄지만, 토큰마다 선택되는 전문가가 달라질 수 있어 모든 가중치를 GPU 메모리에 올려둬야 한다. 체크포인트 크기는 약 464GB로, GB300 GPU 한 개의 HBM3e 252GB보다 212GB 크다. 엔비디아의 예제는 CPU로 가중치를 내리는 오프로딩을 끄고 두 GPU 메모리에 모델을 나눠 적재한다.1
역할도 분리했다. Station A는 rank 0으로 API를 열고 응답을 반환하며, Station B는 rank 1 워커로만 동작한다. 그러나 추론 요청이 들어오면 두 Station이 모두 계산에 참여한다. 각 장비는 같은 vLLM 컨테이너와 체크포인트를 사용하며, 서빙에는 두 개의 직접 연결 레일 가운데 하나를 골라 해당 RDMA 장치와 IPv4 주소를 지정한다. 엔비디아는 사전에 양쪽 레일의 GPU 메모리 RDMA 연결을 검증하도록 요구한다.1
운영 준비 비용도 작지 않다. 두 장비 모두 Linux 기반 GB300 DGX Station이어야 하고, 같은 사용자 이름의 SSH·sudo 접근 권한과 외부 저장소 접근이 필요하다. 체크포인트 사본을 장비마다 보관하므로 각 Station에 최소 464GB의 빈 디스크가 필요하며, 컨테이너 이미지와 임시 파일 공간은 별도다. 모델 사용자는 엔비디아 오픈 모델 계약과 원본 GLM-5.3 라이선스에도 동의해야 한다.1
이번 공개는 여러 모델 복제본으로 요청을 나누는 구성이 아니라, 두 장비가 한 모델과 모든 요청을 함께 처리하는 방식이다. 엔비디아가 제시한 결과는 동시 부하에서의 동작을 재는 기준선까지이며, 제공된 자료에는 처리량이나 지연시간 수치가 없어 성능 향상 폭을 판단할 수는 없다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.