DuckLake 1.1, SQL로 메타데이터 관리
최근 30일 조회수 — 좋아요 —핵심 요약
DuckLake 1.1은 SQL 데이터베이스에 메타데이터를 모아 레이크하우스의 파일 탐색과 관리 부담을 줄인다.
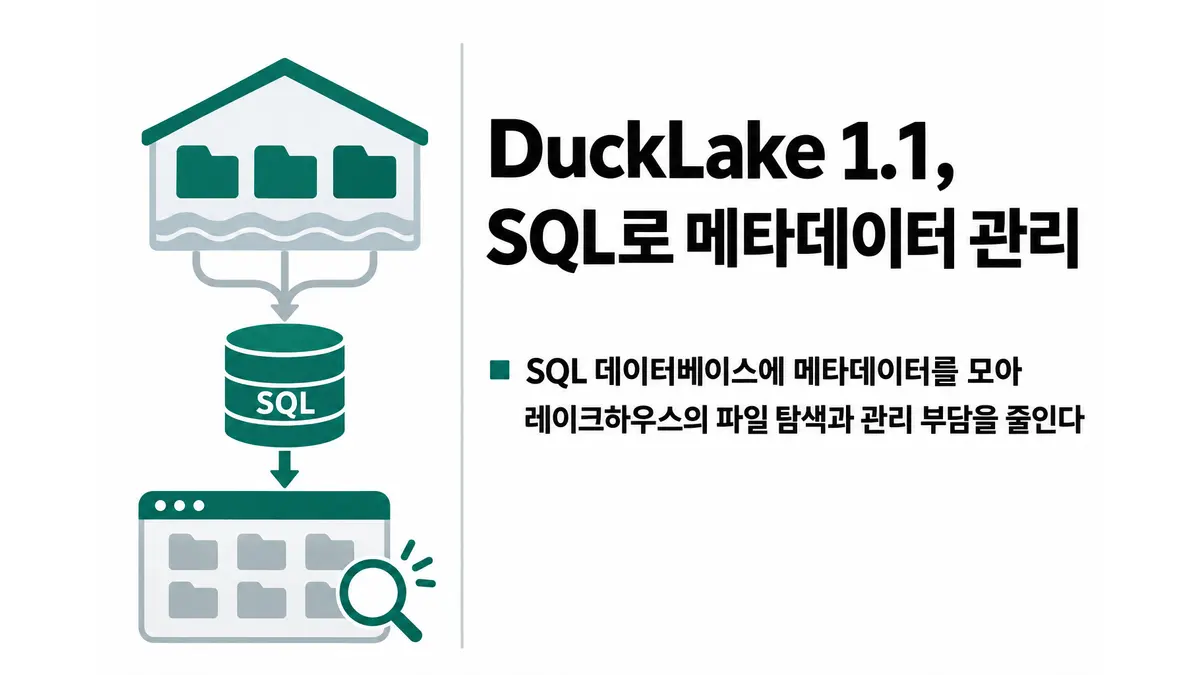
오픈소스 테이블 레이크하우스 형식인 DuckLake 1.1이 10월 DuckDB 2.0.0 LTS와 함께 공개됐다. 암스테르담의 DuckLabs가 만든 DuckLake는 객체 스토리지 곳곳에 매니페스트 파일을 두는 대신, 일반 SQL 데이터베이스에 테이블 메타데이터를 저장한다. 더뉴스택은 이를 데이터가 급증하는 환경에서 레이크하우스의 파일 관리 복잡성을 줄이는 접근법으로 소개했다.1
기존 테이블 형식에서는 어떤 Parquet 파일이 최신 테이블 버전을 구성하는지 확인하려고 여러 메타데이터 파일을 탐색해야 한다. 데이터 소스와 스냅샷이 늘수록 확인할 메타데이터와 읽어야 할 Parquet 파일도 많아져 질의가 느려진다. DuckLake는 이 문제를 관계형 데이터베이스의 카탈로그 관리 문제로 바꿨다. SQL로 카탈로그에 질의하면 읽어야 할 Parquet 파일 목록을 돌려주며, 데이터 파일 자체는 그대로 두고 카탈로그만 갱신한다.
Pedro Holanda DuckLake 수석 개발자는 레이크하우스 형식의 목적이 마이그레이션 없이 데이터베이스 시스템을 교체할 수 있게 하는 데 있다고 설명했다. 다만 교환 가능한 형식을 유지하려면 최신 테이블 버전을 추적할 데이터베이스 시스템이 필요하다는 것이다. DuckLake는 널리 쓰이는 SQL과 스키마를 활용해 별도의 복잡한 메타데이터 계층을 줄이는 쪽을 택했다.
파일 수를 줄이는 기능도 이 구조와 맞물린다. DuckLake는 여러 파일을 하나로 합칠 수 있고, 이 작업을 여러 스냅샷에 걸쳐 수행해 객체 스토리지 요청 횟수를 낮춘다. 스트리밍 환경에서 작은 파일이 대량으로 쌓이는 ‘스몰 파일 문제’에는 인라이닝(inlining)과 플러싱(flushing)을 사용한다. 인라이닝은 실제 데이터를 카탈로그의 테이블에 직접 담는 방식이다. Parquet과 DuckDB 저장 형식이 모두 열 지향이며 행 그룹으로 구성된다는 점도 데이터 변환 부담을 줄인다.
더뉴스택 자료는 DuckLake 1.1의 버전별 변경 사항이나 성능 측정치를 제시하지 않아, 이전 버전보다 얼마나 빨라졌는지는 확인하기 어렵다. 대신 SQL 데이터베이스를 메타데이터의 단일 관리 지점으로 삼아 서버 클러스터와 파일 탐색 부담을 줄인다는 설계 방향에 초점을 맞췄다. Amazon 최고경영자 앤디 재시도 10월 3분기 실적 발표에서 데이터 저장소와 분석 엔진 사이의 이동 복잡성을 언급하며, DuckLabs 인수를 통해 DuckDB를 AWS 스토리지·분석 서비스의 공통 SQL 문법으로 쓰겠다는 구상을 밝혔다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.