구글, TPU 맞춤형 AI 모델 설계 지침 공개
최근 30일 조회수 — 좋아요 —핵심 요약
구글이 TPU 구조에 맞춘 모델 차원 정렬과 아키텍처·병렬화 최적화 지침을 오픈소스로 공개했다.
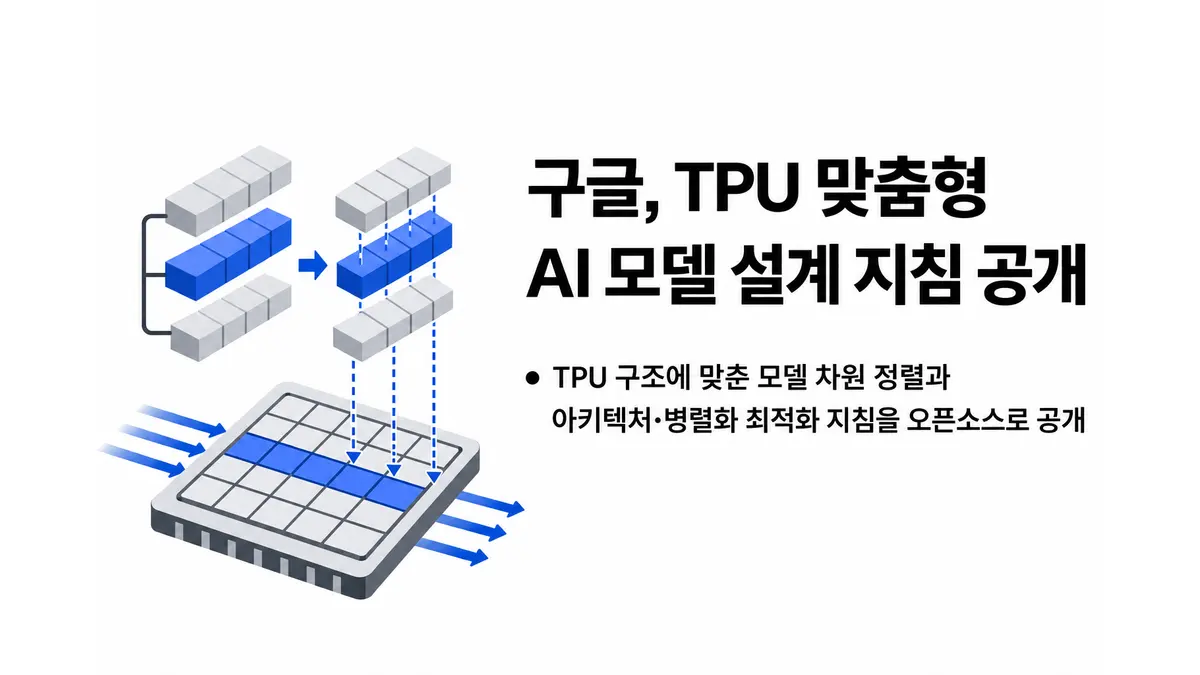
구글이 TPU의 하드웨어 특성에 맞춰 AI 모델을 설계하고 최적화하는 지침을 오픈소스로 공개했다. AI-Hypercomputer/tpu-codesign 가이드는 대규모 언어 모델(LLM), 전문가 혼합(MoE), 멀티모달·월드 모델처럼 대규모 행렬 연산에 의존하는 모델을 대상으로 형상 정렬, 아키텍처 선택, 병렬화 방법을 설명한다. 구글은 학습을 시작하기 전의 설계가 모델 FLOP 활용률(MFU), 비용, 서빙 지연시간의 상한을 사실상 결정한다고 밝혔다.1
핵심은 모델의 연산 구조를 TPU의 물리적 구성에 맞추는 것이다. TPU는 범용 하드웨어 스케줄링 대신 256×256 시스톨릭 배열, 소프트웨어가 관리하는 VMEM, 희소 연산 전용 SparseCore, 다차원 칩 간 연결망(ICI)을 사용한다. 이 구조는 총소유비용(TCO) 대비 높은 성능을 노리는 대신, 모델의 차원과 라우팅·병렬화 방식에 일정한 제약을 둔다.
가이드는 d_model, 피드포워드 네트워크와 전문가 중간 너비인 d_ff, 잠재 표현 너비, 어텐션 투영 차원, 패딩된 어휘 크기를 256의 배수로 맞추라고 권고한다. 반면 토큰·배치 축과 헤드·레이어·전문가 수는 이 규칙에서 제외된다. 특히 놓치기 쉬운 값은 head_dim이다. 일반적인 64 또는 128을 쓰면 플래시 어텐션의 QK 곱셈에서 행렬 연산 장치(MXU)의 절반 이상이 놀 수 있다는 설명이다.
구글은 전체 투영 너비와 논리적 KV 캐시 용량을 유지한 채 head_dim을 256으로 늘리고 Q·KV 헤드 수를 비례해 줄 것을 제안한다. 자체 실험에서는 Qwen3-30B 기반 MoE의 어텐션을 32×128에서 16×256으로 바꿨을 때 매개변수 수와 FLOP가 같았는데도 전체 학습이 빨라졌고, 문맥 길이가 길수록 이득이 커졌다. 다만 구체적인 향상률은 공개된 자료에 제시되지 않았다.
기존 모델을 옮기는 팀은 체크포인트를 수정하지 않고 병렬화 표현 지침만 적용할 수도 있다. 원칙은 8세대 TPU에도 이어지지만 임계값은 하드웨어에 따라 달라진다. 구글은 측정 결과의 경향과 순위는 참고할 수 있어도 정확한 비율은 구성별 결과로 봐야 한다고 선을 그었다. 측정은 주로 단일 슬라이스, BF16, 최대 32K 시퀀스 조건에서 조정된 시스템 기준선과 비교해 이뤄졌다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- TPU Model Design Considerations and Optimization Guide — Google Developers Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.