세레브라스, GPU·WSE 분리형 추론 출시
최근 30일 조회수 — 좋아요 —핵심 요약
GPU가 프리필을, WSE가 디코드를 맡아 생성 속도를 유지하며 전력당 처리량을 5배 높였다고 밝혔다.
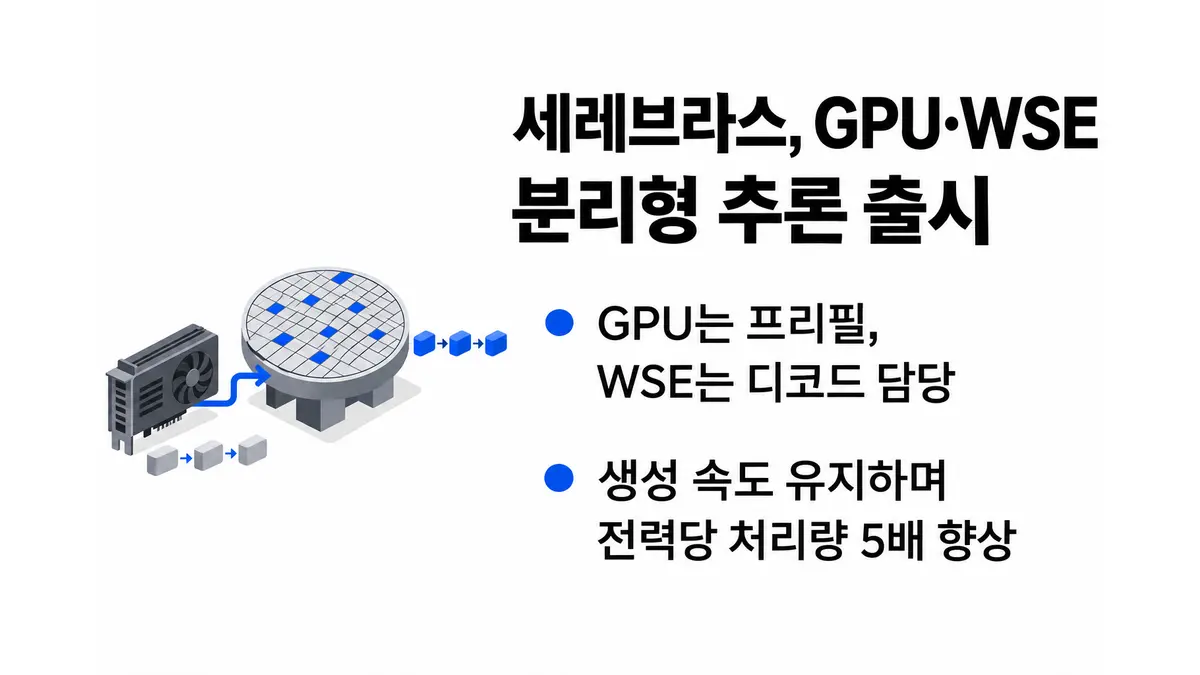
세레브라스(Cerebras)가 프롬프트 처리는 GPU에, 답변 생성은 웨이퍼 스케일 엔진(Wafer Scale Engine·WSE)에 맡기는 ‘분리형 추론’ 서비스를 출시했다. 세레브라스는 이 구성을 자사 추론 클라우드에 실제 배치했으며, 기존의 초고속 생성 속도를 유지하면서 메가와트당 처리 토큰을 5배로 늘렸다고 발표했다.1
대규모 언어 모델 추론은 크게 프리필(prefill)과 디코드(decode)로 나뉜다. 프리필은 입력 프롬프트를 처리해 모델의 중간 상태를 만들고, 디코드는 이 상태를 이용해 출력 토큰을 하나씩 생성한다. 세레브라스의 새 서비스에서는 AMD 인스팅트(AMD Instinct) GPU가 프리필을 처리하고, CS-3 시스템이 디코드를 담당한다. GPU로 프롬프트 처리를 옮긴 만큼 CS-3는 답변 생성에 처리 용량을 집중할 수 있다.
이런 분업의 핵심은 두 단계가 요구하는 연산 특성이 다르다는 데 있다. 디코드는 앞서 생성한 토큰을 다음 토큰 생성에 다시 쓰는 자기회귀 방식이어서, 매 단계마다 모델 데이터를 메모리에서 읽어야 한다. 따라서 연산 성능뿐 아니라 메모리 대역폭이 속도를 좌우한다. 세레브라스는 WSE가 단일 칩에 수십 GB의 SRAM과 초당 수십 PB의 메모리 대역폭을 제공한다고 설명했다. 회사가 제시한 비교에 따르면 일반적인 GB300 GPU보다 SRAM 용량은 350배, 메모리 대역폭은 5,400배 크다.1 더 많은 동시 요청과 모델 계층을 칩 내부에 둘 수 있어 디코드에 유리하다는 주장이다.
이번 출시는 전력 공급이 제한된 데이터센터에서 추론 용량을 늘리려는 시도이기도 하다. 세레브라스는 같은 전력 예산으로 더 많은 요청을 처리할 수 있어 클라우드 사업자의 수용량과 매출 잠재력을 높일 수 있다고 밝혔다. 자체 클라우드뿐 아니라 인프라 파트너의 데이터센터에도 이 구성을 제공할 계획이며, 최근 발표한 CS-4와 제조 확대, 계획 중인 700MW 규모 데이터센터 용량을 함께 활용해 2027년 이후 공급을 늘리겠다는 구상이다.
다만 공개된 수치는 세레브라스의 자체 생산 환경 측정과 회사 설명에 근거한다. 5배 효율이 어떤 모델과 입력·출력 길이, GPU 및 시스템 구성에서 나왔는지는 주어진 자료에 제시되지 않아 다른 추론 인프라와 직접 비교하기는 어렵다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Cerebras Launches Disaggregated Inference — Hacker News
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.