개방형 AI 과제 검증기 ‘간달프’ 공개
최근 30일 조회수 — 좋아요 —핵심 요약
루브릭과 산출물·환경 변화를 함께 판정해 정확도와 비용 효율을 높인 오픈소스 검증기가 제안됐다.
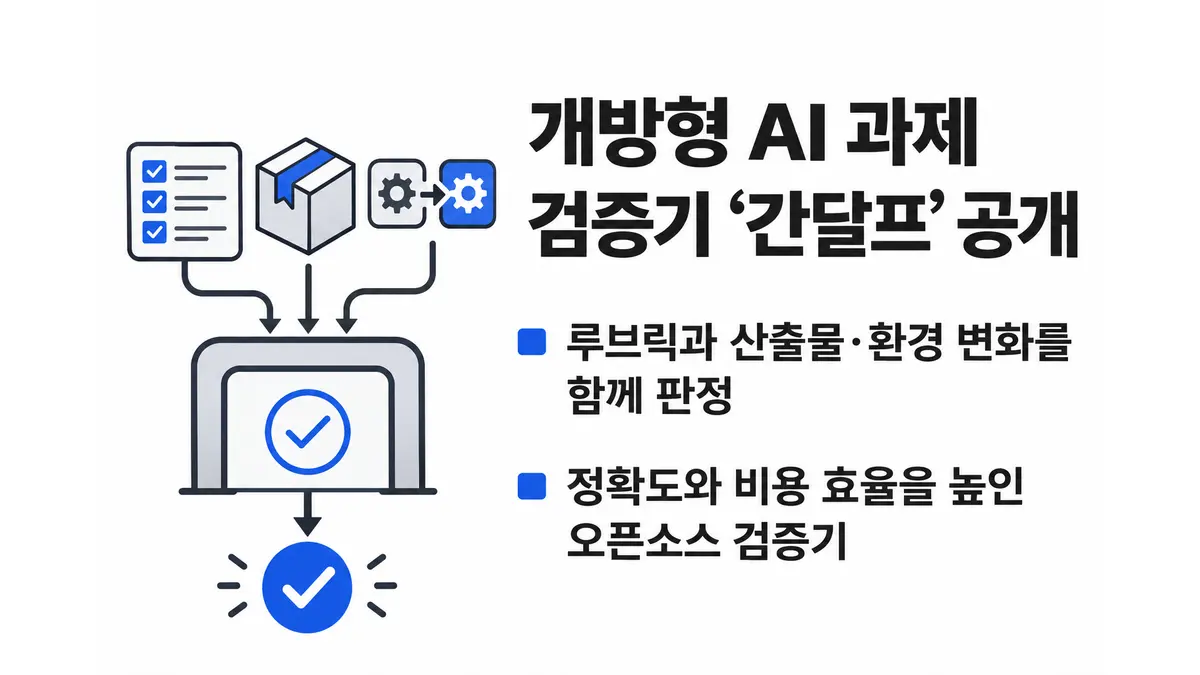
AI 에이전트가 개방형 과제를 수행한 뒤 내놓은 결과를 어떻게 검증할지 체계화한 연구가 나왔다. 11월 17일 arXiv에 공개된 논문은 루브릭의 자연어 평가 기준과 에이전트가 만든 산출물, 작업 환경의 변화를 함께 판정하는 검증 방법을 분석하고, 오픈소스 검증기 간달프(Gandalf)를 제안했다.1
개방형 과제는 정답 하나와 결과를 대조하기 어렵다. 문서 작성이나 투자은행 업무처럼 여러 조건을 동시에 만족해야 하는 과제에서는 검증기가 각 루브릭 기준을 해석해 충족 여부를 판단해야 한다. 연구진은 이런 ‘루브릭 채점 에이전트 환경’의 검증기를 처음으로 체계적으로 연구했다고 밝혔다.
연구진은 먼저 투자은행 업무 24개에서 사람이 판정한 루브릭 기준 2,464개를 모아 뱅커베리파이어벤치(BankerVerifierBench·BVB)를 구축했다. 이어 주어진 루브릭 모음에서 검증기에 필요한 능력을 도출하는 방법론을 만들고, 이를 아홉 가지 능력으로 분류했다. 구체적인 아홉 항목은 초록에 나오지 않지만, 설계 원칙은 ‘반응형 검증’, ‘환경 정렬’, ‘도메인 지침’ 세 가지로 압축된다.
BVB에서 간달프는 비교 대상 검증기 세 개보다 같거나 높은 F1 점수를 더 낮은 비용으로 기록했다. 논문에 따르면 Gemini 3 Flash를 쓴 간달프의 F1은 0.864로 가장 강한 기존 검증기의 0.852를 웃돌았고, 비용은 5분의 1이었다. GPT-5.4 계열 모델을 적용했을 때는 비용을 낮추면서 F1을 0.12 넘게 높였다. 구조가 다른 개인 생산성 환경 오픈클로(OpenClaw)에서도 F1 0.955를 기록해 기존 최고치 0.934를 앞섰다.
다만 이 수치는 연구진이 만든 데이터셋과 실험 설정에서 얻은 결과다. 논문은 아직 arXiv에 제출된 사전 공개본이며, 투자은행과 개인 생산성 이외의 환경에서도 같은 성능과 비용 우위가 이어지는지는 제시된 자료만으로 판단하기 어렵다. 연구진은 외부 검증이 가능하도록 BVB와 간달프, 실험 재현용 코드와 데이터를 공개했다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Verifying Agents in Rubric-Graded Environments — arXiv (cs.AI/cs.CL/cs.LG)
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.