슬럼 26.11, QPU 직접 스케줄링 지원
최근 30일 조회수 — 좋아요 —핵심 요약
HRES 플러그인이 클러스터 공용 QPU의 예약·추적·과금을 슬럼 스케줄러에 통합한다.
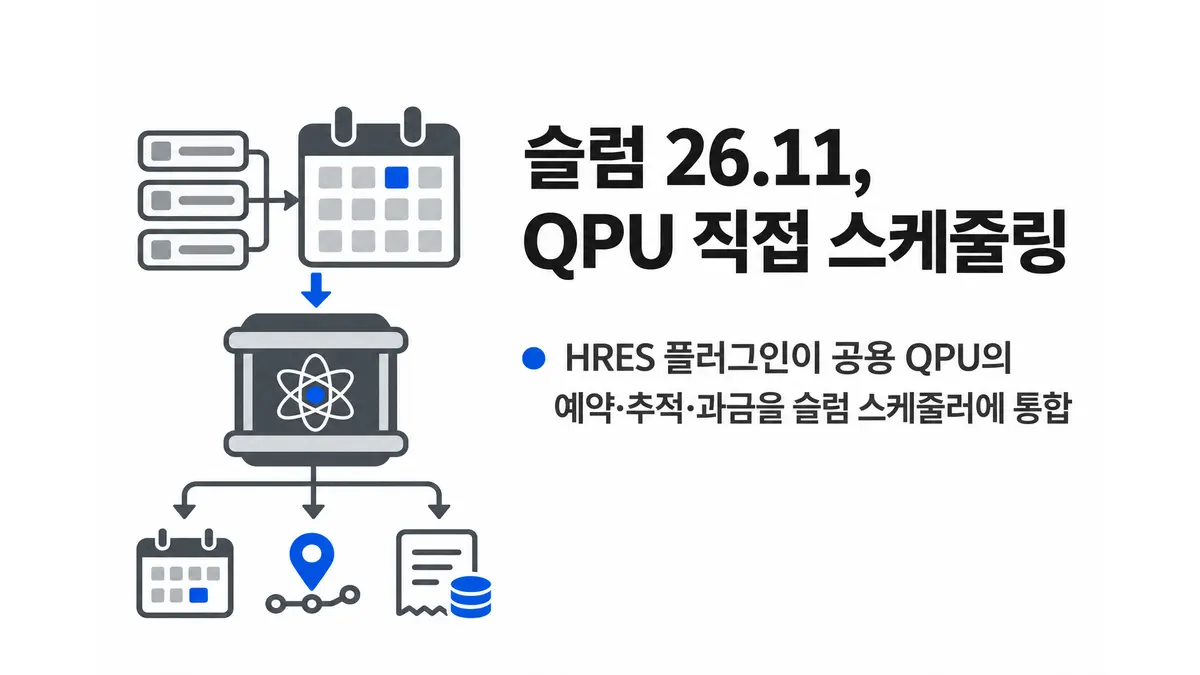
슬럼(Slurm) 26.11이 계층형 자원(Hierarchical Resources·HRES) 플러그인을 도입해 양자처리장치(QPU)를 클러스터 차원의 자원으로 직접 스케줄링한다. NVIDIA 기술 블로그에 따르면, 운영자는 짧고 이식 가능한 루아(Lua) 플러그인으로 QPU를 등록할 수 있다. 사용자는 CPU나 GPU를 요청하듯 작업 제출 단계에서 QPU를 예약하고 실행할 수 있으며, 운영자는 사용량 추적과 모니터링, 회계 처리, 센터별 정책 적용을 같은 스케줄러에서 처리할 수 있다.1
기존 슬럼의 자원 모델은 QPU의 배치 방식과 맞지 않았다. GPU 관리에 쓰이는 일반 자원(Generic Resources·GRES)은 개별 컴퓨트 노드에 귀속된다. 반면 QPU는 대개 특정 노드의 부품이 아니라 네트워크를 통해 여러 노드가 접근하는 클러스터 공용 가속기다. QPU를 GRES로 설정하면 한 노드에 묶이고, 그 노드에 장애가 생겼을 때 관리자가 클러스터 설정을 바꾸기 전까지 QPU에도 접근할 수 없다.
일부 센터는 이 문제를 우회하려고 클러스터 공용 자원을 나타내는 라이선스 기능과 SPANK 플러그인을 함께 사용해 왔다. 라이선스로 QPU 사용 순서를 조정하고 SPANK로 사용자 인터페이스와 노드 환경을 구성하는 방식이다. 그러나 SPANK는 슬럼이 노드를 할당한 뒤에야 동작하므로, 라이선스와 제대로 연계하지 않으면 작업이 QPU를 기다리는 동안 컴퓨트 노드를 놀릴 수 있다. 장치 옵션과 라이선스를 각각 지정하는 ‘두 플래그’ 구조에서는 라이선스를 확보하지 않은 작업이 장치 옵션만 전달하는 것도 막기 어렵다. 한 클러스터에 QPU가 여러 대일 때 관리가 복잡해지는 문제도 있다.1
HRES의 의미는 QPU 접속 코드를 하나 더 제공했다는 데 그치지 않는다. 그동안 센터와 QPU 제조사마다 통합 코드를 다시 만들면서 사용자는 시설마다 다른 인터페이스를 익혀야 했고, 관리자는 업그레이드를 방해하는 맞춤 코드를 유지해야 했다. 제조사와 시스템 통합업체도 배포 구성을 재사용하기 어려웠다. HRES는 이 연결 지점을 슬럼 플러그인 API로 모은다. QPU 제어 방식을 표준화하려는 오픈소스 인터페이스 QRMI와 QDMI도 이 API를 바탕으로 플러그인을 공개했다는 것이 NVIDIA의 설명이다.1
다만 QPU를 GPU처럼 다룬다는 표현은 물리적 구조가 같다는 뜻이 아니다. HRES의 핵심은 노드에 붙은 장치라는 기존 가정을 버리고, QPU의 클러스터 공용 특성을 스케줄러가 직접 이해하도록 만든 데 있다. 초기 채택 사례가 언급됐지만, 실제 운영 범위와 성능 효과를 판단할 구체적인 도입 수치까지 제시되지는 않았다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Integrating QPUs into Supercomputing Centers Using Slurm HRES Plugins | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.