AWS, 세이지메이커 리전 간 추론 라우팅 출시
최근 30일 조회수 — 좋아요 —핵심 요약
GPU 용량 부족 시 추론 요청을 다른 리전·계정의 엔드포인트로 자동 우회하고 복구 후 점진적으로 복귀시킨다.
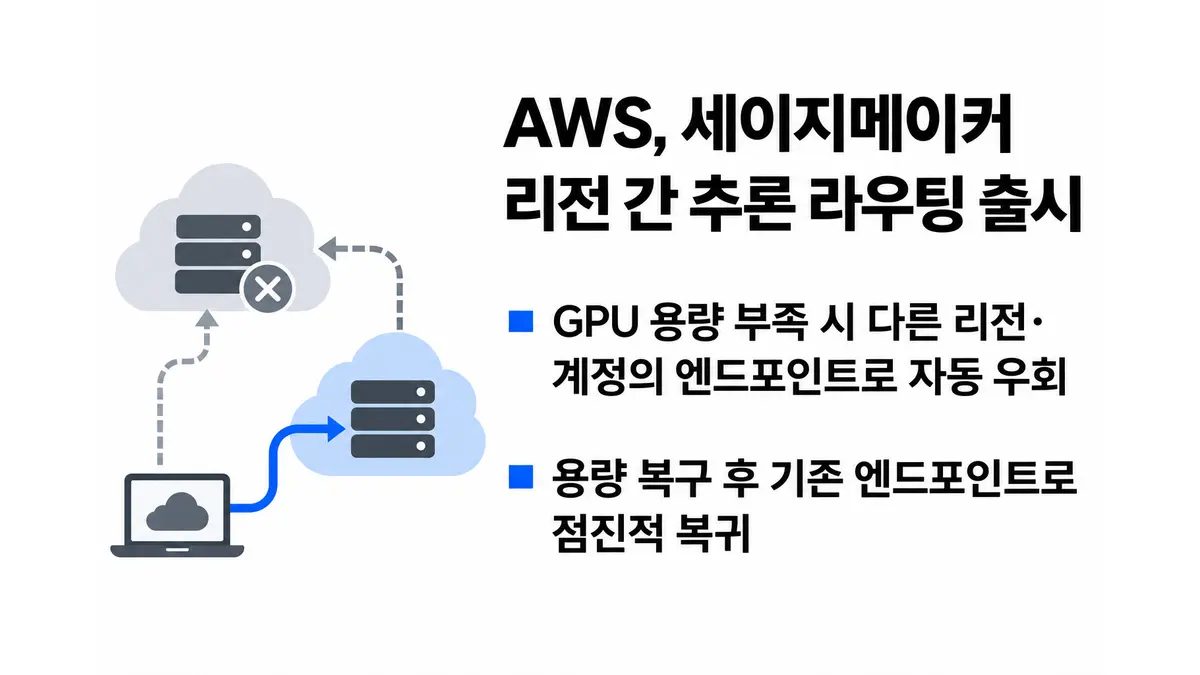
AWS가 아마존 세이지메이커 AI(Amazon SageMaker AI)의 추론 요청을 여러 리전과 계정에 걸쳐 자동 우회하는 ‘리전 간 추론 라우팅’을 출시했다. 한 리전에서 GPU 용량이 부족해 엔드포인트가 요청을 안정적으로 처리하지 못하면, 같은 모델을 서비스하는 다른 리전의 엔드포인트로 새 요청을 보낸다. 그동안 개발팀이 직접 구현해야 했던 장애 감지와 전환, 복구 뒤 트래픽 복귀를 AWS 관리 기능으로 옮긴 것이다.1
핵심은 새 리소스인 ‘추론 라우터’다. 애플리케이션은 특정 엔드포인트 대신 라우터의 단일 호출 경로를 이용한다. 운영자는 모델별 ‘라우팅 대상’을 만들고 실제 요청을 처리할 목적지를 등록한다. 목적지에는 실시간 엔드포인트와 추론 컴포넌트, 비동기 엔드포인트를 지정할 수 있으며, 전체 아마존 리소스 이름(ARN)을 사용하므로 다른 리전이나 AWS 계정의 자원도 묶을 수 있다.
라우터는 자신이 생성된 리전을 로컬 리전으로 삼는다. 로컬 목적지가 정상일 때는 요청을 그곳에 유지하고, 안정적으로 처리하기 어렵다고 판단하면 다른 등록 목적지로 새 요청을 넘긴다. 로컬 목적지가 복구되면 트래픽을 한꺼번에 되돌리지 않고 점진적으로 복귀시켜 잦은 전환을 막는다. 모델마다 라우팅 대상이 독립적으로 장애 조치를 수행하므로 하나의 라우터에 여러 모델을 등록할 수도 있다.
기존 배포 방식은 바뀌지 않는다. 모델과 인스턴스 풀, 오토스케일링 설정을 그대로 둔 채 라우터만 호출 경로 앞에 추가하며, 기존 InvokeEndpoint 직접 호출도 계속 작동한다. InferenceId와 CustomAttributes 역시 목적지로 전달된다. 실시간 응답에는 실제 요청을 처리한 목적지와 그곳으로 라우팅한 이유가 포함돼 운영자가 결정을 추적할 수 있다.
다만 이 기능이 GPU 용량 자체를 새로 만드는 것은 아니다. 대체 목적지와 여유 용량은 사용자가 미리 배포하고 등록해야 한다. 즉, 이번 출시는 멀티리전 추론 인프라를 대신 구축하는 기능이라기보다, 용량 부족 때 요청을 어디로 보낼지 판단하고 전환하는 운영 로직을 관리형으로 제공하는 데 의미가 있다.
Footnotes
-
AWS Machine Learning Blog, “Keep inference running through regional capacity shortfalls with cross-Region inference routing in Amazon SageMaker AI” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Keep inference running through regional capacity shortfalls with cross-Region inference routing in Amazon SageMaker AI | Amazon Web Services — AWS Machine Learning Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.