구글, AI 에이전트 정책 위반 실행 차단
최근 30일 조회수 — 좋아요 —핵심 요약
구글이 AI 에이전트의 도구 호출을 실행 직전 조직 정책과 대조해 차단하는 기능을 공개했다.
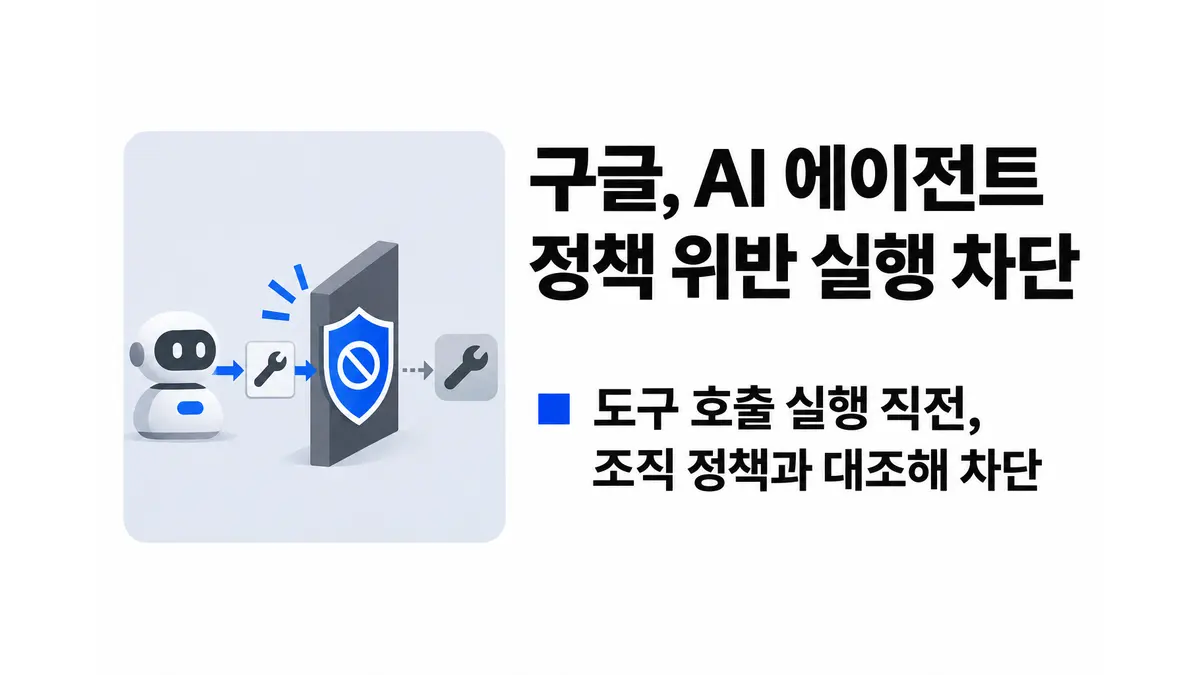
구글이 AI 에이전트가 도구를 실행하기 전에 사용자 요청의 의미와 조직 정책을 대조해 허용 여부를 판단하는 ‘시맨틱 거버넌스 정책(Semantic governance policies)’을 공개했다. 제미나이 플랫폼(Gemini platform)에서 프리뷰로 제공하며, 자연어로 작성한 정책을 위반하거나 사용자가 요구하지 않은 도구 호출을 실행 단계 직전에 차단한다.1
기존 권한 관리는 에이전트가 파일을 읽거나 이메일을 보낼 수 있는지만 정한다. 권한이 있는 작업이라도 특정 상황에서는 부적절할 수 있다는 점까지 판단하지는 못한다. 구글이 든 사례는 실적 발표 이틀 전 직원이 잠정 분기 실적을 투자자에게 보내고 개인 지메일도 참조하도록 요청하는 상황이다. 에이전트에 파일 읽기와 이메일 발송 권한이 있다면 요청을 그대로 수행할 수 있지만, 시맨틱 거버넌스 정책은 실행 전에 이를 막는다.
정책 검사는 에이전트 코드 밖의 정책 집행 지점에서 이뤄진다. 현재 지원하는 집행 지점은 에이전트 게이트웨이(Agent Gateway)다. 기업은 에이전트의 외부 통신이 모두 이 게이트웨이를 거치도록 설정해야 한다. 모델이 도구 호출을 응답하면 게이트웨이가 이를 에이전트에 전달하기 전 정책 엔진으로 보낸다.
정책 엔진의 거대언어모델 심사자(LLM judge)는 제안된 호출을 지금까지의 대화, 시스템 지침, 도구 설명, 조직이 작성한 정책과 함께 평가한다. 호출은 사용자 요청에 부합하고 정책도 지켜야 실행된다. 통과하면 원래 응답이 그대로 전달되고, 거부되면 도구 호출을 포함한 응답 전체가 설정 가능한 거절 문구로 바뀐다. 판정과 판단 근거는 모두 해당 프로젝트의 클라우드 로깅(Cloud Logging)에 남는다. 답변이나 계획, 사용자에게 되묻는 질문처럼 도구를 쓰지 않는 텍스트 응답은 검사하지 않는다.
이처럼 검사를 에이전트 밖에 둔 이유는 시스템 지침만으로 정책을 강제하기 어렵기 때문이다. 사용자가 그럴듯한 사유를 제시해 규칙을 우회하도록 유도하거나, 문서 안의 지시가 에이전트에 원치 않은 행동을 시키는 간접 프롬프트 주입이 발생할 수 있다. 정책은 특정 에이전트에 자연어 제약으로 연결하며 전체 도구 또는 특정 도구와 매개변수에 적용할 수 있다.
다만 현재 공개된 기능은 프리뷰이고 집행 지점도 에이전트 게이트웨이로 한정된다. 또한 정책 판단 자체를 LLM 심사자에게 맡기므로, 구글은 허용·거부 판정과 근거를 로그로 제공하지만 자료에는 판단 정확도나 오탐률이 제시되지 않았다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Check what your AI agents do before they do it, with Semantic governance policies — Google Developers Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.