엔비디아, Dynamo로 RL 롤아웃 병목 완화
최근 30일 조회수 — 좋아요 —핵심 요약
Dynamo가 KV 캐시 기반 라우팅과 가중치 배포, 워커 복구를 맡아 강화학습의 추론 지연을 줄인다.
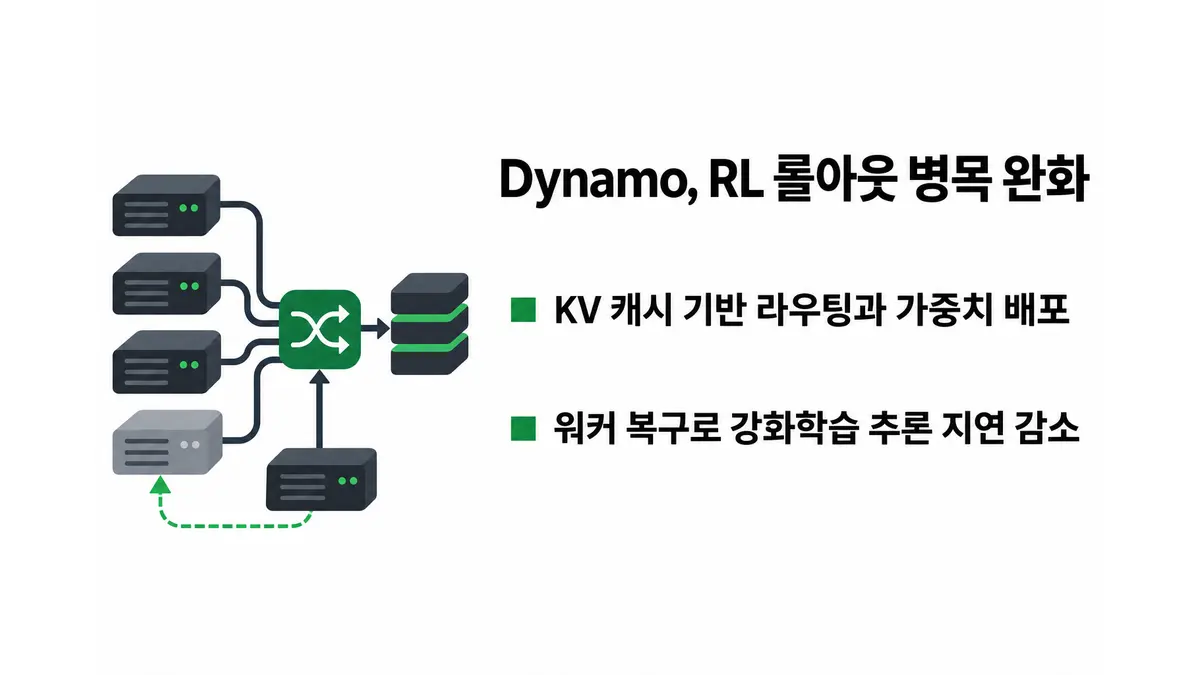
엔비디아(NVIDIA)가 강화학습(RL)에서 추론 롤아웃이 훈련 속도를 떨어뜨리는 문제를 줄이기 위해 Dynamo를 적용하는 구조를 공개했다. Dynamo를 강화학습 프레임워크와 추론 워커 사이의 서빙 계층으로 두고, KV 캐시를 고려한 요청 라우팅과 ModelExpress 기반 가중치 배포, 워커 복구를 맡기는 방식이다.1
강화학습에서 추론 워커는 모델 출력과 행동, 환경 상호작용으로 이뤄진 롤아웃을 만든다. 프레임워크는 결과에 보상을 매겨 모델 가중치를 갱신한 뒤 이를 워커에 다시 전달한다. 규모가 커지면 중복 연산, 느린 롤아웃, 잦은 가중치 갱신과 워커 장애가 GPU를 놀리거나 다음 훈련 단계를 늦춘다.
특히 롤아웃별 작업량 차이가 크다. 추론 문제는 응답 하나로 끝날 수 있지만 코딩 에이전트는 저장소 탐색과 편집, 도구 호출, 테스트까지 거친다. 여러 샘플 가운데 가장 느린 결과를 기다려야 하는 훈련에서는 GPU마다 요청 수를 똑같이 나누는 것만으로 부하가 고르게 분산되지 않는다.
Dynamo는 이 지점에서 요청의 공통 프롬프트가 저장된 KV 캐시와 워커 부하를 함께 살핀다. 같은 과제의 여러 해답을 캐시가 있는 워커로 보내면 프롬프트 계산을 되풀이하지 않아도 된다. 그러나 캐시 재사용만 좇아 한 워커에 요청을 몰면 대기열이 길어진다. Dynamo의 라우터는 두 조건 사이에서 균형을 잡아 훈련에 필요한 샘플을 더 일찍 완성하도록 설계됐다.
역할도 분리했다. 강화학습 프레임워크는 최적화와 보상, 환경, 체크포인트, 샘플 채택을 계속 관리한다. Dynamo는 라우팅과 워커 관리, 서빙 제어, 원격 측정을 맡고, 추론 엔진은 생성과 새 가중치 적용을 담당한다. ModelExpress는 지원되는 연동 환경에서 가중치와 산출물을 배포하며, 워커에 이미 있는 가중치를 재사용해 매번 전체 체크포인트를 보내는 부담을 줄인다.
다만 엔비디아가 공개한 설명은 Dynamo가 학습 알고리즘이나 샘플 판정을 대신한다는 뜻이 아니다. 어떤 워커가 언제 생성할 수 있는지, 어느 결과를 훈련에 쓸지는 프레임워크가 정한다. 따라서 실제 효과는 롤아웃 지연, 반복 문맥, 가중치 신선도 가운데 무엇이 주된 병목인지에 따라 달라진다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Reducing Rollout Bottlenecks in Reinforcement Learning with NVIDIA Dynamo | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.