엔비디아, 관계형 데이터 예측 모델 공개
최근 30일 조회수 — 좋아요 —핵심 요약
쿠모 릴레이셔널은 기업 데이터베이스 구조를 유지하며 추가 학습 없이 이탈·수요·사기 가능성을 예측한다.
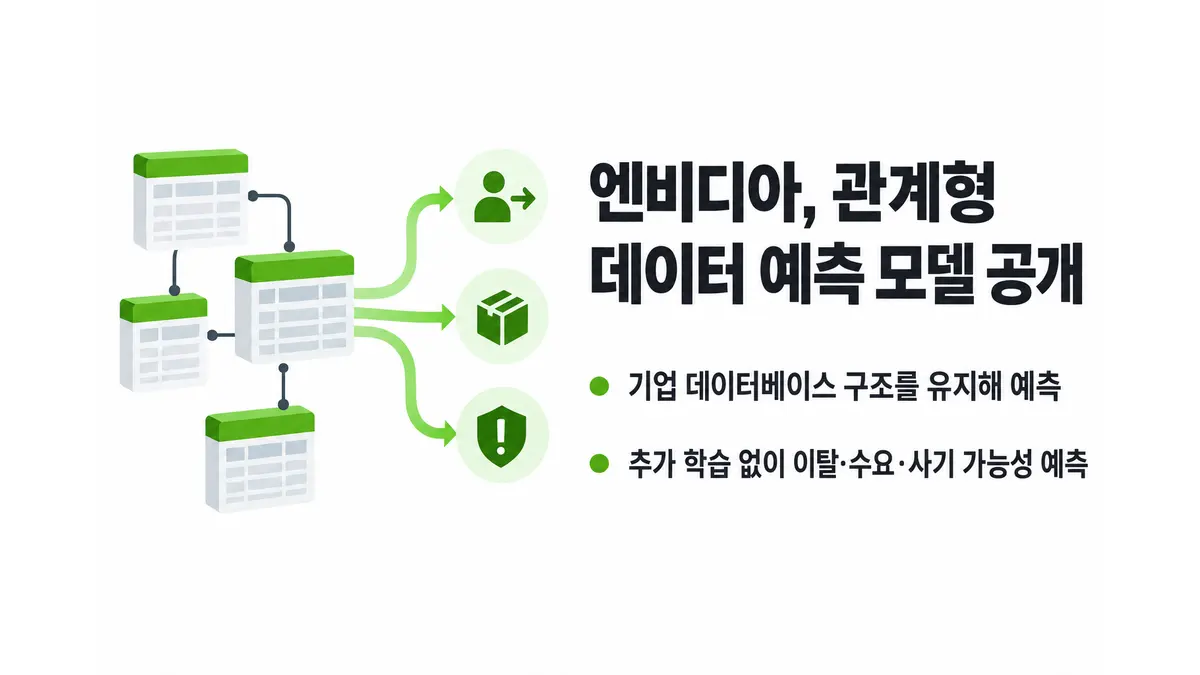
엔비디아(NVIDIA)가 기업의 관계형 데이터베이스를 그대로 읽어 이탈·수요·사기 가능성을 예측하는 사전학습 모델 ‘쿠모 릴레이셔널(Kumo Relational)’을 공개했다. 엔비디아가 허깅페이스 블로그에서 밝힌 핵심은 업무별 추가 학습이 필요 없다는 점이다. 사용자가 예측 질의를 입력하면 쿠모 릴레이셔널은 과거 사례를 최대 1만 건까지 문맥으로 모은 뒤, 한 번의 순전파로 결과를 낸다.1
기존 기업용 머신러닝은 여러 테이블을 하나로 펼치고 사람이 변수를 설계하는 과정이 필요했다. 예컨대 사용자·주문·상품 테이블에서 ‘최근 30일 평균 주문액’ 같은 값을 직접 만들어야 한다. 이 과정은 세부적인 관계 구조를 잃을 수 있고, 새로운 예측 과제마다 별도 파이프라인과 학습 작업도 요구한다. 쿠모 릴레이셔널은 테이블과 외래 키, 시간 정보를 유지한 채 데이터베이스에서 직접 작동한다. 실제 기업 데이터를 모아 학습한 것이 아니라, 현실의 데이터 구조를 본뜬 합성 관계형 데이터로 사전학습했다.
엔비디아가 공개한 성능 수치는 기존 지도학습 방식보다 높다. 15개 데이터베이스의 41개 과제에서 관계형 딥러닝 모델과 전문가가 변수를 설계한 그래디언트 부스팅 트리 파이프라인을 앞섰다. RelBench V1 분류 과제에서는 그래디언트 부스팅 트리보다 평균 AUROC가 약 4포인트 높았다. SAP SALT 기업 벤치마크에서는 별도 학습 없이 AutoGluon 앙상블보다 평균 역순위(Mean Reciprocal Rank·MRR)가 8% 높았고, 변수 설계를 거친 XGBoost와 비교하면 7 MRR 포인트 앞섰다. 미세조정 뒤에는 XGBoost와의 격차가 13포인트로 커졌다.1
쿠모 릴레이셔널은 예측 질의 언어(Predictive Query Language·PQL)를 제공해 사람뿐 아니라 AI 에이전트도 호출할 수 있다. 엔비디아는 GPU 기반 오픈소스 structured-data-models 라이브러리와 엔비디아 NIM 형태로 모델을 제공하며, 5천억 행이 넘는 데이터베이스까지 확장할 수 있다고 설명했다.
다만 ‘최초로 기존 지도학습을 능가한 퓨샷 관계형 기반 모델’이라는 규정과 성능·확장성 수치는 모두 엔비디아가 작성한 공개 자료에 근거한다. 제시된 자료에는 독립 기관의 재현 결과나 실제 운영 환경에서의 비용·지연시간 비교가 없다. 또 ‘학습 불필요’는 과제별 학습 없이 바로 쓸 수 있다는 뜻이며, 엔비디아가 함께 제시한 미세조정 성능은 별도의 선택적 학습을 거친 결과다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- NVIDIA Kumo Relational Outperforms Supervised Machine Learning on Relational Data, No Training Required — Hugging Face Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.