엔비디아, 엣지 AI용 경량 추론 런타임 공개
최근 30일 조회수 — 좋아요 —핵심 요약
TensorRT Edge-LLM은 DGX Spark에서 개발한 AI 모델을 로봇·차량·설비용 엣지 장치에 배포하도록 돕는다.
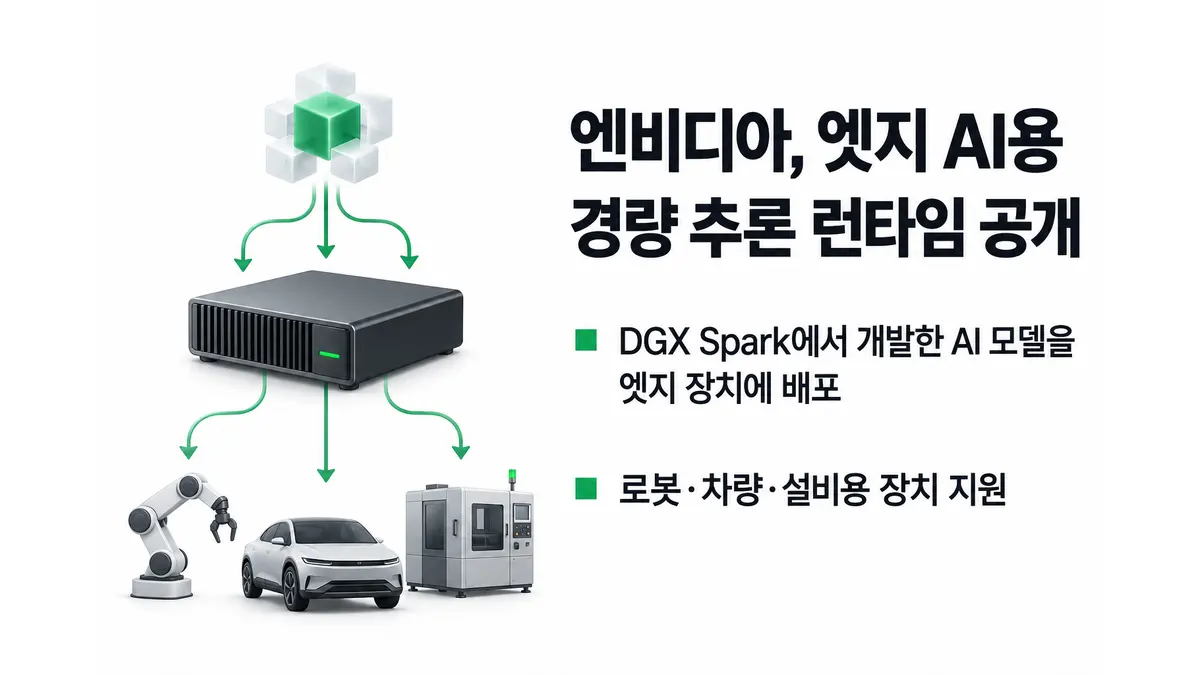
엔비디아가 임베디드 AI를 위한 경량 C++ 추론 런타임 ‘TensorRT Edge-LLM’을 공개했다. 데이터센터 밖에서 작동하는 로봇, 차량, 생산 설비용 AI가 제한된 메모리와 전력 안에서 빠르게 인식·추론·행동하도록 돕는 도구다. 엔비디아는 DGX Spark에서 모델을 개발한 뒤 젯슨 토르(Jetson Thor), 드라이브 AGX 토르(DRIVE AGX Thor), IGX 토르(IGX Thor)에 같은 추론 체계로 배포할 수 있다고 설명했다.1
TensorRT Edge-LLM의 핵심은 모델 준비 과정을 trtedge 명령줄 인터페이스(CLI)로 묶은 점이다. 개발자가 모델을 선택하면 CLI가 이를 내려받고 DGX Spark에 맞춘 TensorRT 엔진을 구축한다. 완성된 모델은 터미널에서 대화형으로 시험하거나, 로컬의 OpenAI 호환 API 서버로 띄워 애플리케이션 개발에 연결할 수 있다. 생성 속도를 높이는 DSpark 추측 디코딩도 지원한다.
엔비디아가 제시한 예시는 텍스트 전용 모델인 ‘NVIDIA Nemotron-3.5 Lightning’ 실행이다. 다음 한 줄로 모델 다운로드와 엔진 구축, 채팅 실행을 시작한다.
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4첫 실행 때 받는 모델은 약 21GB이며, 모델과 엔진은 기본적으로 ~/.cache/tensorrt-edgellm에 저장된다. 이후에는 설정이 일치하는 캐시 엔진을 다시 사용한다. 모델명과 --host 127.0.0.1, --port 8000 인수를 지정해 trtedge serve를 실행하면 127.0.0.1:8000에서 서버를 열고 /v1/chat/completions 엔드포인트로 요청을 보낼 수 있다.
다만 설치 조건은 가볍지 않다. 엔비디아의 실습 환경에는 DGX Spark와 지원 소프트웨어 스택, CUDA 13, TensorRT 10.16.1.11 이상이면서 11 미만인 버전, Python 3.10~3.12가 필요하다. 예시는 TensorRT Edge-LLM 0.11.1과 TensorRT 10.16.1.11에서 검증됐다. 런타임 자체는 경량화를 내세우지만, 공개된 절차는 특정 엔비디아 하드웨어·소프트웨어 환경을 전제로 한다.1
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Run AI Models for Edge Application Development with Just a Few Commands | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.