엔비디아, DGX Spark 8노드 지원
최근 30일 조회수 — 좋아요 —핵심 요약
DGX Spark 8대를 연결해 1TB 메모리에서 753B급 AI 모델을 로컬로 실행한다.
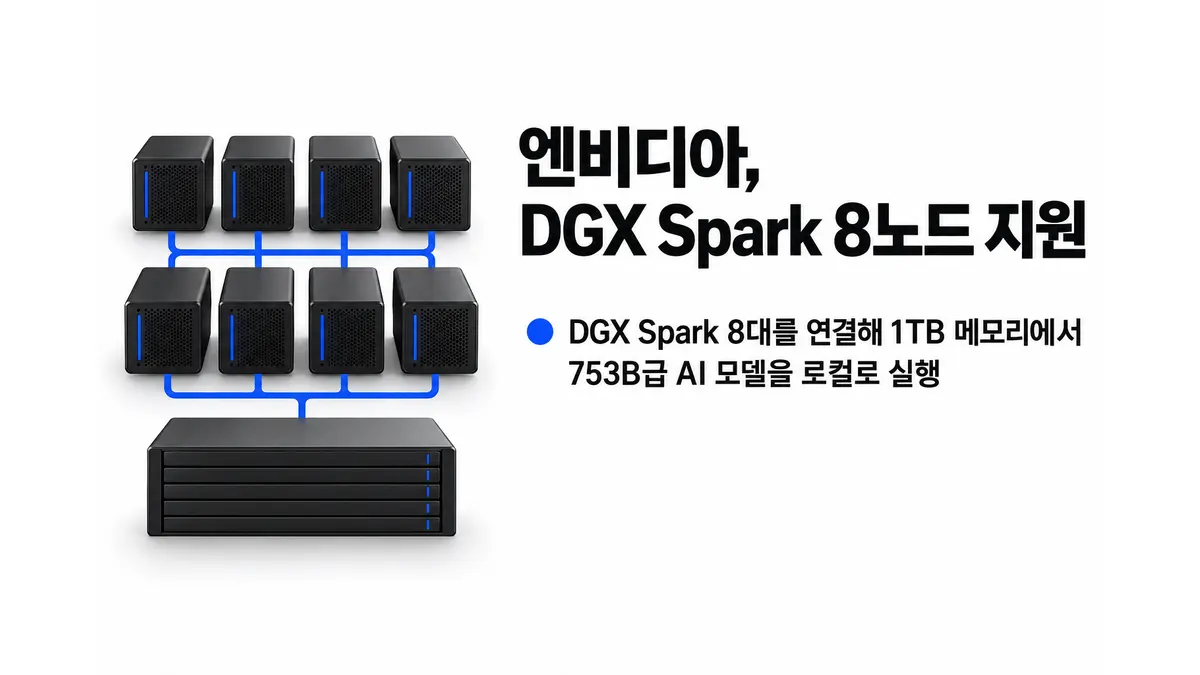
엔비디아(NVIDIA)가 데스크톱 AI 시스템 DGX Spark 8대를 하나의 클러스터로 묶는 구성을 공개했다. 노드당 128GB인 통합 메모리를 총 1TB로 늘려, 기존 4노드 구성에서는 적재할 수 없었던 Z.ai의 GLM 5.3 753B 같은 대형 모델을 로컬에서 실행하는 방식이다. 엔비디아는 GTC 베를린에서 8노드 클러스터 공식 지원을 발표했으며, 설정과 장치 관리를 맡는 NVIDIA Sync의 지원은 2026년 말까지 추가할 예정이다.1
확장의 핵심은 연산 장치 수보다 메모리 용량이다. DGX Spark 한 대는 통합 메모리 128GB를 제공하고, 4대를 연결하면 512GB, 8대에서는 1TB가 된다. 엔비디아는 8노드 환경에 GLM 5.3 753B 전체 체크포인트를 올렸으며, 혼합 전문가(Mixture-of-Experts·MoE) 모델인 GLM 5.3 Flash에서는 초당 약 80토큰의 생성 속도를 측정했다고 밝혔다. 다만 전체 GLM 5.3의 세부 측정에서는 동시 사용자 1명일 때 디코드 속도가 초당 31토큰이었고, 4명에서 총 51토큰, 8명에서 총 67토큰으로 늘었다. 사용자당 속도는 각각 31·21·18토큰으로 낮아졌다.
| 동시 사용자 | 프리필 총 TPS | 사용자당 프리필 TPS | 디코드 총 TPS | 사용자당 디코드 TPS |
|---|---|---|---|---|
| 1 | 1,600 | 1,600 | 31 | 31 |
| 4 | 1,600 | 750 | 51 | 21 |
| 8 | 1,600 | 473 | 67 | 18 |
노드 간 통신 병목을 줄이기 위해 엔비디아는 Spark에 맞춘 집합통신 백엔드 RoCEnante도 시험했다. 각 노드가 모든 상대에게 데이터를 직접 보내고 로컬에서 합산해, 이웃 노드를 차례로 거치는 링 올리듀스보다 통신 단계를 줄이는 방식이다. 엔비디아 측정에서는 4노드 NVFP4 환경에서 프리필 처리량이 약 5%, 디코드가 21% 높았고, 비양자화 모델을 쓴 8노드에서는 디코드가 약 18% 개선됐다. RoCEnante는 FlashInfer에 병합됐으며 시작 검사에 실패하면 NCCL(NVIDIA Collective Communications Library)로 자동 전환된다.
이 방식에는 분명한 경계가 있다. 모든 노드가 직접 연결된 스위치 토폴로지에서만 쓸 수 있고, 노드와 메시지 또는 동시 요청이 늘수록 데이터 이동량이 커진다. 따라서 대규모 클러스터나 높은 동시성, 링 토폴로지에서는 기본 통신 라이브러리인 NCCL이 더 적합하다는 것이 엔비디아의 설명이다. 이번 공개는 단일 워크스테이션의 성능 기록이라기보다, 1TB 메모리를 활용해 대형 모델과 멀티에이전트 작업을 로컬에서 실험할 수 있는 범위를 넓혔다는 데 의미가 있다.
Footnotes
-
NVIDIA Technical Blog, “Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Running Frontier-Class AI Models Across 8 NVIDIA DGX Spark Nodes | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.