엔비디아, AI 작업 자동 복구 확대
최근 30일 조회수 — 좋아요 —핵심 요약
미션 컨트롤 2.5가 쿠버네티스·런:에이아이 환경에서 장애 탐지와 격리, AI 작업 재배치를 자동화한다.
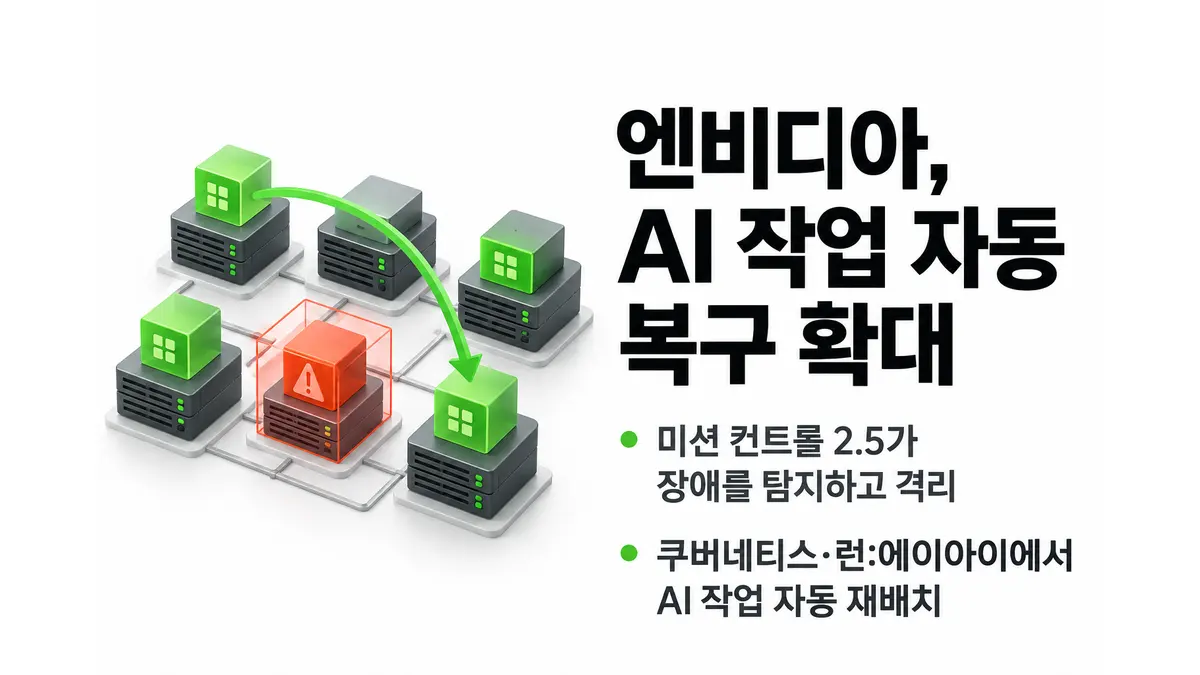
엔비디아가 대규모 GPU 클러스터의 장애를 탐지·진단하고 작업을 자동 복구하는 미션 컨트롤(Mission Control) 2.5를 공개했다. 기존에는 슬럼(Slurm) 기반 고성능컴퓨팅(HPC) 작업에만 적용하던 자율 복구 엔진을 쿠버네티스(Kubernetes)와 엔비디아 런:에이아이(Run:ai)로 관리하는 AI 작업까지 확장한 것이 핵심이다.1
대규모 AI 학습은 수백 개 노드와 수천 개 GPU를 묶어 며칠에서 몇 주 동안 진행한다. 이런 환경에서는 하드웨어 이상이나 소프트웨어 오류, 네트워크 시간 초과, 자원 경합 하나가 여러 노드에 걸친 작업 전체를 멈출 수 있다. 여러 학습 작업을 공유 인프라에서 동시에 운영한다면 사람이 개입하고 고정된 체크포인트에서 재시작하는 기존 방식은 확장하기 어렵다는 게 엔비디아의 설명이다.
미션 컨트롤 2.5의 자율 복구 엔진은 ‘자율 작업 복구’와 ‘자율 하드웨어 복구’라는 두 서비스로 구성된다. 엔비디아는 여기에 스케줄러를 결합해 세 계층의 제어 루프를 만들었다. 쿠버네티스 환경에서는 기본 스케줄러인 런:에이아이가 작업 대기열과 정책, 가용 자원을 관리하고 작업을 배치한다. 자율 작업 복구 서비스는 실행 위치와 장애 이력, 작업 토폴로지를 추적한 뒤 재시작·재시도·재대기·재배치 가운데 적절한 경로를 고른다. 자율 하드웨어 복구 서비스는 노드와 GPU 상태를 감시하고, 이상 자원을 스케줄링 대상에서 빼낸 뒤 진단이나 복구 절차를 실행한다.1
역할을 나눈 이유는 장애 원인 규명과 작업 재개를 분리하기 위해서다. 하드웨어 진단이 끝날 때까지 기다리지 않고 스케줄러가 정상 자원으로 작업을 옮길 수 있으며, 문제가 있는 GPU가 새 작업에 반복 투입되는 것도 막는다. 엔비디아가 말하는 ‘자가 치유’는 단일 재시작 기능이라기보다 탐지, 격리, 복구, 재배치를 잇는 운영 구조에 가깝다.
다만 엔비디아가 공개한 자료는 작동 구조를 설명하는 기술 블로그다. 장애 복구 시간이나 가동률이 기존 방식보다 얼마나 개선됐는지 보여주는 수치와 독립적인 운영 결과는 제시하지 않았다. 따라서 실제 효과는 클러스터 구성과 체크포인트 정책, 장애 유형이 다른 현장에서 추가로 확인해야 한다.
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- How NVIDIA Mission Control 2.5 Brings Autonomous Recovery to Kubernetes | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.