엔비디아, 분산 AI 학습 자동 복구 도구 공개
최근 30일 조회수 — 좋아요 —핵심 요약
장애 원인을 진단해 문제 자원을 격리하고 체크포인트부터 학습을 자동 재개한다.
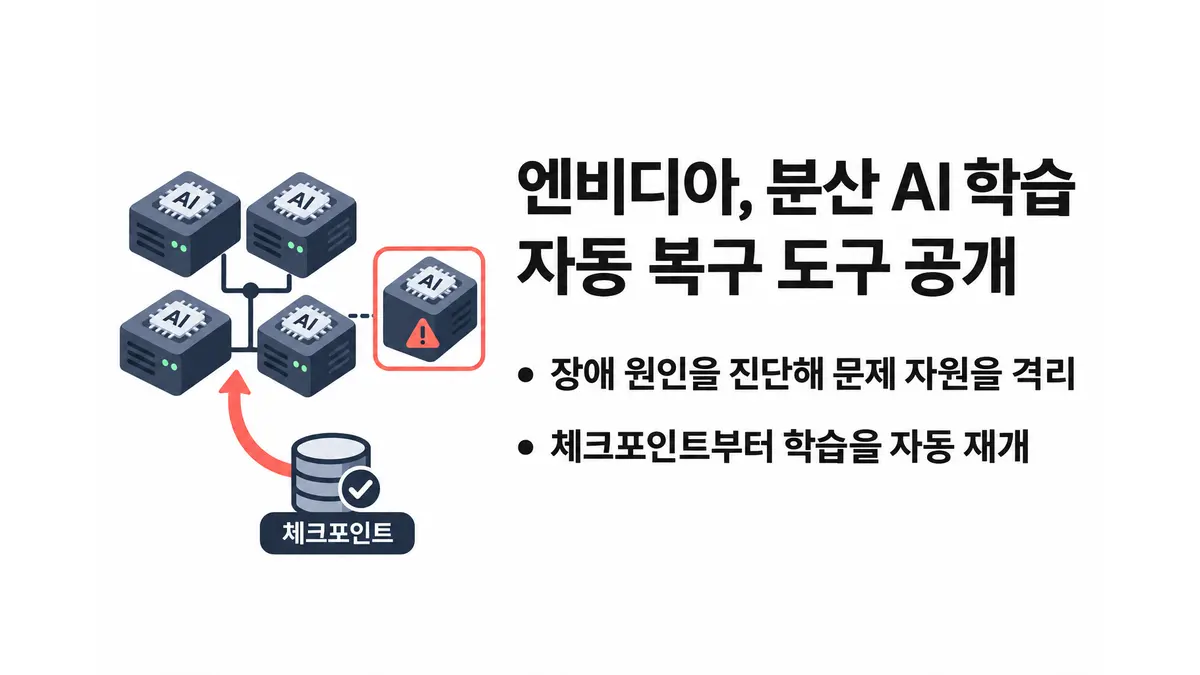
엔비디아가 분산 AI 학습의 장애 원인을 추적하고 작업을 자동으로 재시작하는 도구를 공개했다. 오픈소스 서비스 ‘엔비디아 리커버리(NVIDIA Recovery)’는 로그와 GPU 지표, 스케줄러 신호를 바탕으로 중단을 감지한 뒤 문제가 의심되는 자원을 격리하고, 정상 자원에서 체크포인트부터 학습을 재개한다. ‘엔비디아 어트리뷰션(NVIDIA Attribution)’은 이 과정에 필요한 원인 진단과 근거를 제공한다.12
분산 학습에서는 GPU 한 대의 고장이 여러 노드의 엔비디아 집단 통신 라이브러리(NCCL) 오류와 스케줄러 상태 변경, 대량의 후속 메시지로 번질 수 있다. 마지막에 보고된 예외가 최초 원인을 가리킨다는 보장도 없다. 엔비디아가 제시한 예에서는 한 GPU에서 하드웨어 오류인 XID 149가 발생한 뒤 다른 랭크에서 NCCL 오류가 이어졌다. 어트리뷰션은 이를 별개의 통신 장애로 처리하지 않고, XID를 근본 원인으로 판정하면서 NCCL 오류는 증상 사슬로 보존하고 책임 노드도 지정한다.2
진단은 작업 실행 단위로 이뤄진다. 블루프린트가 스케줄러 식별자나 실행 시간·할당 노드를 기준으로 범위를 정하고, 애플리케이션 로그와 시스템 로그, GPU 드라이버 및 패브릭 관리자 메시지, 노드·네트워크 지표를 모은다. 서비스는 결정론적 규칙으로 이벤트의 시점과 관계를 분석해 원인과 후속 증상을 구분한 뒤 작업 결과, 원인 영역, 영향받은 노드, 증상, 증거 기록을 구조화해 반환한다. REST API를 제공하므로 기존 상태 점검·복구 시스템과도 연결할 수 있다.2
리커버리는 이 진단을 실제 복구로 잇는 클러스터 단위 제어 계층이다. 슬럼(Slurm)의 자원 할당·대기열 관리, 노드 상태 감시와 격리, 작업 내부 복구 라이브러리 NVRx 사이에서 재시작 위치와 제외할 노드를 조율한다. 엔비디아는 수동 복구 때마다 로그 분석과 장애 격리, 체크포인트 재시작이 필요하고 그동안 GPU가 유휴 상태에 놓인다고 설명했다. 여러 작업의 장애가 겹치는 대규모 환경에서는 복구 지연이 GPU 사용 시간과 전체 학습 기간을 함께 늘리므로, 개별 고장 처리보다 클러스터 전체의 ‘굿풋(goodput)’, 즉 실제 학습 진척에 쓰인 시간을 유지하는 일이 중요해진다.1
다만 공개 자료는 엔비디아 인프라에서 어트리뷰션이 매주 수백만 개 작업과 수십만 개 GPU를 분석한다고 밝힐 뿐, 자동 복구 도입 전후의 복구 시간이나 성공률, 비용 절감 폭은 제시하지 않았다.2
Footnotes
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Keep Distributed Training Running with Automated Workload Recovery | NVIDIA Technical Blog — NVIDIA Technical Blog
- Diagnose Distributed AI Workload Failures with NVIDIA Attribution | NVIDIA Technical Blog — NVIDIA Technical Blog
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요.